
Node.js / 系统课时
部署与故障排查
部署与故障排查
本课把 Node.js 服务从“本机能启动”推进到“生产进程可被托管和诊断”。最终会配置环境变量、systemd 进程守护、存活与就绪检查、优雅退出,并用固定顺序定位启动失败、端口占用、依赖缺失和数据库连接异常。
学习目标
- 用生产环境变量、健康检查和优雅退出构造可部署的服务入口。
- 使用 systemd 守护 Node.js 进程,并验证重启与启动状态。
- 按日志、端口、依赖、数据库四个层级缩小故障范围。
先让应用暴露可观测状态
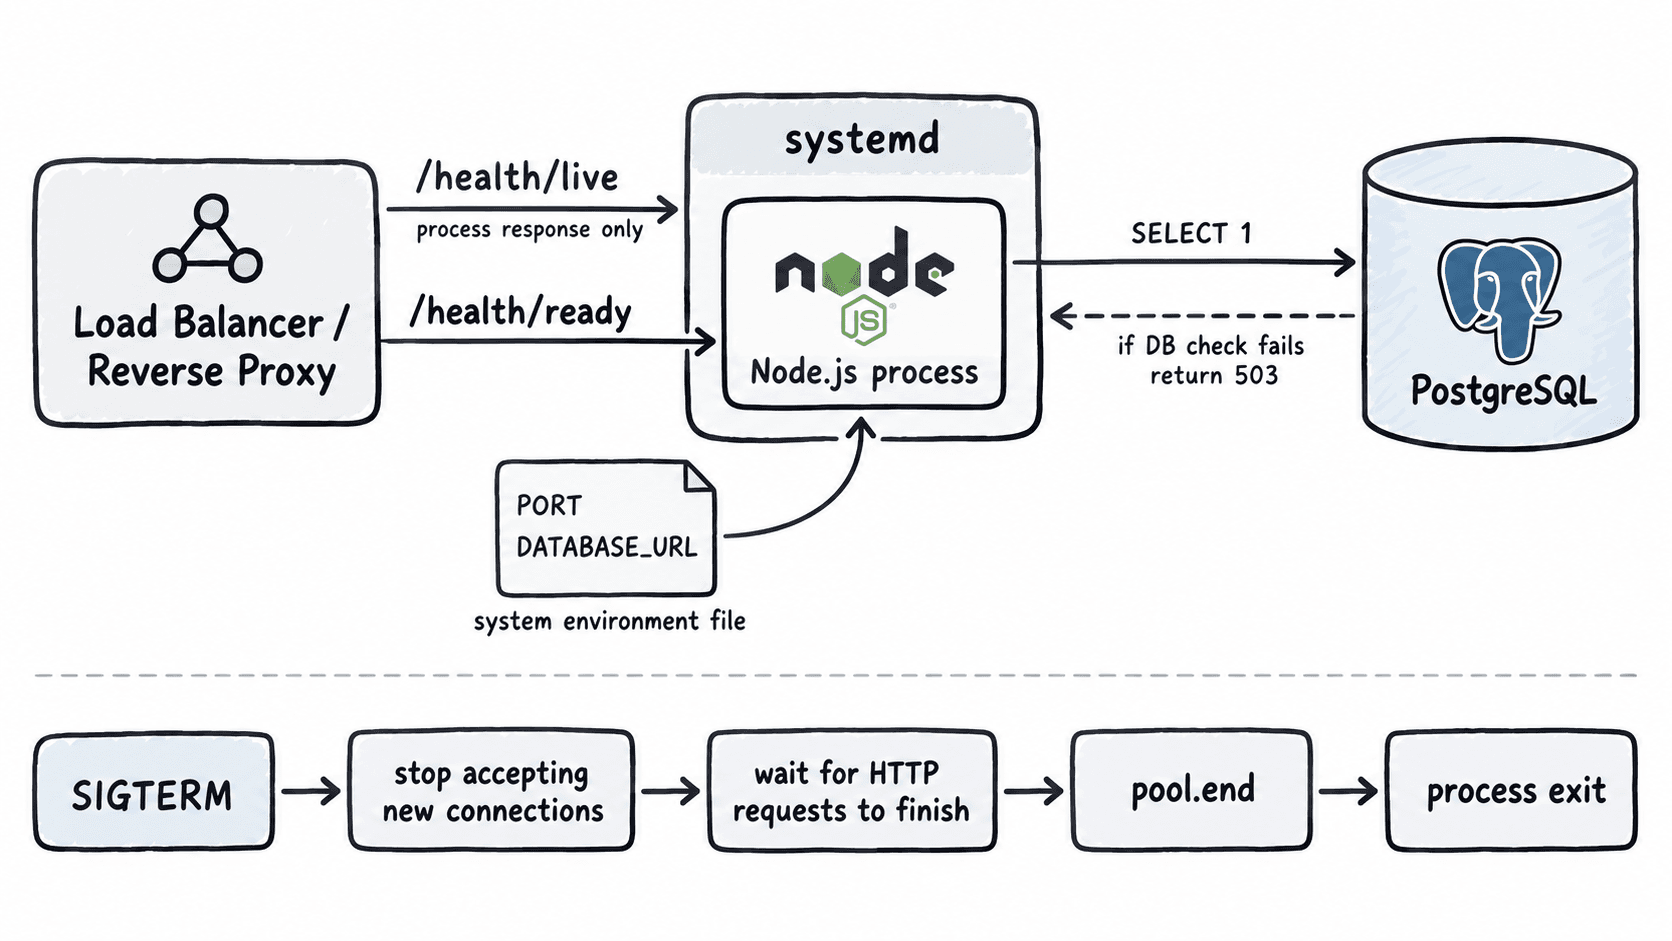
生产环境至少区分“进程活着”和“已经能接流量”。/health/live 只检查事件循环是否还能响应;/health/ready 再检查 PostgreSQL。数据库不可用时返回 503,负载均衡器就能暂时摘除实例,而不是把数据库故障伪装成普通 200。
先安装生产依赖并验证模块能被加载;该命令要求仓库已经有与 package.json 匹配的 package-lock.json。
npm ci --omit=dev >/dev/null && node -e "require('express'); require('pg'); console.log('deps ok')"预期输出:
deps ok下面的 server.js 以 Express 和 pg 为例。connectionTimeoutMillis 设为 3000 ms,避免数据库地址错误时就绪检查长时间悬挂;max: 10 是单实例连接池上限,实例数增加时要重新核算数据库总连接数。
const express = require('express');
const { Pool } = require('pg');

const port = Number(process.env.PORT || 3000);
const databaseUrl = process.env.DATABASE_URL;

if (!databaseUrl) {
  throw new Error('DATABASE_URL is required');
}

const pool = new Pool({
  connectionString: databaseUrl,
  connectionTimeoutMillis: 3000,
  max: 10
});

const app = express();

app.get('/health/live', (req, res) => {
  res.json({ status: 'alive' });
});

app.get('/health/ready', async (req, res) => {
  try {
    await pool.query('SELECT 1');
    res.json({ status: 'ready' });
  } catch (error) {
    res.status(503).json({ status: 'not_ready' });
  }
});

const server = app.listen(port, '0.0.0.0', () => {
  console.log(`listening on ${port}`);
});

async function shutdown(signal) {
  console.log(`${signal} received`);
  server.close(async () => {
    await pool.end();
    process.exit(0);
  });

  setTimeout(() => {
    console.error('forced shutdown after 10s');
    process.exit(1);
  }, 10_000).unref();
}

process.on('SIGTERM', () => shutdown('SIGTERM'));
process.on('SIGINT', () => shutdown('SIGINT'));
提供一个可访问的 PostgreSQL 连接串后运行应用:
PORT=3000 DATABASE_URL='postgresql://app:<PASSWORD>@127.0.0.1:5432/appdb' node server.js预期输出:
listening on <PORT>本例中 <PORT> 为 3000。服务启动本身不会证明数据库可用,数据库状态要通过 /health/ready 单独验证。
用环境文件与 systemd 启动
以下做法适用于使用 systemd 的 Linux 主机。把真实密钥放在 /etc/node-api/node-api.env,并限制该文件只允许服务账号和管理员读取;不要把它放进 Git 仓库。
PORT=3000
DATABASE_URL=postgresql://app:<PASSWORD>@127.0.0.1:5432/appdb
NODE_ENV=production
创建 /etc/systemd/system/node-api.service。ExecStart 中的 Node 路径应以服务器上 command -v node 的结果为准;使用 nvm 时尤其不要假设 /usr/bin/node 一定存在。
[Unit]
Description=Node API
After=network.target

[Service]
Type=simple
User=nodeapp
WorkingDirectory=/opt/node-api
EnvironmentFile=/etc/node-api/node-api.env
ExecStart=/usr/bin/node /opt/node-api/server.js
Restart=on-failure
RestartSec=3
TimeoutStopSec=15
KillSignal=SIGTERM

[Install]
WantedBy=multi-user.target
重新加载配置、启动服务并立刻检查状态:
sudo systemctl daemon-reload && sudo systemctl enable --now node-api >/dev/null 2>&1 && systemctl is-active node-api预期输出:
active如果输出不是 active,不要继续改 Nginx 或负载均衡器,先在本机把进程启动问题解决。
验证健康检查与关闭行为
数据库可连接时,就绪接口应返回 200。下面的命令同时打印响应体和 HTTP 状态码,便于在部署脚本里做自动判定。
curl -sS -o - -w '\nHTTP %{http_code}\n' http://127.0.0.1:3000/health/ready预期输出:
{"status":"ready"}
HTTP 200
如果数据库暂时不可达,预期响应应变为 {"status":"not_ready"} 和 503,但 /health/live 仍应保持 200。这样可以区分“进程已经死掉”和“进程活着但暂时无法承接业务”两类故障。
发布或缩容时,systemd 会发送 SIGTERM。本例先让 HTTP Server 停止接收新连接,再执行 pool.end() 释放数据库连接;10 秒仍未完成才强制退出。TimeoutStopSec=15 比应用内部 10 秒保险丝更长,避免 systemd 先一步强杀进程。
按固定顺序定位四类故障
故障排查最容易浪费时间的做法,是一看到 502 就同时改端口、依赖和数据库。先从最靠近进程的证据开始,每一步都要有“正常判据”。
| 现象 | 第一检查点 | 可直接执行的检查 | 正常或异常判据 |
|---|---|---|---|
| 服务启动后立刻退出 | 进程日志 | journalctl -u node-api -n 100 --no-pager |
常见异常是缺少 DATABASE_URL、语法错误或权限错误 |
报 EADDRINUSE |
监听端口 | `ss -ltnp | grep ':3000'` |
报 MODULE_NOT_FOUND |
依赖与工作目录 | npm ls --depth=0 |
依赖缺失、版本冲突或在错误目录启动都会直接暴露 |
/health/ready 为 503 |
数据库连通性 | psql "$DATABASE_URL" -c 'SELECT 1;' |
成功应返回一行值 1;失败信息通常能区分认证、DNS、端口和权限问题 |
当 systemd 显示 active 但外部仍访问不到时,再检查主机防火墙、反向代理上游地址和云安全组。若本机 curl 127.0.0.1:3000/health/live 都失败,问题仍在应用或本机监听层,继续改外部网络配置只会把故障范围变大。
把部署验收写成硬条件
一次可交付部署至少要同时满足:systemctl is-active node-api 为 active;/health/live 返回 200;数据库正常时 /health/ready 返回 200;数据库断开时 /health/ready 返回 503;发送 SIGTERM 后日志出现关闭信号且连接池被释放;重启机器后服务能自动拉起。
数据库连接池也要按总量计算。若每个实例 max=10、部署 8 个实例,理论上最多需要 80 条应用连接,还要给迁移任务和管理员连接留余量。只有把进程状态、健康检查和依赖连通性拆开验证,部署故障才能快速定位到具体层,而不是靠反复重启碰运气。