
Node.js / 系统课时
使用流处理大文件
使用流处理大文件
当文件达到数百 MB 甚至数 GB 时,readFile() 会把内容整体放进内存,容易造成 RSS 激增。这里用 Node.js 流和 pipeline() 完成边读边写,并用可测的缓冲区与内存指标验证结果。
学习目标
- 区分一次性读文件与流式处理的内存行为
- 使用
createReadStream()、createWriteStream()和pipeline()复制大文件 - 用
highWaterMark与 RSS 采样检查吞吐和内存占用
为什么流能控制内存
假设要复制一个 2 GB 日志文件,readFile() 需要等待整个文件读完后才得到完整 Buffer;流则把文件拆成连续数据块,让读取端、写入端同时推进。示例中把读写两端的 highWaterMark 都显式设为 256 KiB,避免依赖不同 Node.js 版本的默认值。
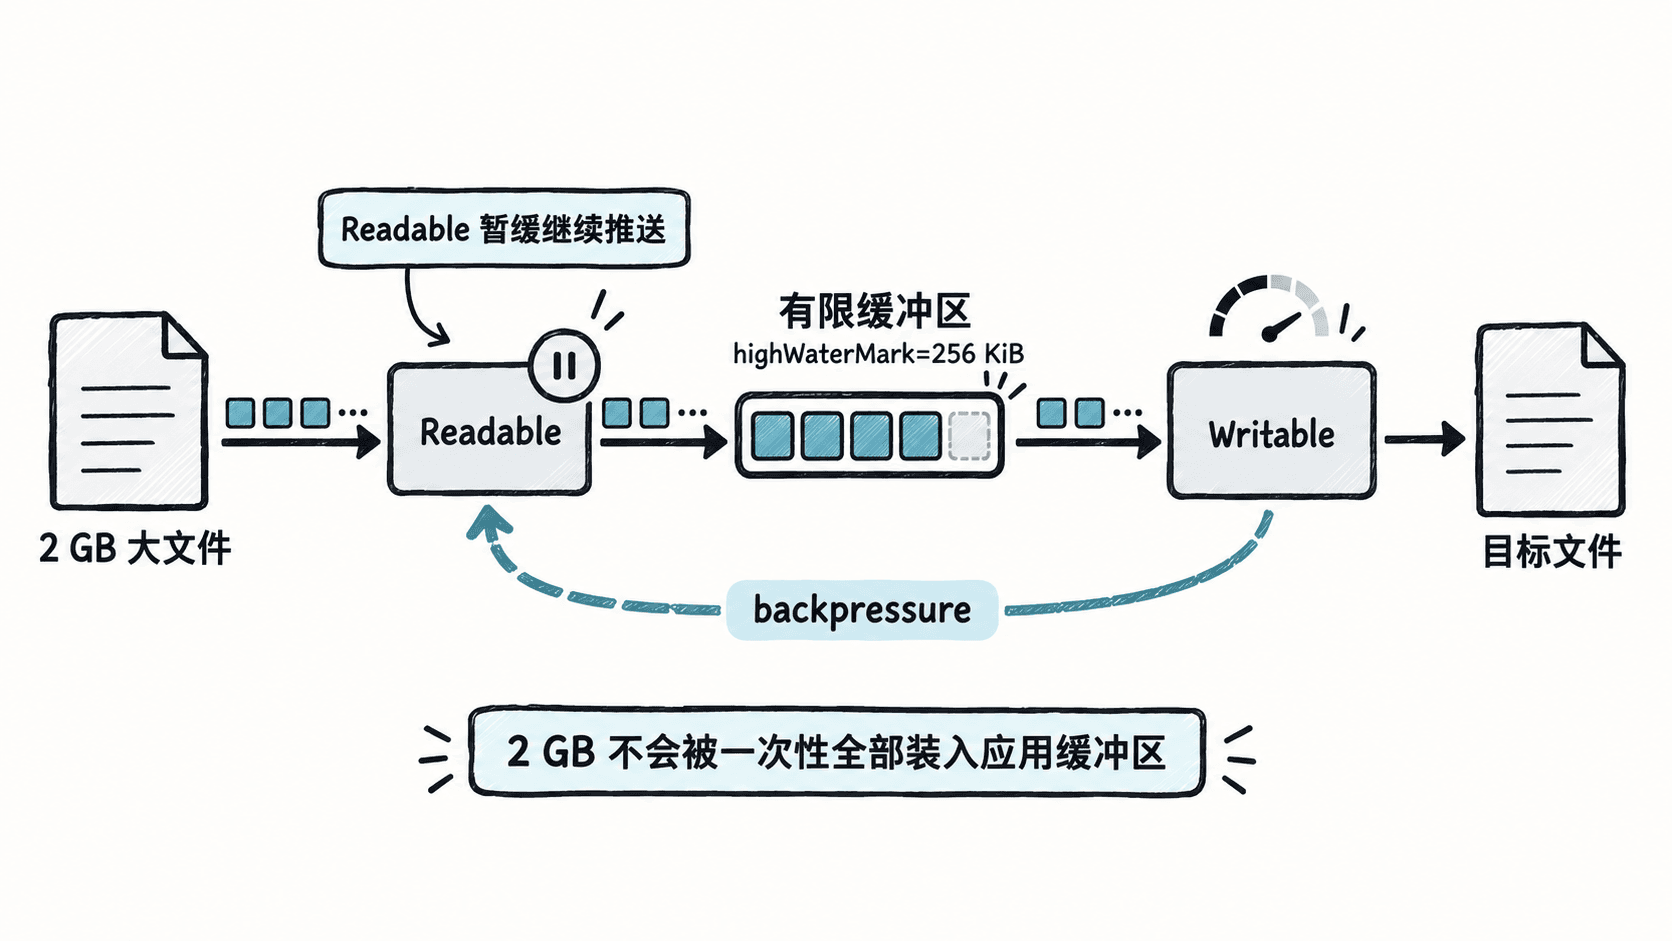
highWaterMark 是流内部开始限制继续缓冲的阈值,不等于进程总内存上限。进程仍会占用 V8 堆、原生缓冲区和系统资源,但数据量增长到 2 GB 时,不应出现“应用必须同时持有 2 GB 文件内容”的线性关系。
用 pipeline 完成大文件复制
下面示例适用于支持 node:stream/promises 的 Node.js 16+。保存为 copy-large.mjs,它会复制文件、每 50 ms 采样一次 RSS,并在结束时输出目标文件大小和采样峰值。
import { createReadStream, createWriteStream } from 'node:fs';
import { stat } from 'node:fs/promises';
import { pipeline } from 'node:stream/promises';

async function main() {
  const [source, destination] = process.argv.slice(2);

  if (!source || !destination) {
    console.error('用法: node copy-large.mjs <source> <destination>');
    process.exitCode = 1;
    return;
  }

  // 每 50 ms 采样一次 RSS;这是近似峰值,不是操作系统级精确峰值。
  let peakRss = process.memoryUsage().rss;
  const sampler = setInterval(() => {
    peakRss = Math.max(peakRss, process.memoryUsage().rss);
  }, 50);

  try {
    // pipeline 负责传递背压,并把任一阶段的错误汇总为 Promise 拒绝。
    await pipeline(
      createReadStream(source, { highWaterMark: 256 * 1024 }),
      createWriteStream(destination, { highWaterMark: 256 * 1024 })
    );

    // 完成后再读取目标文件大小,避免把“流结束”误判为“写入已完成”。
    const { size } = await stat(destination);
    console.log(`复制完成: ${size} bytes`);
    console.log(`采样峰值 RSS: ${(peakRss / 1024 / 1024).toFixed(1)} MB`);
  } catch (error) {
    console.error(`复制失败: ${error.code ?? error.message}`);
    process.exitCode = 1;
  } finally {
    clearInterval(sampler);
  }
}

main();
运行时把 <PATH> 替换为实际目录。最好选一个 1~5 GB 的真实日志或测试文件,这样更容易观察整体读取与流式读取的差异。
node copy-large.mjs "<PATH>/big.log" "<PATH>/big-copy.log"预期输出
复制完成: <BYTES> bytes
采样峰值 RSS: <MB> MB
<BYTES> 应与源文件大小一致,<MB> 会随操作系统、Node.js 版本和并发负载变化。pipeline() 会等待整条管线完成,并把读取或写入错误作为 Promise 拒绝传出,比手工拼接 data、write、drain 和 error 更不容易漏掉边界。
调整块大小并验证效果
不要把 highWaterMark 直接调得越大越好。可以在同一台机器、同一个 2 GB 文件上分别测试 64 KiB、256 KiB、1 MiB,每档连续运行 3 次,记录完成时间和“采样峰值 RSS”,再取中位数比较。
highWaterMark |
适合先验证的场景 | 重点观察 |
|---|---|---|
| 64 KiB | 内存更紧张、普通顺序 I/O | RSS 是否更低,耗时是否可接受 |
| 256 KiB | 本地大文件复制的起始测试值 | 吞吐与内存是否都稳定 |
| 1 MiB | 高吞吐磁盘或网络文件系统实验 | 吞吐是否真的提升,RSS 是否明显增加 |
如果 256 KiB 与 1 MiB 的耗时只差 1%~2%,却让 RSS 明显上升,就保留较小值。性能判断应来自同机实测,而不是把块大小当作固定“最佳参数”。
避免破坏背压
常见错误是在 readable.on('data') 中直接调用异步写入,却忽略 writable.write() 返回的 false 和 drain 事件。这样读取端可能持续生产数据,待写缓冲不断积累,最后又回到高内存占用。
单纯复制、压缩、加密或格式转换时,优先使用 pipeline() 串接 Readable、Transform 和 Writable。只有确实需要自定义调度时才手工控制 pause()、resume() 或 drain,并把错误传播和资源关闭一起处理。