
Node.js / 系统课时
认识可写流
认识可写流
可写流负责把数据按顺序送到文件、网络连接或其他目标。它看起来只是连续调用 write(),但真正要掌握的是内部缓冲、背压、end() 与 finish 的关系;否则数据量一大,就可能出现内存持续增长或过早退出。
学习目标
- 能正确调用
write()、end()并监听finish。 - 能根据
write()的布尔返回值处理背压和drain。 - 能区分“写入流程完成”和“数据已经持久化到磁盘”。
write 返回值决定要不要继续塞数据
writable.write(chunk) 会把数据交给可写流,并返回布尔值。返回 true 表示内部缓冲还低于阈值,可以继续写;返回 false 表示缓冲已达到或超过 highWaterMark,此时应暂停上游,等待 drain 后再继续。
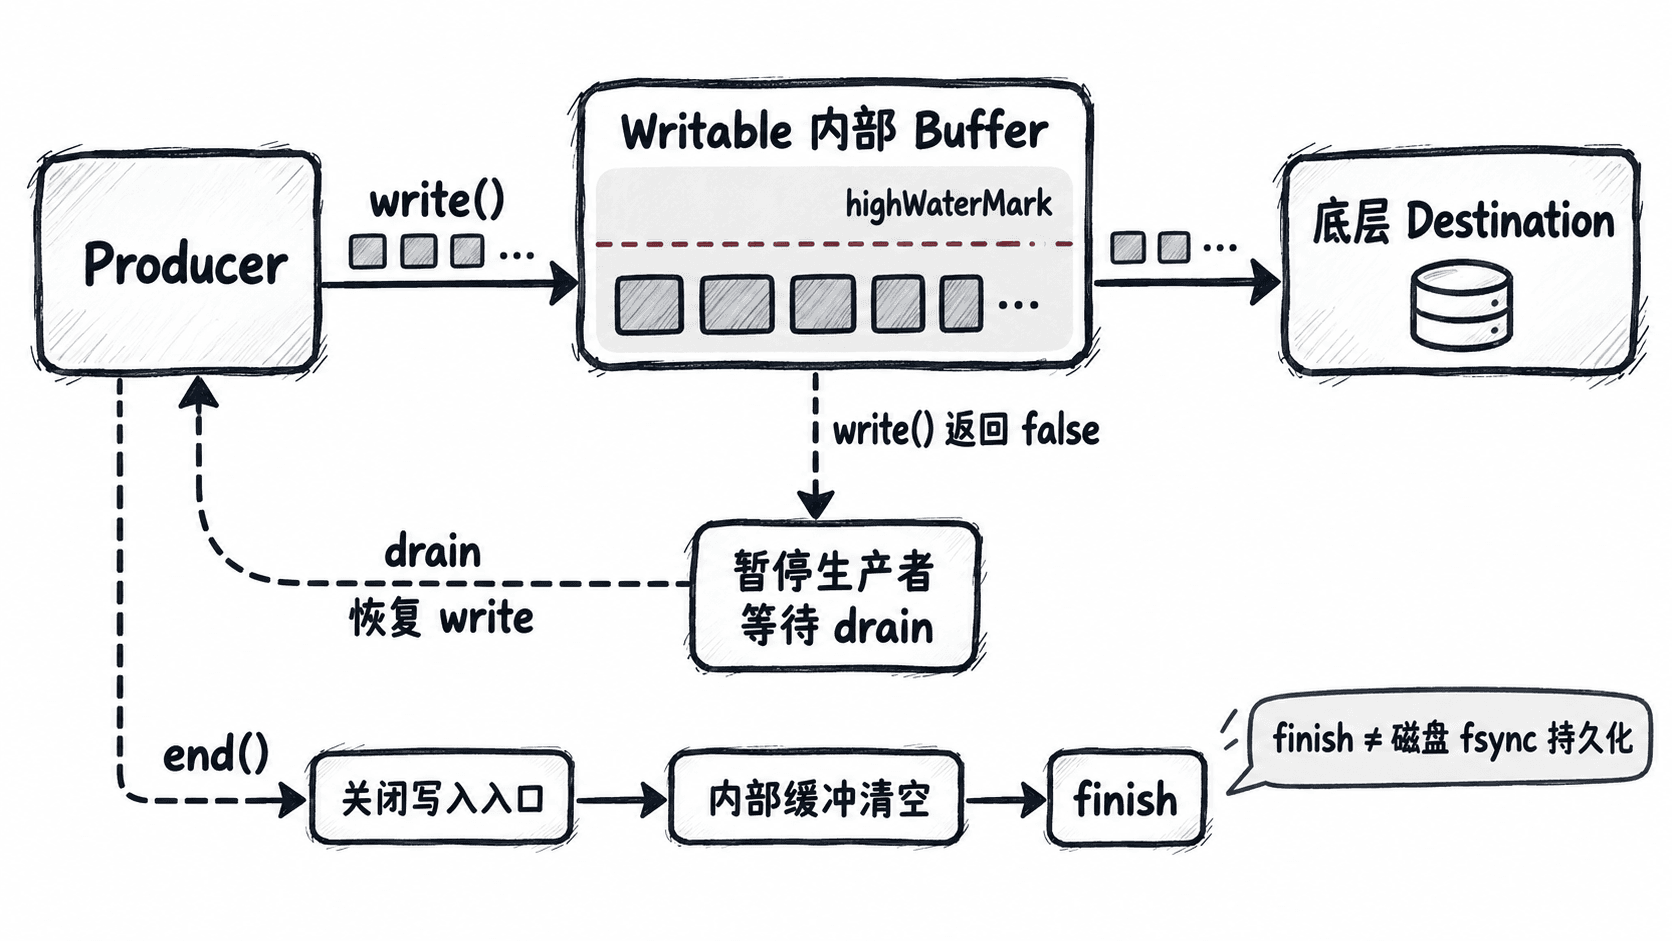
highWaterMark 是背压阈值,不是“最大可写容量”。即使 write() 返回 false,当前 chunk 仍已被 Node.js 接收并排队;错误做法是继续无上限调用 write(),正确做法是把 false 当作暂停信号。
用一个小缓冲观察 drain
下面示例把 highWaterMark 设为 8 字节,并故意让底层写入延迟 20 ms。第一次写入 4 字节仍低于阈值;第二次累计到 8 字节,write() 返回 false,程序等待 drain 后再调用 end()。
const { Writable } = require('node:stream');
const { once } = require('node:events');

const sink = new Writable({
  highWaterMark: 8,
  write(chunk, _encoding, callback) {
    setTimeout(() => {
      console.log(`written:${chunk.toString()}`);
      callback();
    }, 20);
  }
});

async function main() {
  sink.on('finish', () => {
    console.log('finish');
  });

  console.log('write1', sink.write('1234'));

  const canContinue = sink.write('5678');
  console.log('write2', canContinue);

  if (!canContinue) {
    await once(sink, 'drain');
    console.log('drain');
  }

  sink.end('END');
}

main().catch(console.error);
预期输出
write1 true
write2 false
written:1234
written:5678
drain
written:END
finish这里的顺序很关键:false 不是写入失败;它只是告诉生产者“先别继续”。当缓冲降下来时触发 drain,再恢复生产即可。真实文件复制和网络转发通常直接用 pipeline(),它会替你协调上下游背压。
end 与 finish 分别表示什么
end([chunk]) 表示“不会再写新数据”,它可以顺便提交最后一块数据。调用后再执行 write() 属于错误用法,可能触发 ERR_STREAM_WRITE_AFTER_END。finish 则在 end() 已调用且所有数据都交给底层写入逻辑后触发。
| 动作或事件 | 含义 | 后续能否继续 write() |
|---|---|---|
write(chunk) |
提交一块数据 | 可以,除非已经 end() |
end(chunk) |
提交可选最后一块并关闭写入口 | 不可以 |
drain |
内部缓冲下降,可恢复生产 | 可以 |
finish |
可写流已处理完全部待写数据 | 不可以 |
对文件流来说,finish 不等于数据已经通过 fsync 强制落到物理介质。多数业务只需要知道 Node.js 已完成写入流程;如果场景要求崩溃后仍保证持久化,则还需要显式的文件同步策略。
完成状态要和错误状态一起监听
finish 只代表正常完成路径。真实项目还要处理 error,否则磁盘写满、权限不足、连接断开等情况会被误判成正常结束。对于由多个流组成的链路,优先使用 stream.pipeline(),它会统一处理错误传播和资源关闭。
验收一个可写流时,至少检查:发生背压时生产者会停、end() 后不会再写、正常路径只触发一次 finish、错误路径能被捕获。满足这四点后,写入逻辑才适合进入持续数据量更大的场景。