
Node.js / 系统课时
理解背压机制
理解背压机制
背压解决的是“上游生产得比下游消费快”时的内存失控问题。Node.js 不要求生产者永远和消费者同速,而是让 Writable 在缓冲达到阈值后明确发出“先停一下”的信号;正确代码必须尊重 write() 的返回值,并在 drain 后再继续写。
学习目标
- 能解释
highWaterMark、write()返回值和drain之间的关系。 - 能在手动写入 Writable 时正确暂停与恢复生产。
- 能用
writableLength等指标判断背压是否持续发生。
背压发生在生产者和目标之间
Writable 会暂存尚未处理完的数据。每次调用 write(chunk) 后,如果内部缓冲仍低于 highWaterMark,通常返回 true;达到或超过该阈值时返回 false,表示生产者应暂停。等缓冲被下游消化到可以继续写时,Writable 会发出 drain。
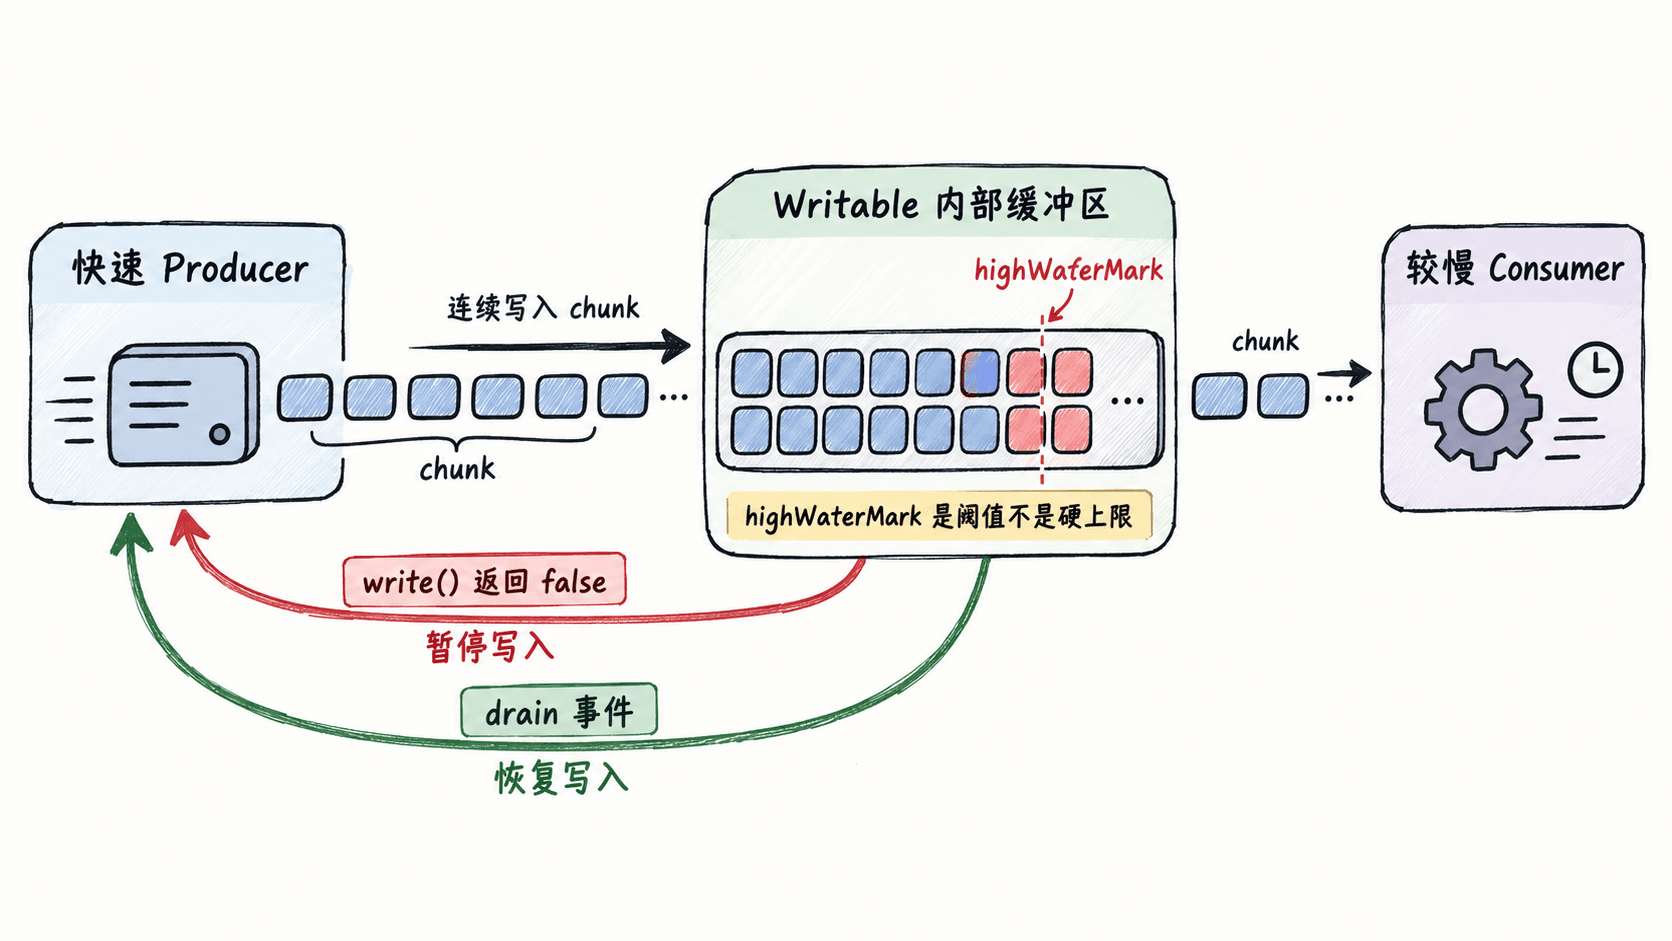
highWaterMark 是触发流量控制的阈值,不是绝对内存上限。字节流按字节计量,对象模式按对象数量计量。为了让实验结果稳定,下面不依赖不同 Node.js 版本或流类型的默认值,而是显式把阈值设为 16 字节。
手动写入时按 write 的返回值停下来
下面创建一个故意每 50 毫秒才完成一次写入的 Writable。每个字符串 chunk-1\n 到 chunk-6\n 都是 8 字节;highWaterMark 为 16,因此连续写入两块后就会触发背压。代码在 write() 返回 false 时等待一次 drain,再继续生产。
const { Writable } = require('node:stream');
const { once } = require('node:events');

async function main() {
  const sink = new Writable({
    highWaterMark: 16,
    write(chunk, encoding, callback) {
      // 模拟下游处理较慢:每个 chunk 50 ms 后才算写完。
      setTimeout(callback, 50);
    },
  });

  for (let i = 1; i <= 6; i += 1) {
    const ok = sink.write(`chunk-${i}\n`);
    console.log(`write ${i}: ${ok}`);

    if (!ok) {
      console.log('wait drain');
      await once(sink, 'drain');
      console.log('drain');
    }
  }

  const finished = once(sink, 'finish');
  sink.end();
  await finished;
  console.log('finish');
}

main().catch((error) => {
  console.error(error);
  process.exitCode = 1;
});
预期输出
write 1: true
write 2: false
wait drain
drain
write 3: true
write 4: false
wait drain
drain
write 5: true
write 6: false
wait drain
drain
finish
关键规则只有一条:一旦 write() 返回 false,就不要继续无条件调用 write()。继续塞数据虽然可能暂时“能跑”,但会让待写数据继续堆在内存里,增加 RSS 和垃圾回收压力,严重时可能耗尽进程可用内存。
pipe 和 pipeline 会自动传递背压
如果数据可以表达成 Readable,优先把生产逻辑封装成流,再用 pipe() 或 pipeline() 连接下游。它们会根据 Writable 的可写状态调节上游读取速度,通常不需要业务代码自己监听 drain。手动循环写入只在你主动调用 writable.write() 时才需要自行遵守背压信号。
判断时可以用一个简单标准:数据源已经是文件流、网络流、压缩流或自定义 Readable,就让流系统管理节奏;数据由 for 循环、队列消费者或批处理代码主动产生,并直接调用 write(),就必须检查布尔返回值。
用三个属性定位持续背压
排查“吞吐下降但 CPU 不高”时,可观察 writableLength、writableHighWaterMark 和 writableNeedDrain。例如显式设置 highWaterMark: 64 * 1024 后,如果 writableLength 长时间接近或超过 65536,且 writableNeedDrain 经常为 true,说明目标端处理速度持续跟不上生产端。
不要只靠增大 highWaterMark 掩盖问题。可以在同一数据集上分别测试 16 KiB、64 KiB、256 KiB,记录总耗时与进程 RSS;如果更大的阈值几乎不提升吞吐却明显增加内存,就应保留较小值,并继续检查磁盘、网络或下游服务的实际处理速度。