
Node.js / 系统课时
解决回调嵌套
解决回调嵌套
当一个异步操作依赖上一个操作的结果时,直接把回调不断写进回调会迅速增加缩进和错误分支。本课保留回调模型,不改成 Promise,通过拆分命名函数把三段异步流程压平,并保留每一步的错误传播。
学习目标
- 识别多层匿名回调造成的结构问题
- 把异步步骤拆成职责单一的命名函数
- 保证拆分后错误仍能传到统一结束位置
先识别嵌套真正难在哪里
假设流程依次是“读取用户 → 查询订单 → 保存汇总”。如果三个调用全部写成匿名回调,主流程会形成三层以上缩进,而且每一层都要重复错误判断。步骤增加到五六个后,修改中间一步很容易碰到外层变量或漏掉错误返回。
getUser(42, (error, user) => {
  if (error) return done(error);

  getOrders(user.id, (error, orders) => {
    if (error) return done(error);

    saveSummary({ user, orders }, (error, result) => {
      if (error) return done(error);
      done(null, result);
    });
  });
});这是片段示例,依赖已经存在的 getUser、getOrders、saveSummary 和 done。问题不在回调本身,而在流程控制、数据加工和错误处理全部堆在同一层匿名函数中。
按异步步骤拆成命名函数
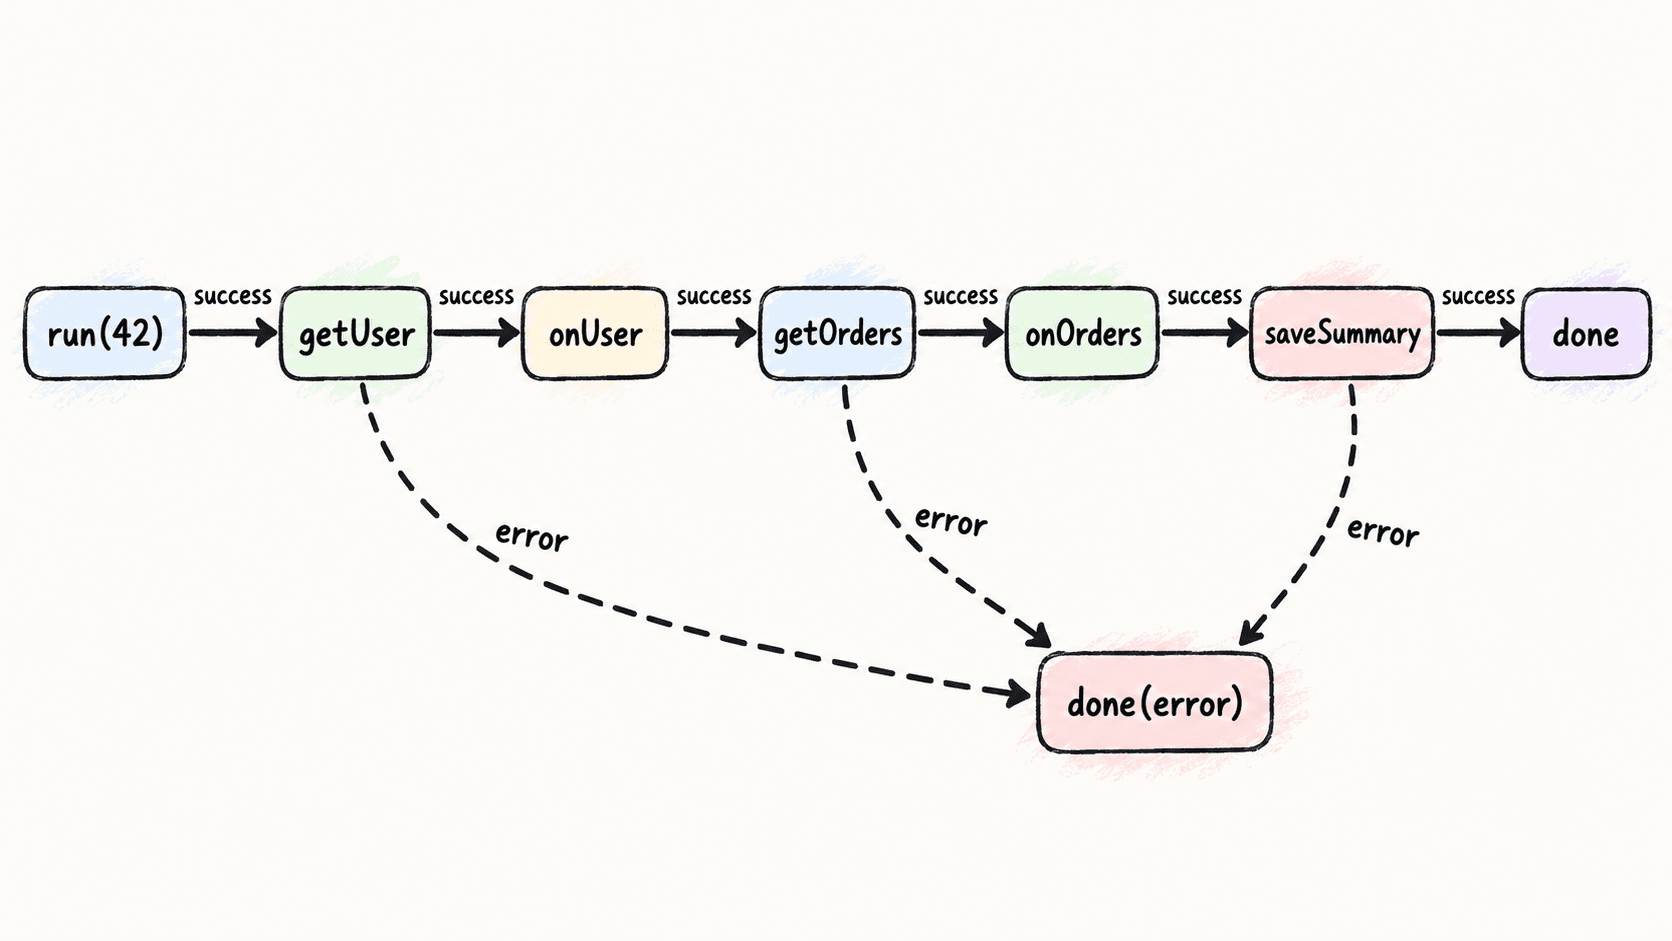
拆分时让每个函数只负责一个阶段:拿到输入、处理当前错误、启动下一步。下面是完整可运行示例,三个异步操作用 setTimeout() 模拟 I/O 延迟,流程数据与错误仍遵守 Node 风格回调约定。
function getUser(userId, callback) {
  setTimeout(() => {
    if (userId !== 42) {
      return callback(new Error('用户不存在'));
    }

    callback(null, { id: 42, name: 'Ada' });
  }, 50);
}

function getOrders(userId, callback) {
  setTimeout(() => {
    const orders = [
      { id: 'A100', total: 89 },
      { id: 'A101', total: 129 }
    ];
    callback(null, orders);
  }, 50);
}

function saveSummary(summary, callback) {
  setTimeout(() => {
    callback(null, { saved: true, summary });
  }, 50);
}

function run(userId, done) {
  getUser(userId, (error, user) => onUser(error, user, done));
}

function onUser(error, user, done) {
  if (error) return done(error);

  getOrders(user.id, (orderError, orders) => {
    onOrders(orderError, user, orders, done);
  });
}

function onOrders(error, user, orders, done) {
  if (error) return done(error);

  const total = orders.reduce((sum, order) => sum + order.total, 0);
  const summary = {
    user: user.name,
    count: orders.length,
    total
  };

  saveSummary(summary, done);
}

run(42, (error, result) => {
  if (error) {
    console.error(`失败: ${error.message}`);
    return;
  }

  console.log(JSON.stringify(result));
});
预期输出:
{"saved":true,"summary":{"user":"Ada","count":2,"total":218}}这里仍然使用回调,但顶层 run() 只启动第一步;用户处理与订单处理分别进入 onUser()、onOrders()。当业务计算变化时,例如订单总额改为只统计已支付订单,只需要修改 onOrders(),不必进入三层嵌套查找对应位置。
保持错误只沿一条路径返回
函数拆开以后,最容易出现的新问题是某一步报错后仍然启动下一步。规则可以固定为:每个阶段先判断错误,失败立即 return done(error);只有成功数据通过检查后才调用下一异步函数。
把示例最后的 run(42, ...) 改成 run(7, ...),即可验证第一阶段失败时后续步骤不会执行。
run(7, (error, result) => {
  if (error) {
    console.error(`失败: ${error.message}`);
    return;
  }

  console.log(JSON.stringify(result));
});这是片段示例,需要替换完整示例末尾原有的 run(42, ...) 调用,前面的函数定义保持不变。
预期输出:
失败: 用户不存在因为 onUser() 在收到错误后立即返回,getOrders() 和 saveSummary() 都不会被调用。这比在多个层级分别打印错误更容易测试,也避免出现“已经失败却继续写数据”的副作用。
判断何时函数拆分已经不够
命名函数适合三四个线性异步步骤,尤其是维护旧式 Node.js 回调 API 时。如果流程出现并行任务、循环等待、条件分支或六七个连续阶段,继续增加 onXxx 函数会让参数传递开始膨胀,此时通常应考虑 Promise 与 async/await。
可以用两个可检查的信号判断是否该升级结构:第一,一个阶段为了继续执行需要手工向下传递三个以上中间变量;第二,同一个 done 错误出口在五个以上函数中重复出现。函数拆分先解决缩进和职责混杂,复杂流程再交给更适合组合异步操作的机制。