
Node.js / 系统课时
认识可读流
认识可读流
可读流把“大块数据一次性读入内存”改成“数据到一部分就消费一部分”。这一课用 Node.js 内置 Readable 演示分块到达、data 与 end 事件,并说明 flowing、paused 两种消费方式怎样选择。
学习目标
- 能说清可读流的内部缓冲区、数据块与消费者之间的关系。
- 能用
data、end事件按块读取数据并验证块内容。 - 能判断什么时候使用
data、readable或异步迭代,避免混用读取模式。
数据为什么会被分成块
可读流不会承诺“一次事件就是一个完整文件或一整行”。网络、文件系统和上游流会把数据分批推入内部缓冲区,消费者再按当前读取方式取走。highWaterMark 只是缓冲阈值,不是固定分块尺寸;默认值还会随流类型和 Node.js 版本而不同,因此业务代码不能依赖某个固定块大小。
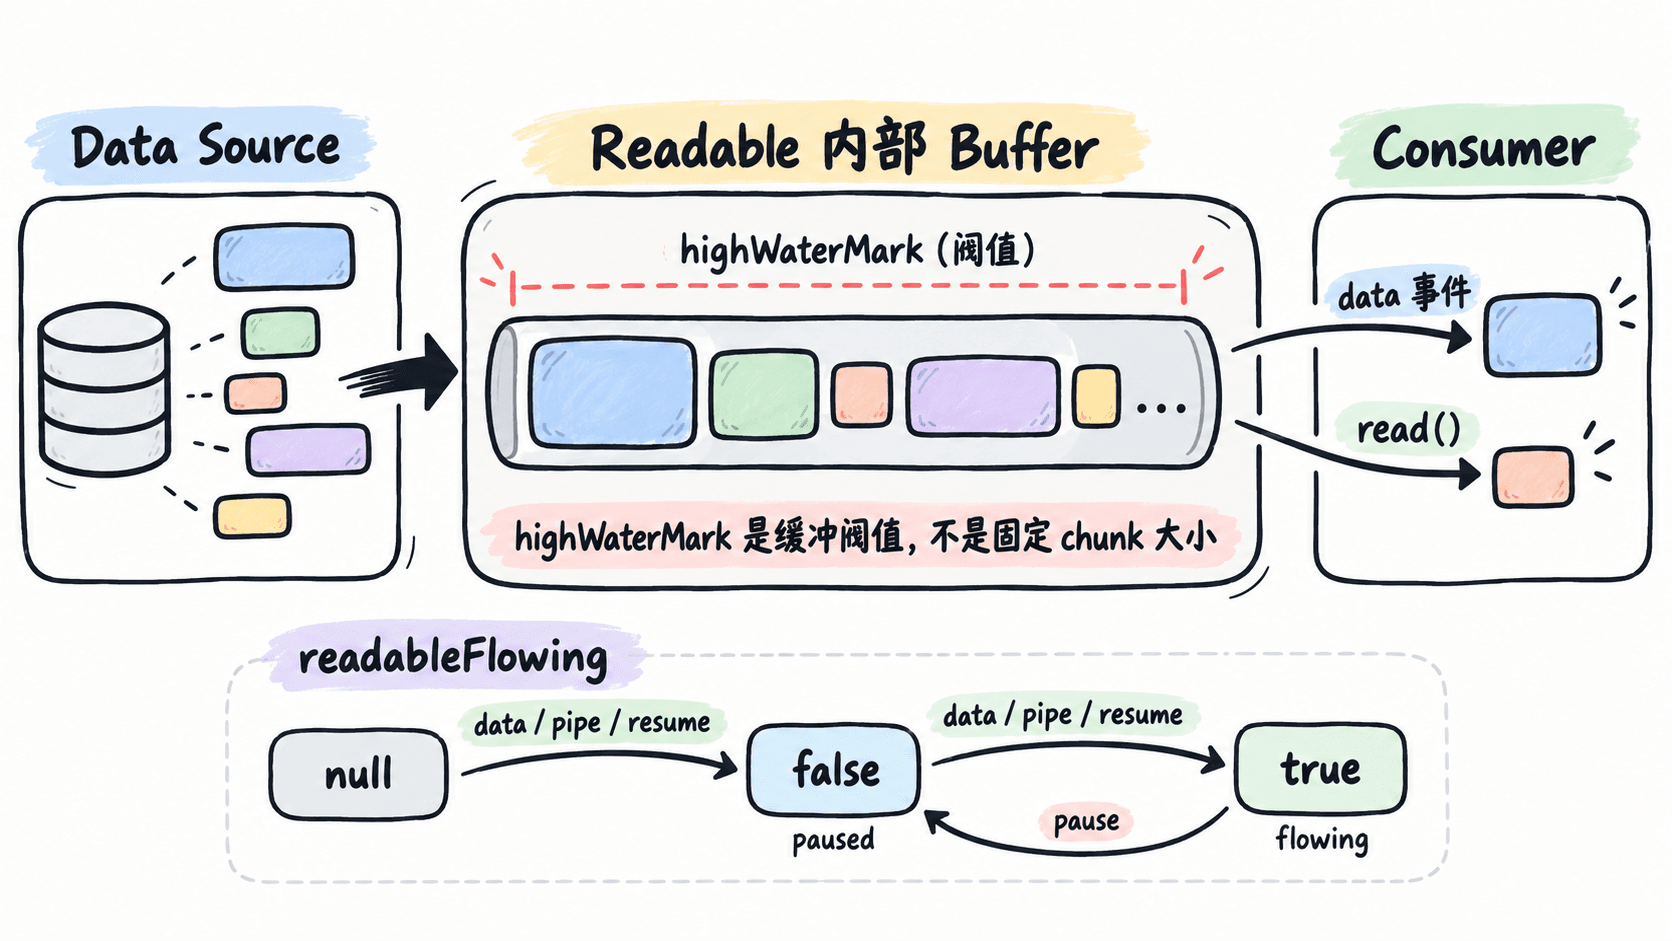
例如读取一个 200 MB 文件时,流可以让程序边读边处理,而不是先申请约 200 MB 的连续业务缓冲。真正的内存占用还包括 Node.js、自身缓存和下游处理,因此不能把“流式读取”理解成“只占一个 chunk 的内存”。
用 data 事件观察分块
下面示例适用于当前维护中的 Node.js 版本,使用 node:stream 创建一个可读流。Readable.from() 会把数组中的每个元素作为可读数据项;监听 data 后,流进入 flowing 模式,数据到达就立即交给回调。
const { Readable } = require('node:stream');

const source = Readable.from([
  Buffer.from('Node'),
  Buffer.from('.js'),
  Buffer.from(' stream')
]);

source.on('data', (chunk) => {
  console.log(`chunk="${chunk.toString()}" bytes=${chunk.length}`);
});

source.on('end', () => {
  console.log('end');
});
预期输出
chunk="Node" bytes=4
chunk=".js" bytes=3
chunk=" stream" bytes=7
end
这里的 chunk 是 Buffer。如果上游设置了文本编码,回调也可能收到字符串;如果是对象模式流,则 chunk 可以是普通 JavaScript 值。处理二进制协议时应保留 Buffer,不要先转字符串再按字符长度判断字节数。
选择正确的读取模式
最常用的三种消费方式各有明确场景。data 事件适合持续处理每一块;readable 事件适合需要自己决定何时调用 read();异步迭代 for await...of 适合把流消费写成顺序异步代码。
| 方式 | 典型写法 | 适合场景 | 注意点 |
|---|---|---|---|
| flowing | stream.on('data', fn) |
日志、转码、逐块解析 | 消费者必须跟得上数据速度 |
| paused | stream.on('readable', fn) + stream.read() |
精细控制读取时机 | 不要再同时依赖 data |
| async iterator | for await (const chunk of stream) |
async 业务流程 |
循环退出时要考虑流销毁语义 |
readableFlowing 可用来观察状态:初始通常为 null;注册 data、调用 resume() 或 pipe() 后进入 true;调用 pause() 后为 false。不要把 data 与 readable 监听器混在同一段业务逻辑里,否则读取节奏和事件顺序会变得难以推断。
事件结束不等于什么都正常
end 只表示“可读端已经没有更多数据”,并不代表下游写入、数据库提交或网络发送已经完成。文件读取还应监听 error,真实项目通常至少同时处理数据、正常结束和错误三条路径。
验收时可以检查三点:每个 chunk 都被消费、end 只出现一次、异常时不会继续把后续数据当成正常结果。做到这三点后,才算真正掌握了可读流的基本读取过程。