
Node.js / 系统课时
连接关系型数据库
连接关系型数据库
本课使用 PostgreSQL 与 pg 驱动完成 Node.js 数据库接入:把连接信息留在环境变量中,通过连接池复用 TCP 会话,再用一条真实查询验证数据库名、用户与服务端版本。完成后,你会得到可直接放进 API 项目的连接方式,并能按症状定位常见失败。
学习目标
- 使用 PostgreSQL 标准连接环境变量配置
pg,避免把账号密码写死在源码里。 - 为 Web API 设置连接池上限、连接超时与空闲回收参数,并理解它们的作用。
- 执行真实查询验证连接,并能区分端口不可达、认证失败与连接池耗尽。
准备驱动与连接参数
本课以 PostgreSQL 为例,Node.js 侧使用 pg(node-postgres)。在已有 Node.js 项目中执行 npm install pg 即可安装驱动;示例文件使用 .mjs,因此不依赖 package.json 中是否设置 "type": "module"。数据库服务需要先创建一个可登录的业务用户和数据库。
| 变量 | 示例值 | 用途 |
|---|---|---|
PGHOST |
127.0.0.1 |
PostgreSQL 主机名或 IP |
PGPORT |
5432 |
PostgreSQL 监听端口 |
PGDATABASE |
appdb |
目标数据库 |
PGUSER |
appuser |
登录用户 |
PGPASSWORD |
change-me |
登录密码 |
PGPOOL_MAX |
10 |
本应用进程允许的最大连接数 |
把密码交给部署平台的 Secret、容器环境变量或本机未提交的环境文件,不要写进 Git。若运行 4 个 Node.js 进程且每个进程 PGPOOL_MAX=10,应用侧理论上最多会占用 40 条数据库连接,因此连接池大小要按“进程数 × 单进程池上限”计算。
配置连接池而不是每次新建连接
Web API 会持续处理请求,若每个请求都创建并销毁数据库连接,会额外支付握手与认证成本。更常见的做法是每个 Node.js 进程保留一个 Pool:请求到来时借用空闲连接,查询完成后由 pool.query() 自动归还;连接全忙时,新请求进入池的等待队列。
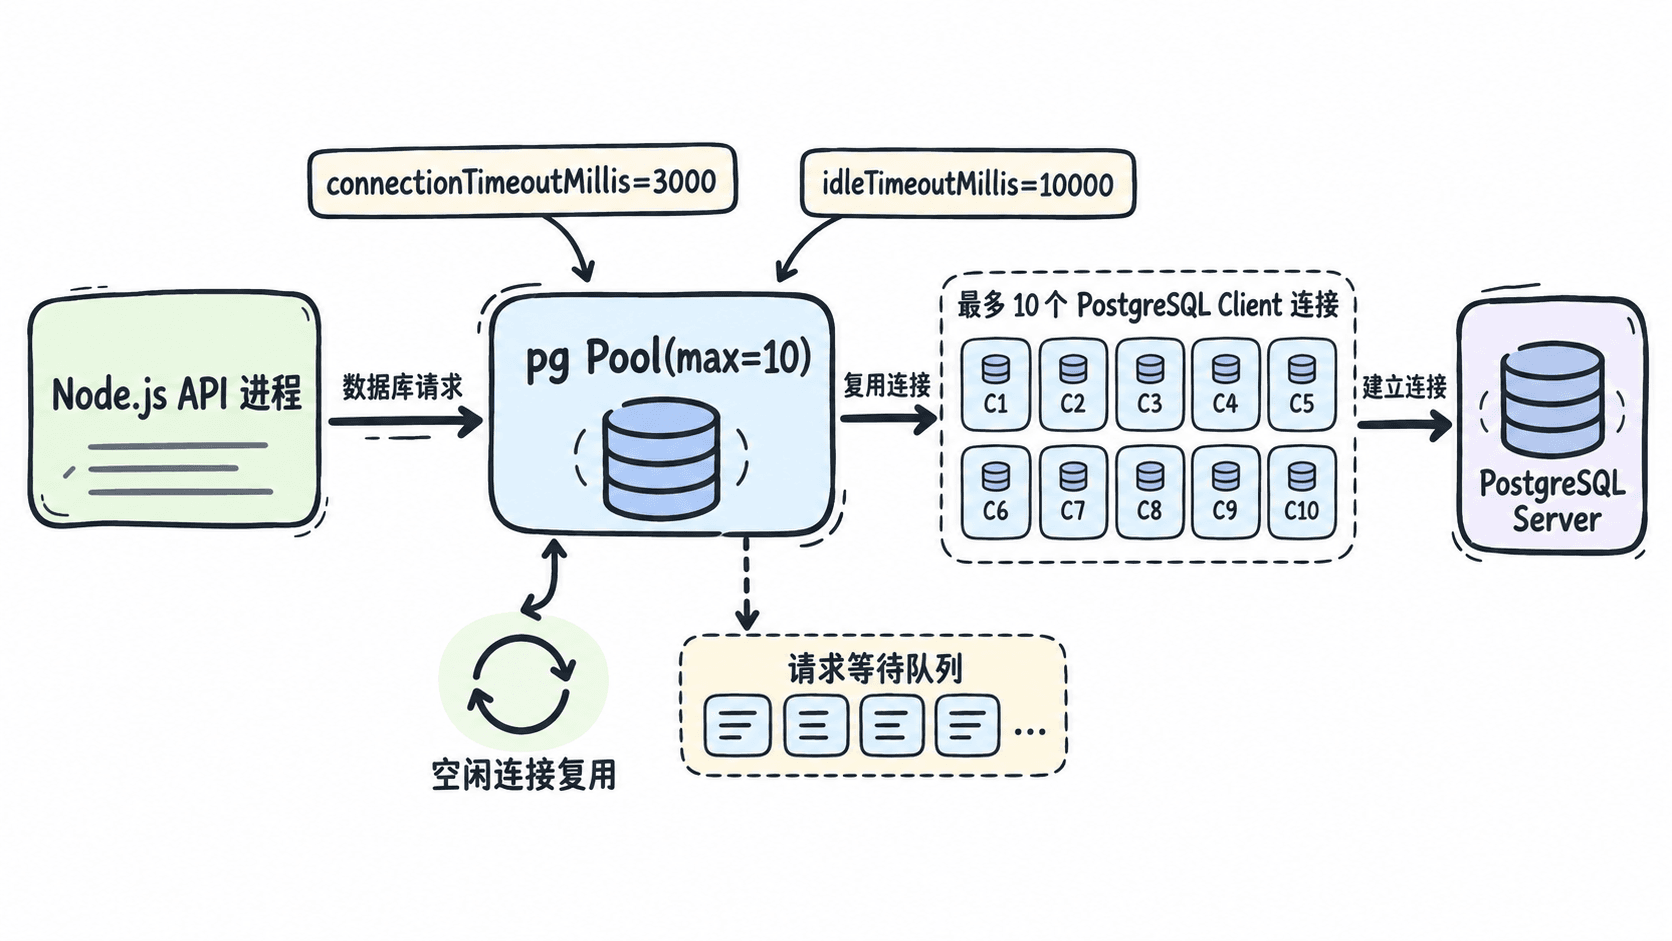
这里建议先用 max=10、connectionTimeoutMillis=3000、idleTimeoutMillis=10000 作为开发环境起点。max 不是越大越好;数据库允许 100 条连接时,还要给管理工具、迁移任务和其他服务留余量,而不是把 100 条全部分给一个 API。
运行真实连接测试
下面程序会检查五个必需环境变量,创建连接池并执行一次查询。查询读取当前数据库、当前用户、PostgreSQL 服务端版本并返回常量 1;无论成功还是失败,脚本最后都会调用 pool.end(),避免一次性脚本因连接池仍存活而无法正常退出。
import { Pool } from 'pg';

const required = ['PGHOST', 'PGPORT', 'PGDATABASE', 'PGUSER', 'PGPASSWORD'];
const missing = required.filter((name) => !process.env[name]);

if (missing.length > 0) {
  throw new Error(`Missing environment variables: ${missing.join(', ')}`);
}

const pool = new Pool({
  max: Number.parseInt(process.env.PGPOOL_MAX ?? '10', 10),
  connectionTimeoutMillis: 3000,
  idleTimeoutMillis: 10000,
});

pool.on('error', (error) => {
  console.error('idle client error:', error.message);
});

try {
  const result = await pool.query(`
    SELECT
      current_database() AS database,
      current_user AS username,
      current_setting('server_version') AS version,
      1::int AS ok
  `);

  const row = result.rows[0];
  console.log(
    `database=${row.database} user=${row.username} version=${row.version} ok=${row.ok}`,
  );
} finally {
  await pool.end();
}预期输出如下,<VERSION> 会随 PostgreSQL 服务端版本变化。保存为 db-test.mjs,设置上表环境变量后执行 node db-test.mjs。
database=appdb user=appuser version=<VERSION> ok=1若输出中的数据库名或用户名不是预期值,连接虽然成功,但实际连到了错误的实例或数据库;这种情况比直接报错更危险,因此连接测试不要只做 SELECT 1,还应打印身份信息用于人工核对。
选择 pool.query 还是 pool.connect
单条独立查询优先使用 pool.query(sql, values),它会自动借出并归还连接。只有事务、会话级设置或必须连续占用同一连接的操作,才使用 pool.connect();拿到客户端后必须在 finally 中执行 client.release(),否则连接会一直被占用。
| 场景 | 推荐 API | 检查点 |
|---|---|---|
单条 SELECT、INSERT、UPDATE |
pool.query() |
查询结束后无需手动释放 |
| 多语句事务 | pool.connect() |
BEGIN、业务 SQL、COMMIT 必须在同一客户端 |
| 事务异常 | client.query('ROLLBACK') |
回滚后仍要 client.release() |
| 进程关闭 | pool.end() |
等待池内连接结束后退出 |
按现象定位连接失败
先判断错误发生在“网络可达”“认证”“数据库选择”还是“连接池等待”哪一层,不要一上来就改 SQL。ECONNREFUSED 通常优先检查主机和端口;password authentication failed 说明服务端已收到连接但拒绝认证;连接超时则继续检查防火墙、DNS、云安全组和数据库监听地址。
| 现象 | 第一检查项 | 常见修正 |
|---|---|---|
ECONNREFUSED |
PGHOST、PGPORT 与数据库进程状态 |
修正地址,确认 PostgreSQL 正在监听目标端口 |
password authentication failed |
PGUSER、PGPASSWORD |
重置密码或确认连接到正确实例 |
database "..." does not exist |
PGDATABASE |
创建数据库或改为已有数据库名 |
| 等待数秒后超时 | 网络路径与池是否被占满 | 检查防火墙,并确认所有 pool.connect() 都会释放 |
上线前至少保留一个只读健康检查查询,并把连接池的总连接数、空闲连接数和等待请求数纳入监控。连接测试通过只能证明“此刻可连接并执行查询”,并不代表池大小、数据库权限和生产网络配置已经合理。