
图形渲染与 Shader / 系统课时
遇到瓶颈怎么重新取舍
遇到瓶颈怎么重新取舍
大型场景优化不会把所有成本同时降到最低:减少对象可能缓解 CPU,却增加合批或内存压力;提高流式加载强度可能降低常驻内存,却制造带宽和加载峰值。本节建立一套重新分配 CPU、GPU、内存和带宽预算的方法,在瓶颈迁移后继续做有针对性的取舍。
学习目标
- 根据帧时间、内存和流式数据判断当前真正限制性能的资源
- 区分降低画质与重新分配预算,避免机械地继续减少模型质量
- 根据瓶颈类型选择 LOD、实例化、纹理、阴影和加载策略
先重新测量而不是延续旧结论
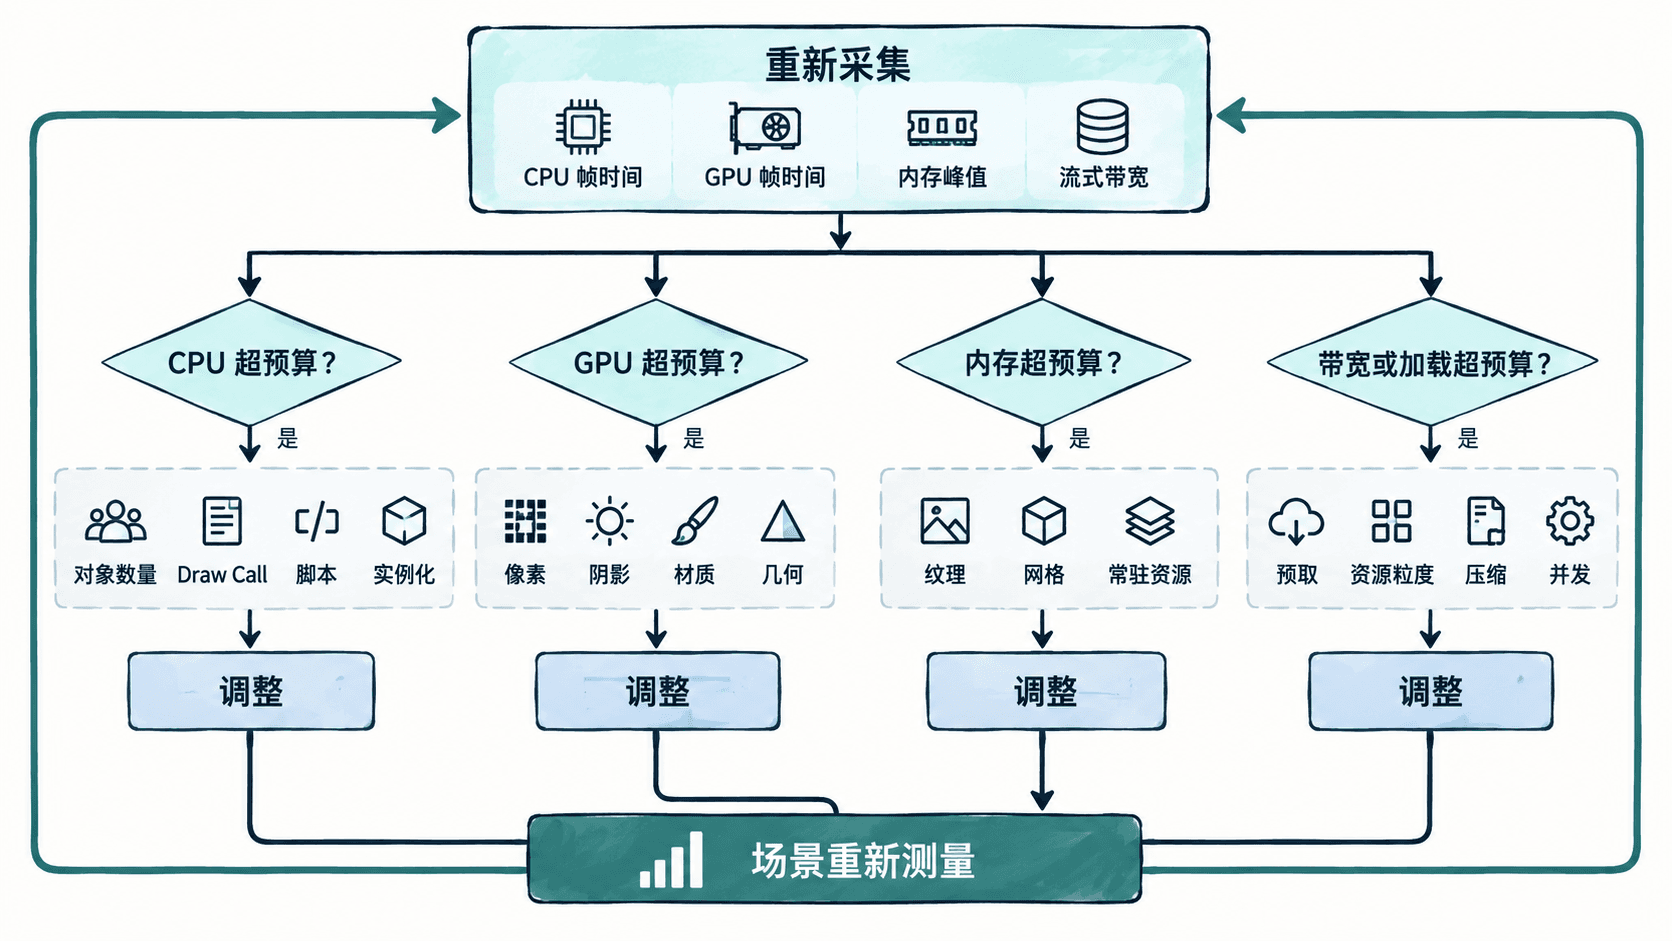
一次优化完成后,原来的瓶颈可能已经消失。例如降低远景三角形后,GPU 时间下降,但更多对象开始由 CPU 提交;减少常驻资源后,内存占用下降,却让存储读取和资源解压更频繁。因此每轮调整都应重新采集完整指标,而不是继续按照第一次 Profile 的结论优化。
建议至少同时记录 CPU 帧时间、GPU 帧时间、峰值内存、单位时间流式读取量和明显卡顿点,并保证测试场景、路径和画质条件一致。单看平均 FPS 很难判断资源究竟卡在哪里,因为不同瓶颈都可能表现为相似的帧率下降。
用帧时间判断 CPU 与 GPU 压力
以 60 FPS 为例,每帧总预算约为 16.67 ms,但不能简单要求 CPU 和 GPU 各占一半。真正需要关注的是哪一侧持续接近或超过可接受帧时间,以及 CPU 与 GPU 是否存在明显等待关系。降低一个已经富余的资源通常不会改善最终帧率。
下面的 Python 示例使用一组采样值计算各项预算压力,适合作为离线分析脚本的最小版本。实际项目应把数值替换为 Profiler 或性能采集系统导出的结果。
budgets = {
    "cpu_ms": 16.67,
    "gpu_ms": 16.67,
    "memory_mb": 4096,
    "stream_mb_s": 180,
}

measured = {
    "cpu_ms": 11.8,
    "gpu_ms": 18.9,
    "memory_mb": 3480,
    "stream_mb_s": 126,
}

for name, budget in budgets.items():
    usage = measured[name]
    pressure = usage / budget
    state = "OVER" if pressure > 1.0 else "OK"
    print(f"{name}: {pressure:.2f} {state}")
预期输出:
cpu_ms: 0.71 OK
gpu_ms: 1.13 OVER
memory_mb: 0.85 OK
stream_mb_s: 0.70 OK
这个结果说明当前应优先处理 GPU,而不是继续减少 CPU 对象管理开销。真实项目中的阈值还应预留安全余量,并结合低端目标设备的波动范围,而不是长期运行在理论上限附近。
CPU 瓶颈时优先减少提交和管理成本
CPU 超预算时,继续降低网格面数往往收益有限,因为三角形主要由 GPU 处理。此时更值得检查可见对象数量、Draw Call、材质状态切换、脚本更新、动画、物理以及运行时实例化峰值。大量非常简单的远景对象,也可能因为提交次数过多而让 CPU 成为新瓶颈。
可以考虑实例化重复物体、合并真正静态且生命周期一致的对象、减少不必要的逐帧逻辑,并控制分帧创建数量。合并并非越多越好:过大的批次可能降低剔除粒度,让不可见几何仍被提交,所以修改后必须重新观察 CPU 与 GPU 两侧的变化。
GPU 瓶颈时不要只盯着三角形
GPU 压力可能来自顶点处理,也可能来自高分辨率渲染、大面积透明、阴影、复杂材质或严重过绘。如果降低模型面数后 GPU 时间几乎不变,就应停止继续破坏 LOD 质量,转而检查像素和材质成本。
例如远景森林的瓶颈如果来自大面积透明树叶和阴影,继续减少树干顶点通常不会产生明显收益。此时可以调整远距离材质复杂度、阴影距离、透明层数或渲染分辨率。只有确认顶点处理仍占主要压力时,继续压缩几何才有明确理由。
内存与带宽是一组相互牵制的预算
降低常驻内存通常意味着更多资源需要按需读取,因而可能增加存储带宽和解压压力;反过来,为了消除流式卡顿而扩大缓存,又会提高内存峰值。因此这两个指标必须一起观察,不能分别追求最低值。
当内存超预算而带宽仍有余量时,可以缩小非关键资源的常驻范围、降低远距离纹理 mip,并让资源更积极地流入流出。当内存还有空间但高速移动频繁出现加载迟到时,则可以适当扩大缓存和预取窗口,用可控的内存换取更稳定的加载时间。
每次只验证一个主要取舍
重新取舍时,应先明确本轮希望解决的主瓶颈,再选择与它直接相关的参数。例如 GPU 超预算就先调整阴影或远景材质,内存超预算就先调整纹理和常驻集合。若一次同时修改 LOD、纹理、加载半径和阴影距离,即使结果变好,也很难知道真正有效的是哪一步。
修改后重新跑同一条性能路径,比较修改前后的 CPU、GPU、内存、带宽以及视觉回归结果。如果主瓶颈下降但另一个资源逼近上限,就说明瓶颈已经迁移,需要开始下一轮预算分配,而不是继续沿用上一轮的优化方向。