
图形渲染与 Shader / 系统课时
实例化如何降低提交开销
实例化如何降低提交开销
当场景里有几千棵相同的树、石头或路灯时,GPU 真正绘制它们之前,CPU 可能已经被大量重复的绘制提交拖慢。GPU Instancing 的价值就是让一批共享网格和材质的对象合并提交,同时为每个实例保留独立的变换等少量数据。
学习目标
- 理解实例化减少的是哪一部分渲染开销
- 判断哪些重复物体适合使用 GPU Instancing
- 区分提交次数下降与 GPU 实际工作量下降
实例化改变了什么
没有实例化时,即使一千块石头使用完全相同的网格和材质,CPU 仍可能需要反复准备并提交绘制命令。实例化把共享状态放在一起,只提交一次网格和材质,再额外提供每个实例的位置、旋转、缩放或其他实例属性。
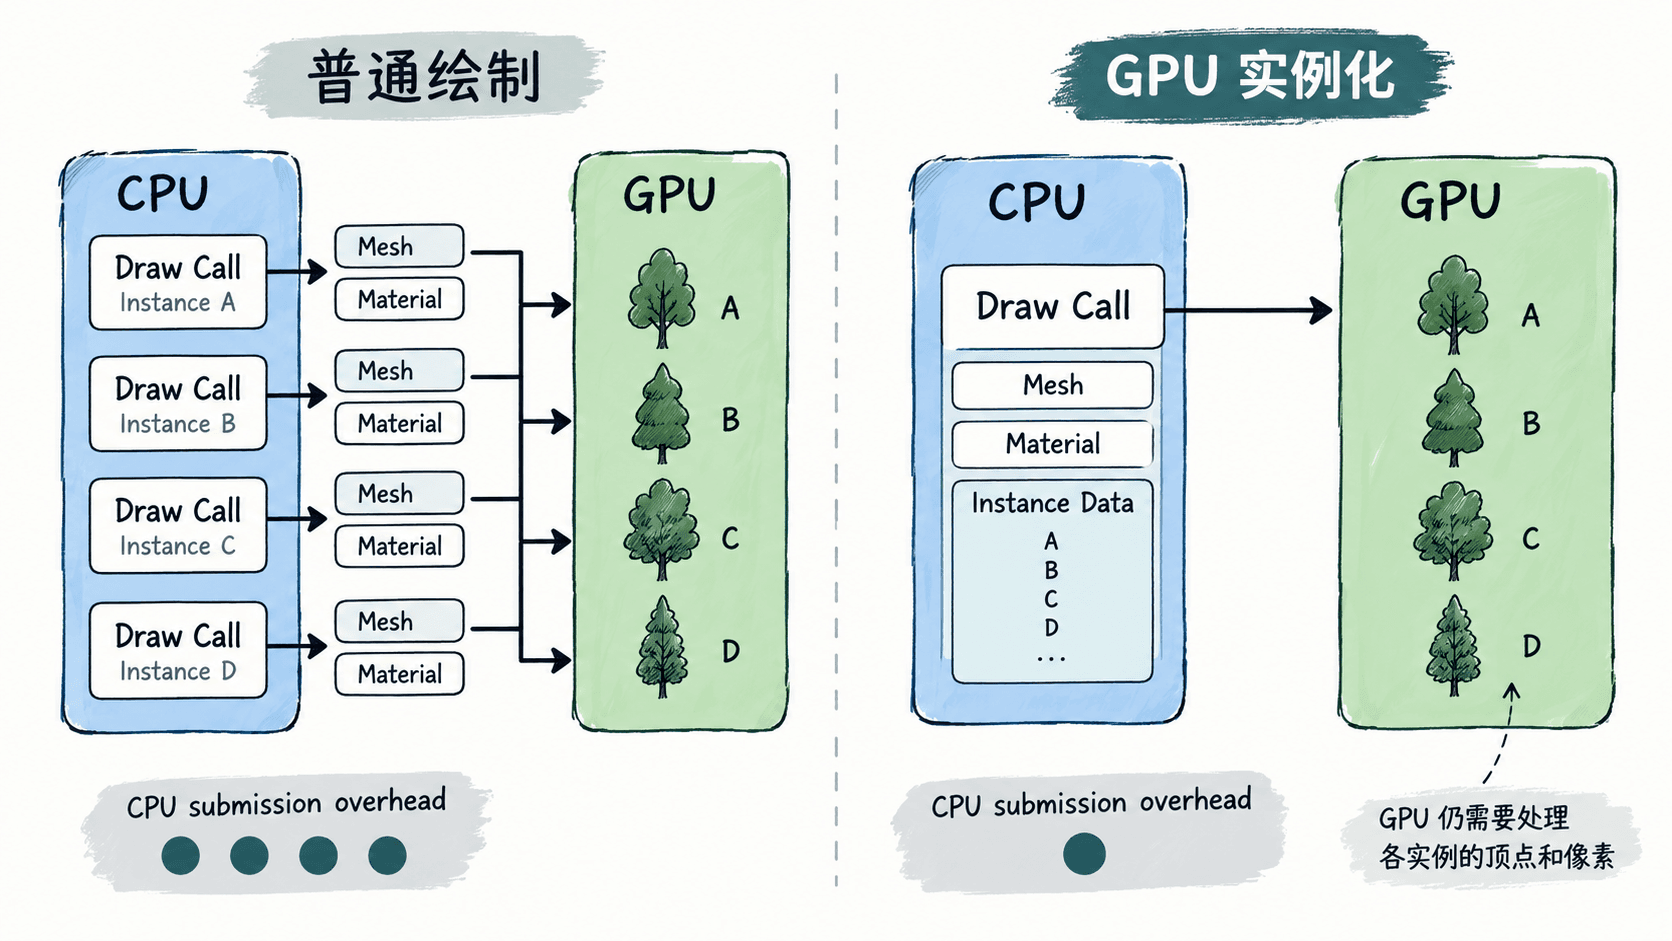
因此,实例化主要优化的是 CPU 到图形 API、驱动以及 GPU 命令处理之间的提交开销。它不会把一千棵树变成一棵树,也不会自动减少每棵树需要处理的顶点和像素。
哪些对象适合实例化
最典型的对象是大量重复网格,例如树木、草簇、石块、路灯、围栏和建筑模块。它们应尽量共享网格、材质与渲染状态,只把位置、旋转、缩放、颜色等变化放到实例数据中。
如果每个对象都使用不同网格、不同材质关键字或不同渲染 Pass,引擎通常很难把它们放进同一个实例批次。频繁修改会破坏批次的材质状态,也会削弱实例化的收益。
提交次数可以下降多少
可以用一个简化模型理解数量级变化。假设场景中有 2400 个重复物体,不使用实例化时每个对象对应一次提交;启用实例化后,如果每个批次最多容纳 500 个实例,则理论提交次数只需要按批次数计算。
import math

instance_count = 2400
max_instances_per_batch = 500

normal_draw_calls = instance_count
instanced_draw_calls = math.ceil(instance_count / max_instances_per_batch)
reduction = 1 - instanced_draw_calls / normal_draw_calls

print(f"normal draw calls: {normal_draw_calls}")
print(f"instanced draw calls: {instanced_draw_calls}")
print(f"submission reduction: {reduction:.2%}")
预期输出:
normal draw calls: 2400
instanced draw calls: 5
submission reduction: 99.79%
这个结果只是解释提交数量变化,不代表真实引擎一定会得到 5 个 Draw Call。实际批次还会受到材质、Shader、LOD、阴影 Pass、每批实例上限和引擎内部剔除策略影响,因此最终结果必须用 Frame Debugger、RenderDoc 或引擎自带渲染统计验证。
实例化没有消除 GPU 工作量
如果 2400 棵树都处于可见范围,GPU 仍然需要执行这些实例对应的顶点着色、光栅化和像素着色。假如瓶颈已经位于高分辨率叶片过绘或复杂阴影,Draw Call 从几千降到几十,也可能几乎不改变 GPU 帧时间。
这也是实例化必须和 LOD、视锥剔除、距离剔除结合的原因。剔除解决“哪些实例根本不该画”,LOD 解决“远处实例应该画多复杂”,实例化解决“剩余大量相似实例如何更便宜地提交”。三者针对的是不同成本,不能互相替代。
用 CPU 与 GPU 指标验证收益
验证实例化时,应保持可见对象数量、相机位置、LOD 和材质不变,只切换实例化方案。首先观察 Draw Call 或批次数是否明显下降,再检查 CPU 渲染线程、Render Thread 或驱动提交时间是否随之降低。
如果 Draw Call 大幅下降且 CPU 帧时间改善,说明实例化命中了提交瓶颈;如果提交减少但总帧时间几乎不变,就继续检查 GPU 顶点、像素、阴影和带宽成本。优化目标不是追求最低 Draw Call 数,而是确认减少提交后是否释放了真正受限的运行时预算。