
图形渲染与 Shader / 系统课时
用 Profiler 找到真实瓶颈
用 Profiler 找到真实瓶颈
大型场景卡顿时,三角形数量只是众多变量之一。真正可靠的排查方式,是先用 Profiler 把一帧拆成 CPU、GPU 和渲染阶段,再逐层缩小范围。本课建立一条可复用的分析路径,让你先找到耗时最大的环节,再决定是否该动 LOD、脚本、材质或后处理。
学习目标
- 能从总帧时间开始,判断当前主要受 CPU 还是 GPU 限制。
- 能沿着 Profiler 时间线定位到具体系统或渲染阶段。
- 能用固定场景、稳定采样和单变量修改验证瓶颈是否真的被消除。
从一帧的总预算开始
先确定目标帧率对应的帧时间预算。60 FPS 的单帧预算约为 16.7 ms,30 FPS 约为 33.3 ms。Profiler 中首先看的是整帧耗时,而不是某个看起来很高的计数器。
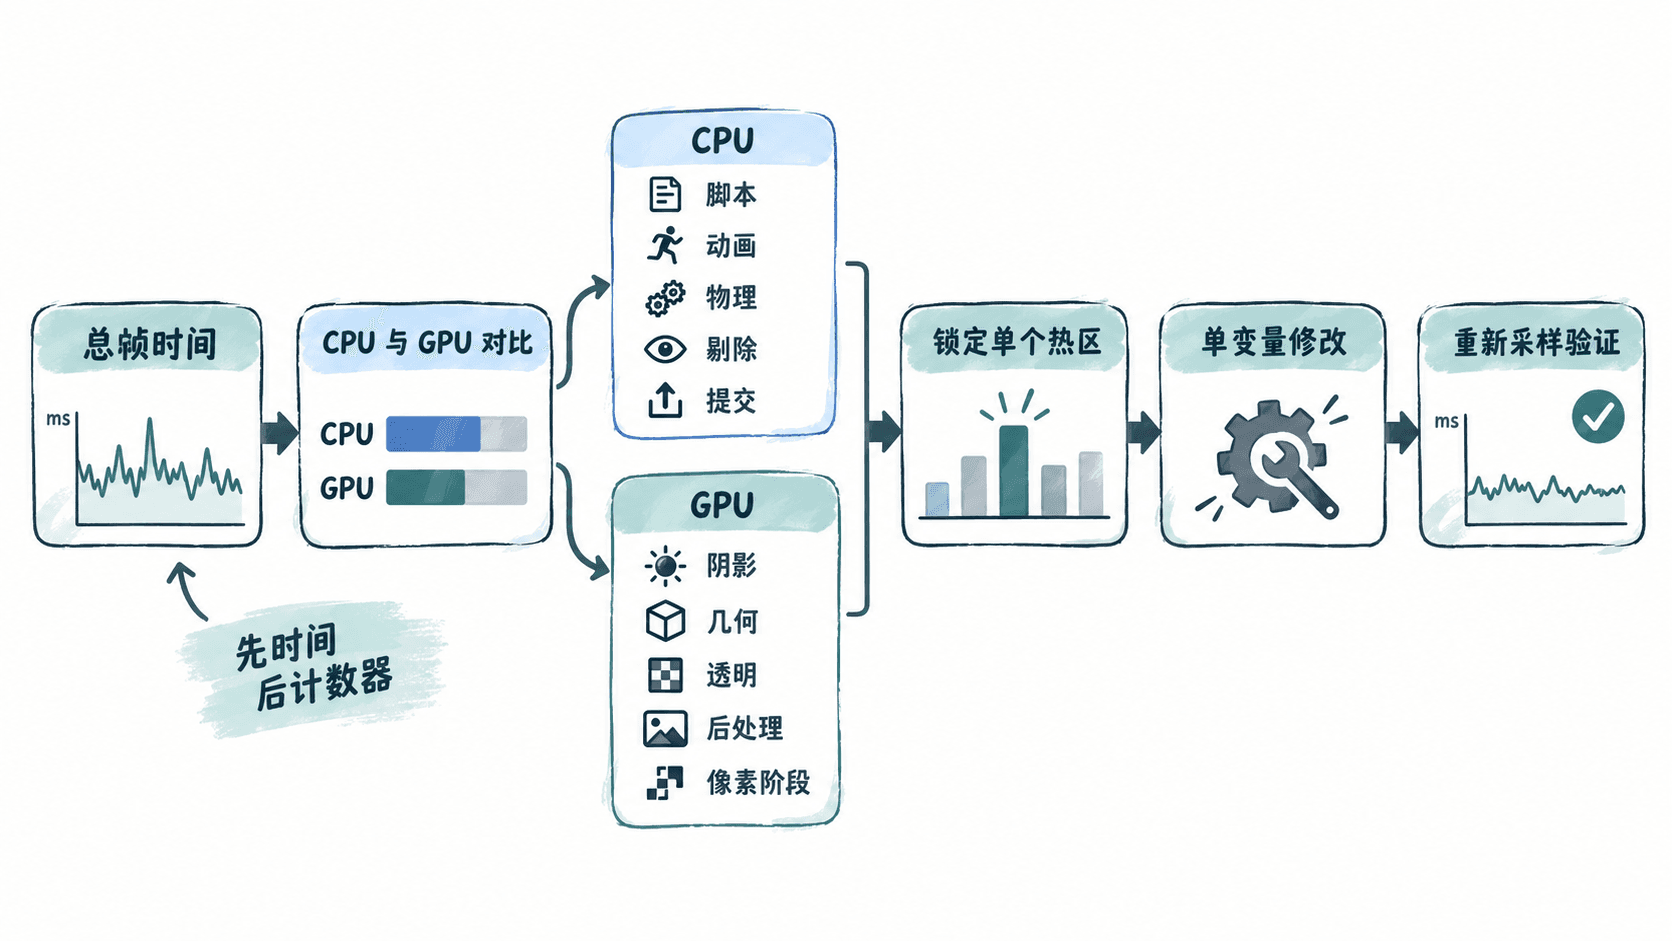
如果 CPU 主线程持续高于 GPU 时间,应优先检查脚本、动画、物理、剔除、提交 Draw Call 等 CPU 工作;如果 GPU 时间更高,则继续拆分阴影、几何、透明、后处理和像素阶段。两者接近时,要结合平台工具和同步等待判断,避免把等待时间误认为实际计算成本。
建立可重复的采样场景
Profiler 数据只有在条件可控时才有比较价值。选择一个能稳定复现问题的相机路径或固定机位,锁定分辨率、画质、角色数量、天气和特效状态。预热资源后再采样,避免把首次加载、Shader 编译或缓存建立混进稳定运行数据。
单次尖峰适合排查卡顿事件,但判断常态瓶颈时更应关注连续帧。可以记录几十到几百帧的中位数和高分位帧时间,再结合时间线查看最重阶段。这样能避免只挑一帧得出错误结论。
用最小数据判断 CPU 还是 GPU
当 Profiler 能导出或手工记录帧时间时,可以先做一个简单分类。下面脚本用一组采样值判断主瓶颈方向,重点是分析思路,不绑定任何引擎字段名。
frames = [
    {"frame": 1, "cpu_ms": 18.4, "gpu_ms": 11.2},
    {"frame": 2, "cpu_ms": 17.9, "gpu_ms": 11.5},
    {"frame": 3, "cpu_ms": 18.7, "gpu_ms": 11.3},
]

avg_cpu = sum(item["cpu_ms"] for item in frames) / len(frames)
avg_gpu = sum(item["gpu_ms"] for item in frames) / len(frames)

print(f"CPU avg: {avg_cpu:.1f} ms")
print(f"GPU avg: {avg_gpu:.1f} ms")

if avg_cpu - avg_gpu >= 2.0:
    print("Primary direction: CPU")
elif avg_gpu - avg_cpu >= 2.0:
    print("Primary direction: GPU")
else:
    print("Primary direction: mixed or synchronization-bound")
预期输出
CPU avg: 18.3 ms
GPU avg: 11.3 ms
Primary direction: CPU
阈值 2.0 ms 只是示例,不应当作通用标准。实际项目要结合目标平台、计时精度和帧间波动判断,并继续查看 Profiler 时间线中的具体调用或渲染阶段。
沿时间线继续缩小范围
确定 CPU 方向后,不要立即归因于“对象太多”。应继续查看主线程中最耗时的系统,例如脚本更新、动画、物理、可见性判断、批次提交;确定 GPU 方向后,则查看最重的渲染 Pass、阴影、透明、后处理或分辨率相关阶段。
计数器用于解释耗时,不用于替代耗时。三角形、Draw Call、可见对象数、材质数都可能与性能有关,但只有它们与时间变化同步时,才能证明相关性。一个三角形很多但 GPU 时间稳定的场景,不应仅凭数量去做大规模 LOD 重构。
用单变量修改完成验证
定位到可疑模块后,一次只改变一个主要变量。例如临时关闭阴影、禁用某类特效、降低远景密度或跳过某段更新逻辑,然后重新采样同一段场景。如果对应阶段时间显著下降,且总帧时间同步改善,就说明判断方向正确。
验证完成后再做正式优化,并重复同样的采样条件。Profiler 的价值不只是“找到最红的一条”,而是建立证据链:总帧时间异常、具体阶段占比高、单变量修改后该阶段和总帧时间同时下降。只有这条链闭合,才算找到了真实瓶颈。