
图形渲染与 Shader / 系统课时
远景纹理为什么还很贵
远景纹理为什么还很贵
模型已经切到低面数,GPU 时间却没有明显下降,常见原因是几何成本降下来了,像素阶段仍在持续采样多张纹理。本节从屏幕覆盖、采样次数、显存带宽和纹理缓存四个角度判断远景到底还贵在哪里。
学习目标
- 区分几何成本下降与纹理采样成本下降,避免只看三角形数量
- 根据屏幕覆盖和采样数量估算纹理读取压力
- 能从 Mip、材质复杂度和缓存局部性三个方向降低远景像素成本
几何变少不代表像素工作同步变少
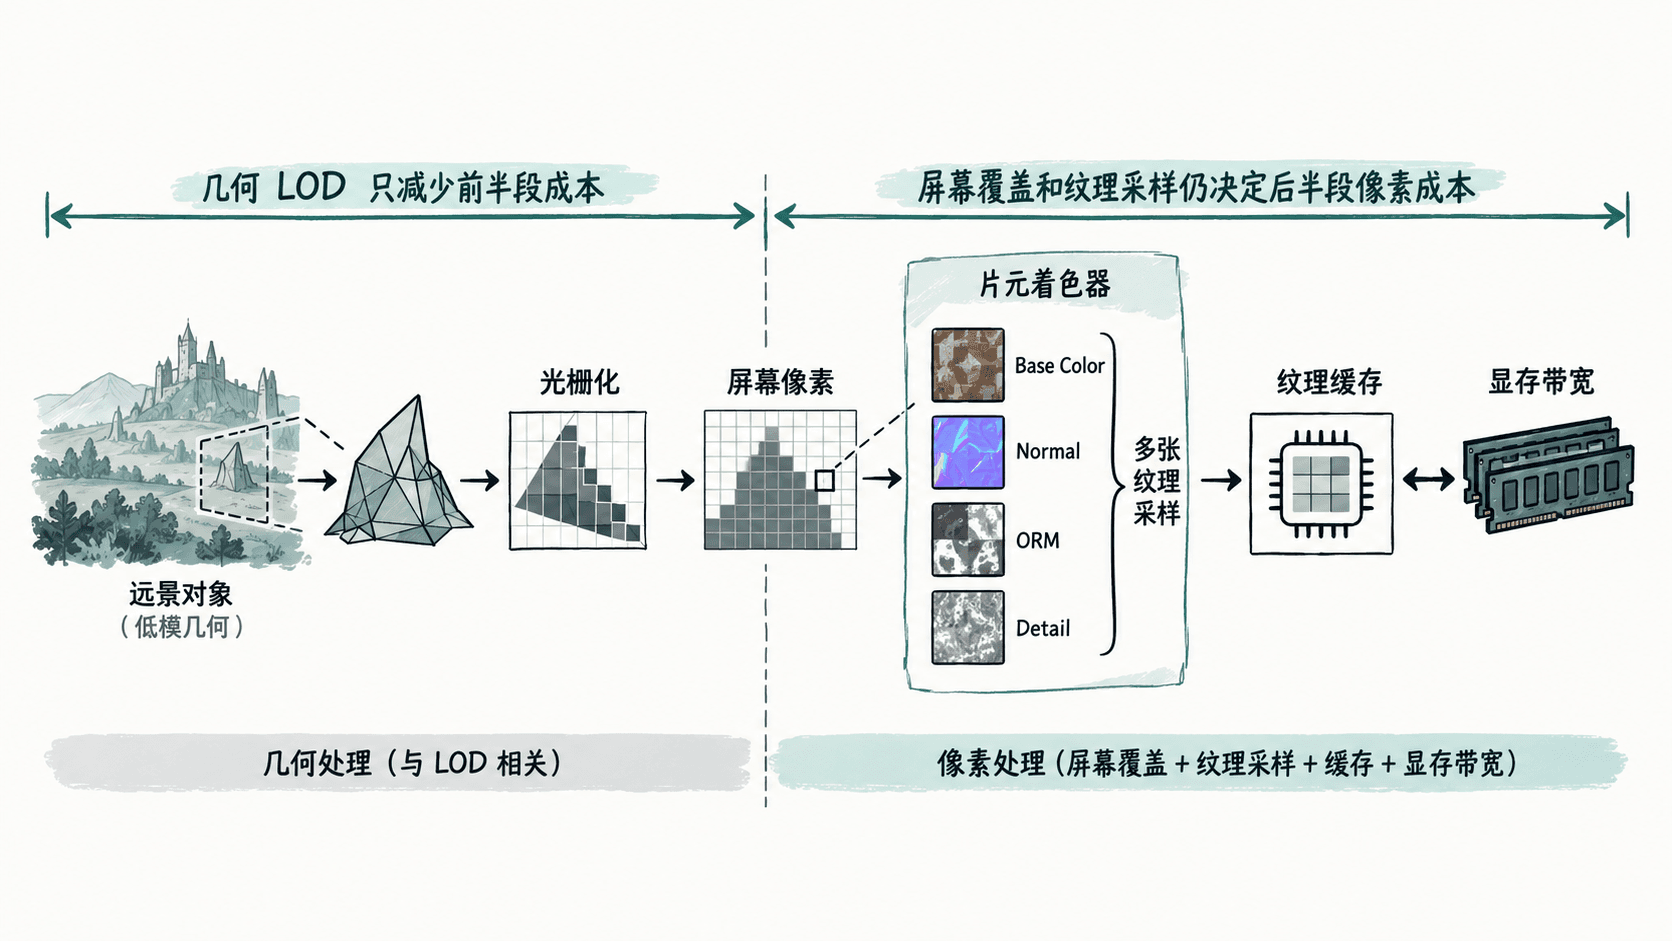
LOD 通常首先减少顶点和三角形数量,但物体只要仍占据屏幕像素,片元着色器就还要执行。一个远景建筑即使从数万三角形降到几百三角形,只要材质仍采样 Base Color、Normal、ORM、Detail 等纹理,每个可见像素依然可能触发多次纹理读取。
更需要警惕的是大面积地形、山体和建筑群。它们距离相机很远,却可能共同覆盖屏幕的大部分区域。此时瓶颈已经从“处理多少几何”转移为“给多少像素运行多复杂的材质”,继续压三角形通常不会得到同等收益。
用一个近似值判断带宽压力
可以先用“覆盖像素数 × 每像素采样次数 × 每次读取字节数”做粗略估算。它不是实际显存流量,因为 GPU 缓存、纹理压缩和采样合并都会改变最终结果,但足以比较两个材质方案的量级差异。
下面的脚本估算一个覆盖 1080p 屏幕 8% 的远景材质,在每像素 4 次和 1 次纹理采样下的理论读取量。
width = 1920
height = 1080
coverage = 0.08
bytes_per_sample = 4
fps = 60

for samples_per_pixel in (4, 1):
    visible_pixels = width * height * coverage
    bytes_per_frame = visible_pixels * samples_per_pixel * bytes_per_sample
    mib_per_second = bytes_per_frame * fps / (1024 * 1024)
    print(f"{samples_per_pixel} samples/pixel: {mib_per_second:.1f} MiB/s")
预期输出:
4 samples/pixel: 151.9 MiB/s
1 samples/pixel: 38.0 MiB/s
这个数字不能直接当成真实 DRAM 带宽,但同一覆盖范围从 4 次采样减到 1 次时,理论读取需求下降到四分之一。性能分析时应先比较这种相对变化,再结合 GPU Profiler 中的纹理、带宽和片元指标确认实际瓶颈。
Mip 能省带宽,也能提高缓存命中
远处一个屏幕像素往往对应原纹理中的大量纹素。如果仍读取最高分辨率纹理,不仅浪费数据,还会让相邻像素访问更分散的地址,降低缓存局部性。MipMap 会提前生成更低分辨率层级,让远景使用尺寸更匹配当前屏幕投影的纹理数据。
正确的 Mip 层级通常由 GPU 根据纹理坐标导数自动选择。远景优化首先应确认纹理确实生成了 Mip,而不是急着加入很大的 Mip Bias。过度偏向低分辨率层级虽然能减少带宽,却会让材质提前模糊,甚至暴露不同 LOD 之间的视觉跳变。
远景材质应该跟着几何一起降级
当物体进入更远的几何 LOD 时,可以同步减少对轮廓贡献很小的材质特性,例如关闭微表面 Detail、降低法线细节、合并遮罩通道,或者改用烘焙后的简化结果。判断标准不是“远景全部换成单色”,而是只保留当前屏幕尺寸仍能被看见的频率信息。
如果 Profiler 显示顶点阶段已经明显下降,而 GPU 帧时间、纹理读取或片元耗时仍高,就应该把排查重点从三角形数量转向屏幕覆盖、Overdraw、采样数量、Mip 使用情况和远景材质分支。LOD 真正有效的目标,是让几何与像素成本一起随距离下降。