
图形渲染与 Shader / 系统课时
为什么远景也会拖慢帧率
为什么远景也会拖慢帧率
远处物体在屏幕上可能只有几十个像素,但它们并不会自动变成“零成本”。只要仍参与可见性判断、Draw Call 提交、顶点处理和像素着色,就会持续消耗 CPU 与 GPU。本节建立一个可操作的远景成本模型,帮助你判断 LOD 到底应该减少什么。
学习目标
- 识别远景对象在 CPU 与 GPU 上仍会产生的主要成本
- 理解物体数量、网格、材质和提交次数之间的关系
- 用简单预算模型估算某类远景对象是否值得继续优化
远景成本不只来自三角形
判断一个远景对象是否昂贵,不能只看三角形数量。一个只有几百个三角形的小物体,如果场景里存在几千份实例,而且每份都使用独立材质或产生独立提交,CPU 仍可能花大量时间准备渲染命令。
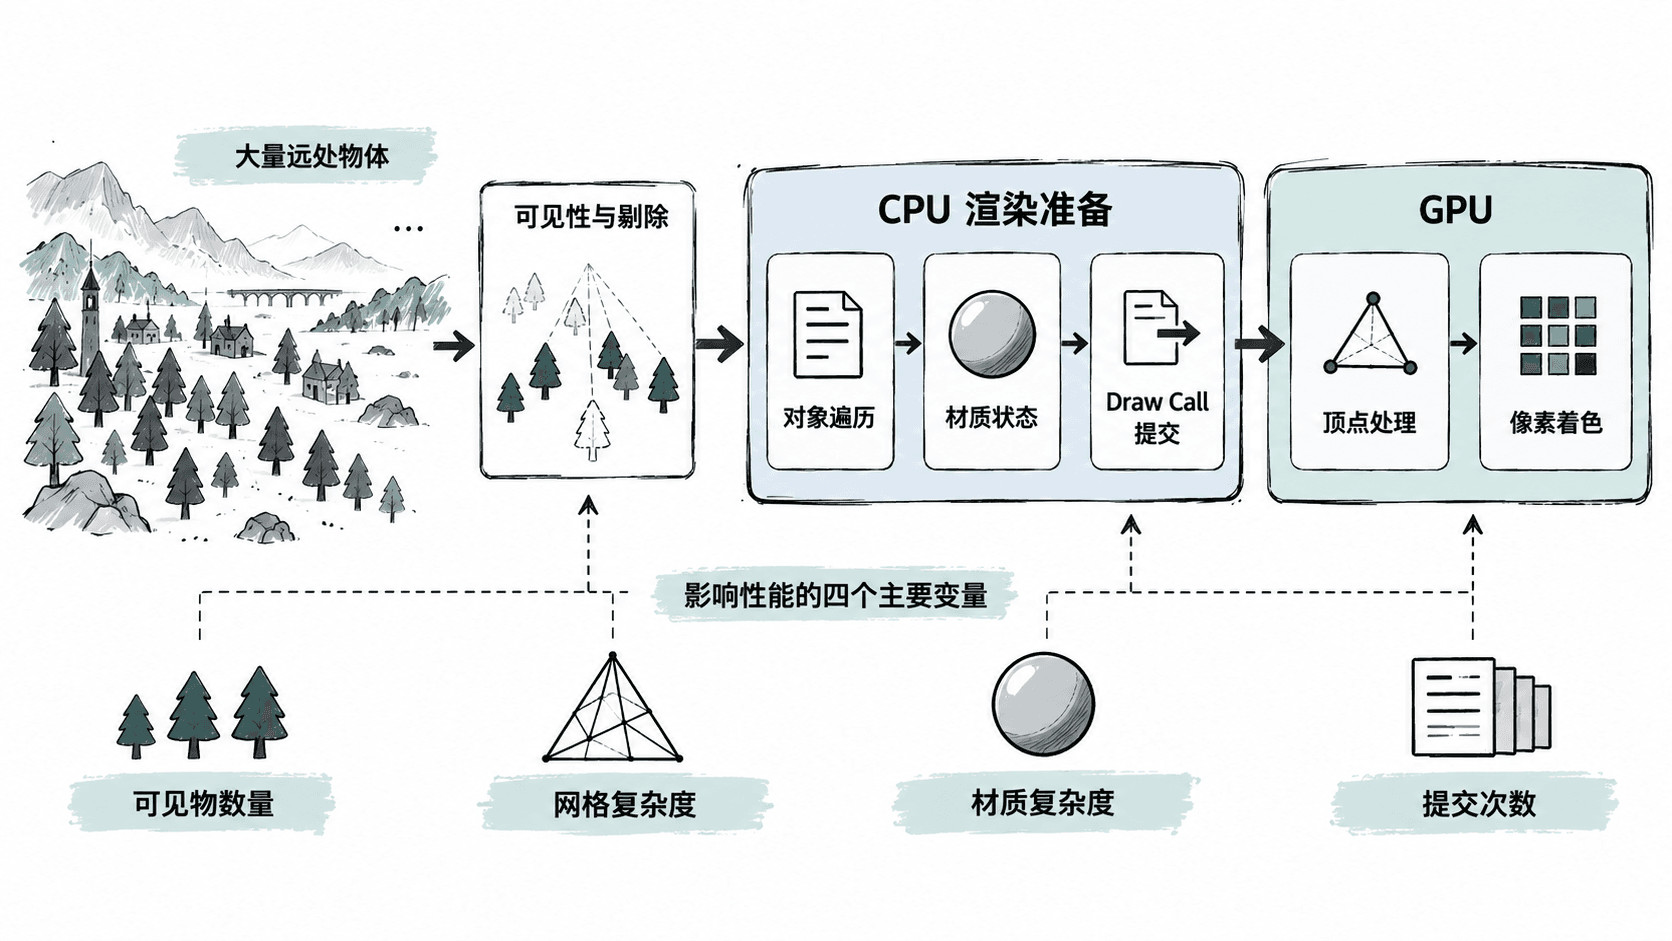
可以把单帧远景成本粗略拆成四部分:对象管理成本、提交成本、几何处理成本和像素处理成本。其中前两项更容易压到 CPU,后两项主要压到 GPU,但实际引擎还会受到剔除、阴影、透明度和批处理方式影响。
四个变量怎样放大成本
可见物数量决定有多少对象需要被遍历、剔除、排序和提交。即使单个对象非常轻,数量达到数千或数万后,对象级开销也可能成为主导因素。
网格复杂度主要影响顶点着色、顶点属性读取和后续光栅化。LOD 降低三角形数量最直接解决这一项,但如果瓶颈本来在 CPU 提交,单纯把 10 万三角形减到 1 万并不一定明显提升帧率。
材质复杂度影响像素着色器执行次数、纹理采样和分支。远景覆盖面积通常较小,因此材质简化的收益取决于屏幕覆盖率;但透明材质、重叠植被和昂贵阴影仍可能让远处区域产生较高像素成本。
提交开销与 Draw Call、材质切换和实例化策略有关。大量小对象尤其容易出现“每个都不贵,但一起很贵”的情况,因此 LOD 系统除了减面,还经常需要配合合批、GPU Instancing 或远景代理。
用预算模型快速估算
在真正进入引擎 Profiler 前,可以先用一个简化模型比较两组远景对象。下面的 Python 示例把每个对象的 CPU 提交成本、顶点成本和像素成本相加,得到单帧的粗略预算。这个模型不是引擎真实计时器,而是帮助你理解变量敏感度。
def estimate_frame_cost(count, draw_calls, triangles_per_object, pixels_per_object):
    cpu_object_ms = count * 0.0004
    cpu_submit_ms = draw_calls * 0.015
    gpu_vertex_ms = count * triangles_per_object * 0.00000002
    gpu_pixel_ms = count * pixels_per_object * 0.00000001
    return cpu_object_ms + cpu_submit_ms + gpu_vertex_ms + gpu_pixel_ms

before = estimate_frame_cost(
    count=3000,
    draw_calls=1800,
    triangles_per_object=1200,
    pixels_per_object=900,
)

after = estimate_frame_cost(
    count=3000,
    draw_calls=180,
    triangles_per_object=300,
    pixels_per_object=900,
)

print(f"before={before:.2f} ms")
print(f"after={after:.2f} ms")
预期输出:
before=28.30 ms
after=3.95 ms
示例中的系数只是人为设定的教学参数,不能拿来替代真实硬件测量。关键是观察变量:如果只降低三角形而 Draw Call 不变,CPU 提交成本仍然存在;如果同时减少提交和几何复杂度,总成本才可能明显下降。
优化时先找最大的那一项
远景优化不应该等价于“给模型做三档减面”。当场景被 CPU 提交限制时,应优先减少对象数量和提交次数;当 GPU 顶点阶段受限时,再降低远景几何复杂度;当像素阶段受限时,则要检查材质、透明重叠、阴影和屏幕覆盖率。
因此,LOD 的真正目标不是让远处模型看起来更简单,而是在视觉误差可以接受的距离上,主动减少当前平台最昂贵的那部分工作。只有先建立成本模型,后续的距离阈值、层级数量和运行时预算才有明确依据。