
图形渲染与 Shader / 系统课时
先分清 CPU 与 GPU 瓶颈
先分清 CPU 与 GPU 瓶颈
LOD 调整后帧率没有变化,并不一定说明优化失败,更常见的原因是你优化了错误的一侧。大型场景可能被 CPU 的对象遍历和提交限制,也可能被 GPU 的顶点、像素或阴影限制。本节用帧时间拆分建立最基本的定位顺序。
学习目标
- 用 CPU 与 GPU 帧时间判断当前主要瓶颈
- 理解为什么 FPS 不能直接说明瓶颈来源
- 根据测量结果选择对象、网格或材质优化方向
先看毫秒,不要只看 FPS
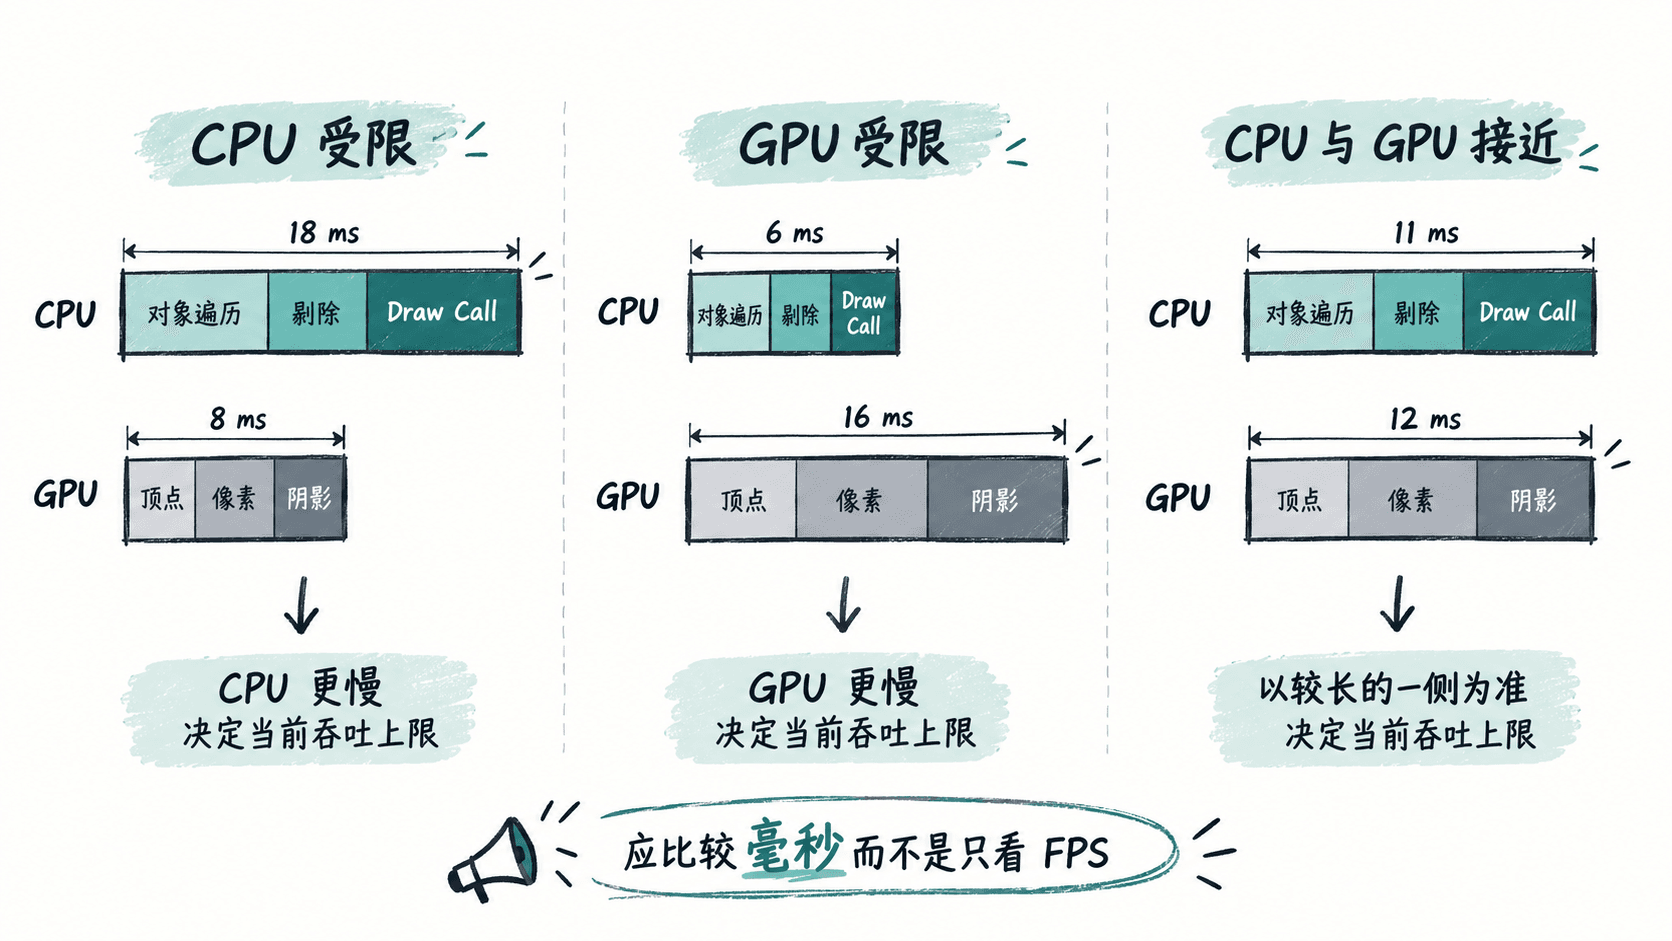
FPS 是最终结果,但定位性能问题时应先看帧时间。60 FPS 对应约 16.67 ms,30 FPS 对应约 33.33 ms。只知道“当前 45 FPS”,并不能判断时间花在 CPU 还是 GPU。
对一帧来说,可以先记录 CPU Frame Time 与 GPU Frame Time。粗略判断时,较大的那一侧通常更接近当前限制因素。例如 CPU 为 19 ms、GPU 为 11 ms,继续降低远景三角形可能几乎没有收益,因为 GPU 本来就在等待 CPU。
用拆分结果做第一轮判断
实际引擎的 CPU 与 GPU 会并行工作,还可能存在同步等待,因此不能简单把两个时间相加。但是在稳定场景中,比较它们仍然是非常有效的第一轮诊断方法。
| 测量现象 | 更可能的方向 | 优先检查 |
|---|---|---|
| CPU 明显高于 GPU | CPU 侧受限 | 可见对象数量、Draw Call、剔除、脚本更新 |
| GPU 明显高于 CPU | GPU 侧受限 | 三角形、材质、阴影、透明重叠、分辨率 |
| 两者都接近预算上限 | 双侧都紧张 | 分别做隔离实验,避免一次修改多个变量 |
这里的“更可能”不是最终结论。Profiler 中的等待、垂直同步、帧率限制器和异步计算都可能改变表面数据,因此还需要通过一次可控实验确认。
用简单数据练习分类
下面的 Python 示例读取几组测量值,并用 1.5 ms 的差值作为教学用阈值,将它们分成 CPU 受限、GPU 受限或接近。真实项目不应该把这个阈值写死,而应结合采样波动和目标帧预算判断。
def classify(cpu_ms, gpu_ms, threshold_ms=1.5):
    diff = cpu_ms - gpu_ms
    if diff > threshold_ms:
        return "CPU-bound"
    if diff < -threshold_ms:
        return "GPU-bound"
    return "mixed"

samples = [
    (19.2, 11.4),
    (8.7, 17.9),
    (15.8, 16.3),
]

for cpu_ms, gpu_ms in samples:
    result = classify(cpu_ms, gpu_ms)
    print(f"cpu={cpu_ms:.1f} gpu={gpu_ms:.1f} -> {result}")
预期输出:
cpu=19.2 gpu=11.4 -> CPU-bound
gpu=17.9 cpu=8.7 -> GPU-bound
cpu=15.8 gpu=16.3 -> mixed
上面的第二行输出顺序应保持和程序格式一致,因此实际运行结果是:
cpu=19.2 gpu=11.4 -> CPU-bound
cpu=8.7 gpu=17.9 -> GPU-bound
cpu=15.8 gpu=16.3 -> mixed
用隔离实验验证判断
如果怀疑 GPU 受限,可以临时大幅降低渲染分辨率、阴影质量或远景材质复杂度。帧时间随之明显下降,说明 GPU 假设更可信;如果几乎没有变化,就应该重新检查 CPU 侧。
如果怀疑 CPU 受限,可以临时减少远景对象数量、关闭一批对象更新或显著降低 Draw Call。CPU Frame Time 明显下降而 GPU 变化很小,说明优化方向正确。
完成第一轮分类后,再进入更细的阶段:CPU 侧继续区分脚本、剔除、渲染提交与同步等待;GPU 侧继续区分顶点、像素、阴影和带宽。先确定是哪一侧受限,才能让后续 LOD 调整真正对应性能预算,而不是盲目减面。