
图形渲染与 Shader / 系统课时
HLOD 怎么做增量重建
HLOD 怎么做增量重建
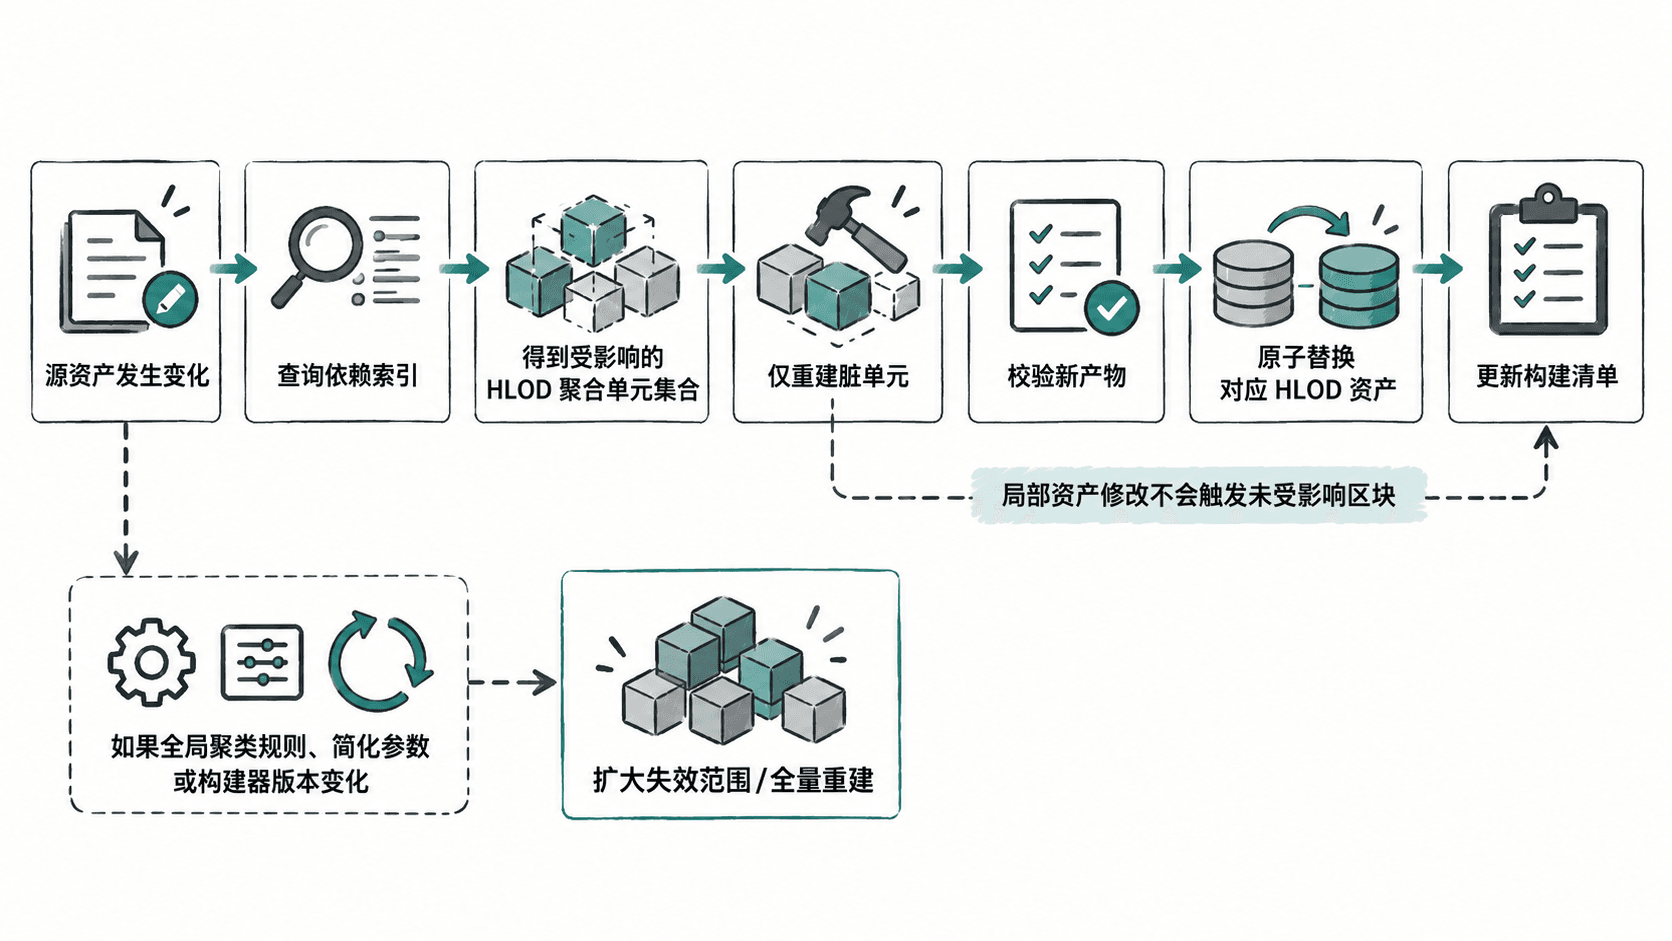
超大地图只改动一栋建筑或一个材质,却重新生成全部 HLOD,会把几分钟的小修改变成长时间构建。增量重建的核心不是简单跳过未修改文件,而是维护“源资产影响哪些 HLOD 聚合单元”的依赖关系,只把真正受影响的单元标记为脏并重新产出。
学习目标
- 建立源资产、空间分区与 HLOD 聚合单元之间的依赖关系
- 根据资产变更计算最小重建集合,并安全替换旧产物
- 识别会导致局部失效或全量失效的不同变更类型
先把重建单位固定下来
增量构建必须先有稳定的重建单位。大型地图通常按网格、区块、流式单元或其他空间分区生成 HLOD,每个聚合单元记录自己的源对象集合、构建参数和输出资产。只要这个边界稳定,某个源对象变化后就可以反查它属于哪些单元。
如果每次构建都根据临时遍历顺序重新聚类,同一个物体今天属于 cluster_17,明天又变成 cluster_42,依赖索引就无法可靠复用。聚类键应尽量由稳定的空间坐标、分区标识和规则版本生成,而不是依赖不稳定的数组下标。
用依赖索引计算脏单元
最简单的依赖索引可以理解为“源资产 ID → HLOD 单元 ID 集合”。模型、材质或静态对象发生变化后,先收集变更资产,再对这些资产关联的单元求并集。下面的示例演示这一计算过程。
asset_to_clusters = {
    "rock_a": {"cluster_01"},
    "rock_b": {"cluster_01", "cluster_02"},
    "house_x": {"cluster_07"},
    "material_roof": {"cluster_07", "cluster_08"},
}

changed_assets = {"rock_b", "material_roof"}

dirty_clusters = sorted({
    cluster
    for asset in changed_assets
    for cluster in asset_to_clusters.get(asset, set())
})

print("dirty=" + ",".join(dirty_clusters))
预期输出:
dirty=cluster_01,cluster_02,cluster_07,cluster_08这里没有变化的其他单元不会进入重建队列。实际工程中还应把对象的变换、网格内容、材质引用以及会影响简化结果的关键参数纳入依赖或内容哈希,否则文件名没变但内容已经变化时,系统可能错误复用旧 HLOD。
构建清单负责判断是否真的失效
仅依赖文件修改时间通常不够可靠。更稳妥的方式是为每个 HLOD 单元维护构建清单,至少保存源对象集合的稳定标识、相关内容哈希、构建规则版本和产物标识。下一次构建时重新计算输入摘要,只在摘要变化时把该单元标记为脏。
局部修改和全局规则修改要区别处理。某栋建筑的网格变化通常只影响包含它的少数单元;如果修改的是全局聚类尺寸、简化算法版本、材质合并规则或坐标划分方式,旧单元的输入语义已经改变,此时应扩大失效范围,必要时直接全量重建。
产物替换要避免半更新状态
脏单元生成完成后,不要边生成边覆盖当前正在使用的正式产物。更可靠的流程是先写入临时位置,完成模型、材质和引用完整性校验,再一次性替换对应单元并更新构建清单。这样即使某个单元构建失败,未受影响的旧 HLOD 仍然保持可用。
删除源对象同样必须进入增量流程。依赖索引要能够找到过去引用该对象的单元,让这些单元重新聚合;如果只扫描当前仍存在的资产,被删除对象对应的旧几何可能永远残留在 HLOD 产物里。
验证局部重建是否真的局部
验证时可以先修改一个只属于单一区块的静态对象,确认构建日志中的脏单元数量符合预期,并检查其他 HLOD 产物的时间戳或内容哈希保持不变。随后再修改被多个单元共享的材质,确认依赖传播能够覆盖所有引用者。
最后执行一次增量结果与全量重建结果的抽样或哈希比对。如果相同输入下两种流程长期产生不同结果,说明依赖声明、失效规则或构建确定性仍有缺口。只有局部修改能稳定得到与全量构建一致的目标产物,增量重建才真正适合进入大型地图的日常生产流程。