
图形渲染与 Shader / 系统课时
加载卡顿怎么拆分定位
加载卡顿怎么拆分定位
流式加载出现一帧明显停顿时,不能只看“加载耗时”这个总数。真正需要回答的是:时间花在读取、解压、反序列化、GPU 上传,还是主线程创建对象。把一次加载拆成阶段并分别计时,才能知道该优化磁盘吞吐、后台任务还是每帧提交预算。
学习目标
- 把一次流式加载拆成可观测的 IO、解压、反序列化、GPU 上传和运行时创建阶段
- 根据线程占用、耗时分布和帧尖峰判断真正瓶颈
- 用阶段统计而不是总加载时间验证优化是否有效
先把一次加载拆成阶段
大型场景中的资源通常不会从磁盘直接变成可渲染对象。一次加载至少可能经过磁盘或网络读取、压缩数据解码、资源结构反序列化、纹理或网格上传 GPU,以及在运行时创建实体、组件和渲染状态等阶段。
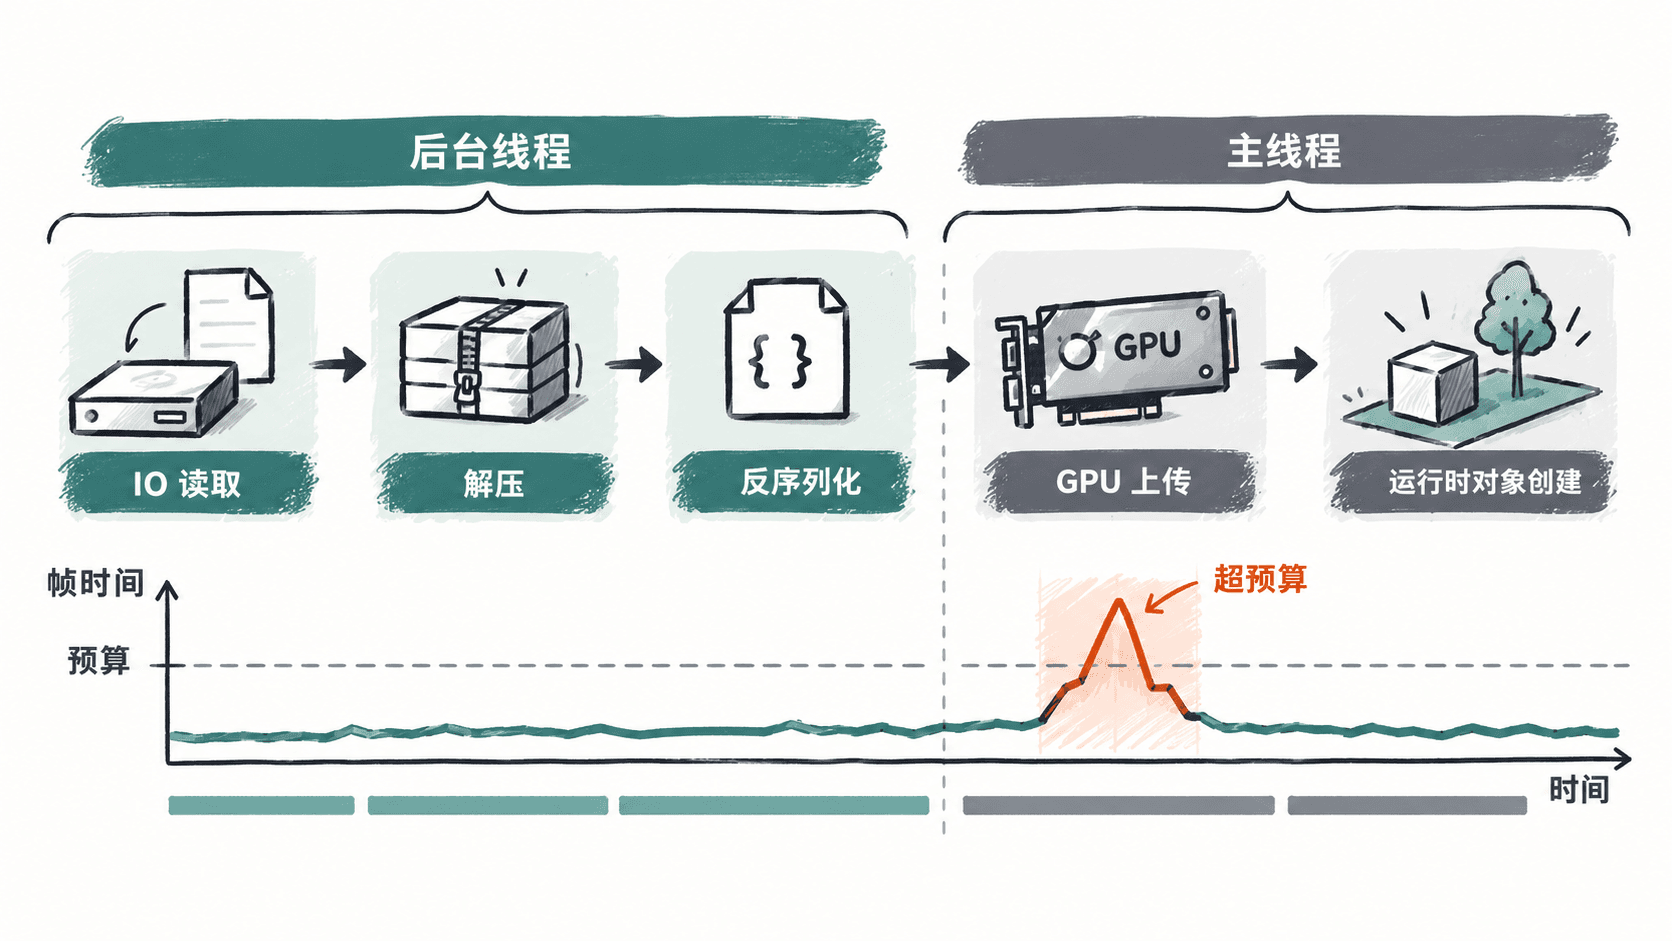
如果只记录“资源加载用了 42 ms”,你无法判断其中 35 ms 是否发生在后台线程,也无法知道真正阻塞渲染线程的也许只有最后 6 ms。定位时必须同时看阶段耗时和发生在哪个线程。
用数据区分五类尖峰
IO 瓶颈通常表现为读取等待时间高,但 CPU 占用并不持续打满;资源换到更快存储、增大顺序读取比例后会明显改善。若资源包较碎,大量小文件打开和随机读取也可能比实际数据传输更昂贵。
解压瓶颈更像纯 CPU 工作。读取很快结束,但工作线程持续执行压缩算法。此时降低资源压缩复杂度、让更多解压并行执行,或者减少同一帧触发的数据量,比盲目增加缓存更有效。
反序列化需要关注数据结构创建和引用解析。如果解析阶段产生大量临时对象,还可能伴随内存分配和垃圾回收。GPU 上传则常表现为 CPU 提交后等待图形资源就绪,尤其是大纹理、大网格集中进入显存时容易形成尖峰。
最后一种常被误判为“资源加载慢”:数据已经准备完成,但主线程在同一帧批量创建对象、注册组件、建立碰撞体或提交渲染资源。此时继续优化磁盘读取几乎没有意义,应限制每帧创建量。
给阶段计时而不是只看平均值
下面的 Python 示例模拟从采样日志中汇总五个加载阶段,并同时计算平均耗时和最大耗时。真实项目中可以让引擎 Profiler、自定义 Trace 或埋点输出同样的阶段记录,再用类似方式分析。
from collections import defaultdict
from statistics import mean

samples = [
    {"stage": "io", "ms": 2.3},
    {"stage": "decompress", "ms": 3.1},
    {"stage": "deserialize", "ms": 1.8},
    {"stage": "gpu_upload", "ms": 7.6},
    {"stage": "runtime_create", "ms": 4.2},
    {"stage": "io", "ms": 2.7},
    {"stage": "decompress", "ms": 3.4},
    {"stage": "deserialize", "ms": 1.6},
    {"stage": "gpu_upload", "ms": 11.8},
    {"stage": "runtime_create", "ms": 4.5},
]

groups = defaultdict(list)
for sample in samples:
    groups[sample["stage"]].append(sample["ms"])

for stage, values in groups.items():
    print(f"{stage:15} avg={mean(values):4.1f} ms max={max(values):4.1f} ms")
预期输出:
io              avg= 2.5 ms max= 2.7 ms
decompress      avg= 3.2 ms max= 3.4 ms
deserialize     avg= 1.7 ms max= 1.8 ms
gpu_upload      avg= 9.7 ms max=11.8 ms
runtime_create  avg= 4.3 ms max= 4.5 ms
这个样本里 IO 并不突出,真正值得优先检查的是 GPU 上传。尤其要关注 max 而不是只关注平均值,因为玩家看到的卡顿通常来自少量异常帧,而不是长期稳定的平均负载。
按定位结果选择修复方向
发现 IO 高时,应先检查是否存在大量随机读取、资源包过碎或同一时刻请求过多。解压高时检查压缩格式、任务并行度和单批资源大小;反序列化高时检查复杂对象图、临时分配以及是否能在后台完成更多解析工作。
GPU 上传尖峰适合用每帧字节预算或资源数量预算拆分。例如不要让 80 MB 纹理在一帧全部提交,而是让上传队列跨多帧推进。运行时创建同理,应把实例化、组件注册、碰撞初始化等主线程工作纳入帧预算。
验证时看尖峰是否真正消失
修复后不要只比较关卡总加载时间。应该在相同移动路线和相同资源集合下重新采样,比较主线程最长帧、各阶段最大耗时、单位时间 GPU 上传量和运行时创建数量。如果总加载时间略有增加,但单帧峰值从十几毫秒下降到稳定预算以内,这通常正是流式加载需要的结果。
定位加载卡顿的关键不是猜哪一步“应该最慢”,而是把流水线拆开测量,再把真正会阻塞帧推进的工作限制到每帧预算内。