
CI/CD / 系统课时
排查资源一直 Progressing
排查资源一直 Progressing
Argo CD 长时间显示 Progressing 时,问题通常不在 Git 是否同步,而在资源尚未达到 Kubernetes 的健康条件。本节按 Deployment、Pod、事件、镜像和探针逐层定位,让排查从状态现象落到具体失败原因。
学习目标
- 区分
Synced与Healthy,理解资源为何会长期处于Progressing - 按 Deployment、Pod 和 Event 的顺序定位发布阻塞点
- 识别镜像拉取、调度、就绪探针和 Service 配置等典型问题
先区分同步问题和健康问题
Argo CD 的同步状态回答“集群声明是否与 Git 一致”,健康状态回答“资源是否达到预期运行状态”。因此应用完全可能同时处于 Synced 和 Progressing:清单已经成功应用,但 Deployment 的新 Pod 还没有 Ready。
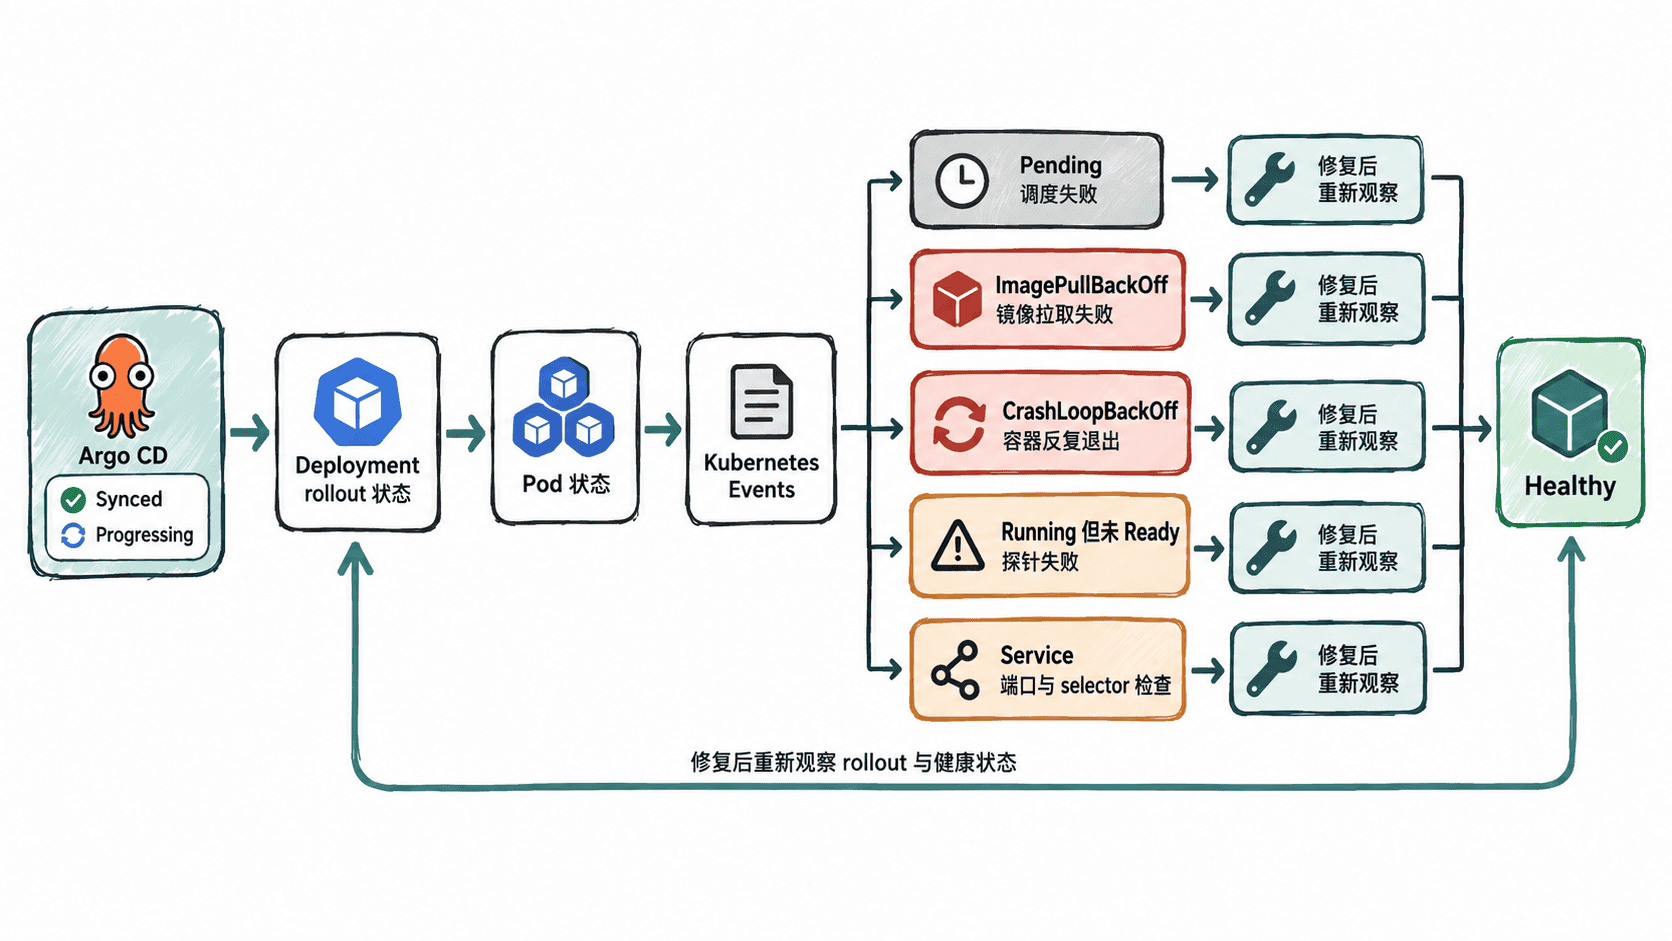
先从 Argo CD 确认应用层状态:
argocd app get demo典型现象可能是:
Sync Status: Synced
Health Status: Progressing
这意味着继续反复执行 Sync 往往没有帮助。下一步应该进入 Kubernetes 层检查资源为什么没有健康。
从 Deployment 找到阻塞的 Pod
先检查 Deployment 的 rollout 状态。以下命令假设资源位于 default 命名空间:
kubectl rollout status deployment/demo -n default --timeout=30s如果在 30 秒内仍没有完成,预期可能得到超时信息:
error: timed out waiting for the condition实际等待时间和消息可能因 Kubernetes 版本不同而变化。接着查看 Deployment 和 Pod,而不是继续等待:
kubectl get deployment demo -n default
kubectl get pods -n default -l app=demo
例如 Deployment 期望 3 个副本,但只有 2 个 Ready 时,输出可能类似:
NAME   READY   UP-TO-DATE   AVAILABLE   AGE
demo   2/3     3            2           <TIME>

NAME                    READY   STATUS    RESTARTS   AGE
demo-<ID>               1/1     Running   0          <TIME>
demo-<ID>               1/1     Running   0          <TIME>
demo-<ID>               0/1     Running   0          <TIME>
<TIME> 和 <ID> 是动态值。此时已经把“Argo CD 一直 Progressing”缩小成“一个 Pod 没有 Ready”。
用事件确定失败阶段
Pod 状态只是入口,Event 通常能更直接地说明调度、挂载、拉取镜像或探针发生了什么。先查看异常 Pod:
kubectl describe pod demo-<ID> -n default预期结果不是固定文本,应重点检查底部 Events。例如镜像名称或仓库凭据有问题时,可能出现 Failed、ErrImagePull 或 ImagePullBackOff;调度失败则可能看到 FailedScheduling。<ID> 应替换为实际 Pod 名称中的动态部分。
还可以按时间查看命名空间中的近期事件:
kubectl get events -n default --sort-by=.metadata.creationTimestamp预期输出是按创建时间排列的事件列表,具体对象和消息取决于现场。重点定位与目标 Deployment、ReplicaSet 和 Pod 对应的 Warning 事件,而不是从大量正常事件中猜测根因。
Running 但不 Ready 优先查探针
Pod 显示 Running 不代表应用已经可接流量。容器进程可能已经启动,但 readinessProbe 持续失败,Deployment 就无法获得足够的 Ready 副本,Argo CD 也可能继续显示 Progressing。
kubectl get pod demo-<ID> -n default -o jsonpath='{.status.containerStatuses[0].ready}{"\n"}'如果容器尚未通过就绪检查,预期输出:
false此时用 kubectl describe pod 检查探针失败事件,并核对探针的路径、端口、协议、初始等待时间以及应用实际监听地址。若应用启动较慢,不应简单删除探针,而应确认失败究竟来自启动时间不足还是探针配置错误。
镜像和容器退出要分别处理
ImagePullBackOff 表示容器甚至还没有正常启动,应检查镜像仓库地址、tag、镜像是否存在以及 imagePullSecrets。如果状态是 CrashLoopBackOff,则镜像通常已经成功拉取,重点应转向容器启动命令、配置、依赖和应用日志。
对于反复退出的容器,可以读取上一次实例的日志:
kubectl logs demo-<ID> -n default --previous预期输出取决于应用自身。若应用因缺少环境变量退出,应看到对应的应用错误,而不是固定的 Kubernetes 消息。这里的目标是取得真实失败证据,再回到 Helm values、Secret、ConfigMap 或应用配置修复声明。
修复后验证整条发布链路
修复应进入 Git,再让 Argo CD 应用新的声明。同步完成后重新验证 Deployment:
kubectl rollout status deployment/demo -n default --timeout=120s成功时预期输出类似:
deployment "demo" successfully rolled out最后再次执行 argocd app get demo,确认同步状态与健康状态都达到预期。排查 Progressing 的核心顺序是:先确认 Argo CD 是否已经同步,再从 Deployment 找异常 Pod,用 Event 判断失败阶段,最后针对镜像、调度、容器退出或探针修复根因;这样比重复 Sync 或重启 Pod 更容易得到可复现的结论。