
CI/CD / 系统课时
Argo CD 同步失败先看哪里
Argo CD 同步失败先看哪里
Argo CD 显示同步失败时,直接翻 Pod 日志往往会绕远路,因为故障可能发生在清单生成、资源提交或 Kubernetes 控制器处理阶段。本节建立固定定位顺序,用 Application 状态、Operation 信息、Events 和 Diff 快速判断失败层级。
学习目标
- 从 Application 状态判断同步异常的基本范围
- 区分渲染、同步执行和集群侧运行故障
- 使用 Argo CD、kubectl 与 Diff 信息验证定位结论
先判断失败发生在哪一层
GitOps 发布链路可以粗分为三段:Argo CD 先从 Git、Helm 或其他来源生成目标清单,再把资源同步到 Kubernetes API,最后由 Deployment、Job 等控制器让资源达到期望状态。
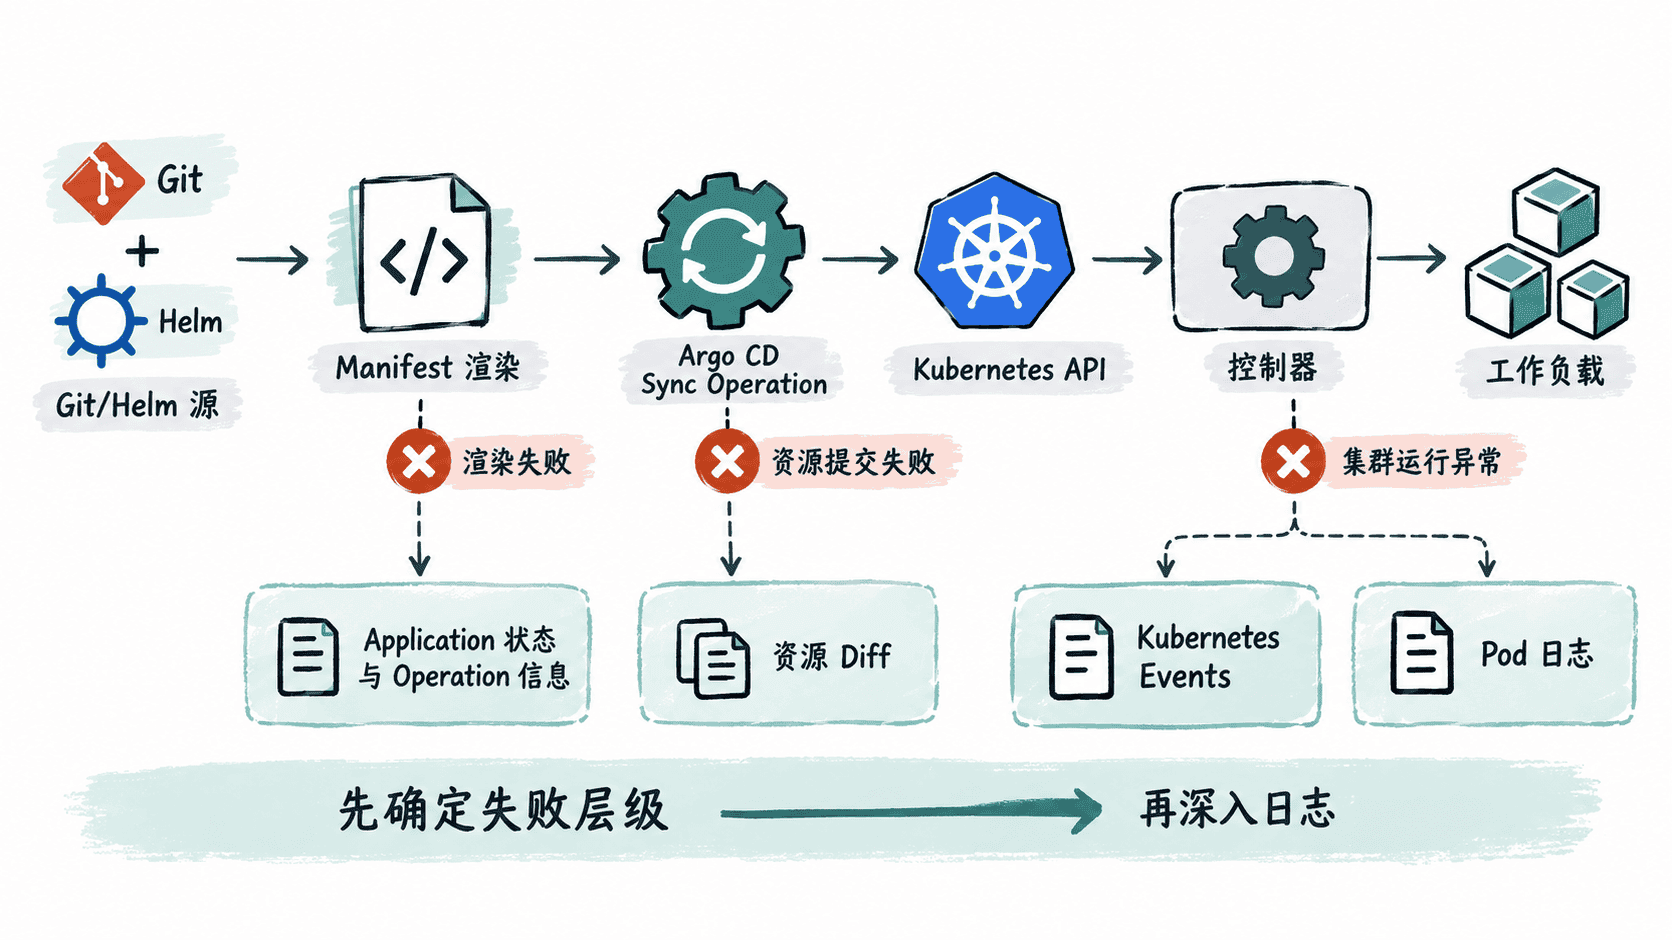
如果目标清单根本无法生成,问题通常在仓库访问、Helm values、模板或参数;如果清单已经生成但同步失败,应检查 Operation 中具体资源的错误;如果同步成功但资源 Degraded,则更可能是镜像拉取、探针、调度或应用启动等集群侧问题。
第一眼看 Application 状态
先获取应用整体状态,不要一开始就查询所有命名空间事件。
argocd app get my-app预期结果没有固定文本,因为 revision、资源状态和错误信息取决于现场。正常同步完成时,应重点确认应用呈现 Synced,并检查健康状态;失败现场则记录 Sync Status、Health Status、revision 以及 Operation 相关错误。实际值可能不同。
如果命令本身无法读取应用,应先处理 Argo CD 登录、权限或 Application 名称问题,这与业务资源同步失败不是同一层故障。
再看同步操作和资源差异
Application 只告诉你整体结果,真正有价值的是哪一个资源失败以及 API 返回了什么。可以先查看应用操作记录,再针对目标状态和集群状态检查差异。
argocd app history my-app
argocd app diff my-app预期结果取决于应用历史和当前漂移情况。history 应列出已有部署记录及 revision 等信息;存在差异时,diff 会展示目标清单与 live state 的差异,没有差异时不会得到需要修复的资源变更。
如果错误指向无效字段、不可变字段、准入策略拒绝或权限不足,故障已经落在同步执行阶段。此时继续重试同步通常不会改变结果,应先修复声明或集群策略冲突。
集群侧异常再查 Events
当资源已经提交到 Kubernetes,但 Deployment 长时间不健康时,再进入集群侧排查。先检查资源状态和事件,通常比直接读应用日志更快暴露调度、镜像和探针问题。
kubectl get deployment,pod -n <NAMESPACE>
kubectl get events -n <NAMESPACE> --sort-by=.metadata.creationTimestamp
预期输出中的 Pod 名称、时间和事件内容都是动态值。健康场景下 Deployment 应逐步达到期望副本数;故障场景可能出现 FailedScheduling、Failed 等事件原因,具体内容以集群实际返回为准。
只有事件已经把问题缩小到具体 Pod,或者容器已经启动但应用自身报错时,才继续使用 kubectl describe pod 和 kubectl logs。这样可以避免把 Helm 渲染错误误当成应用运行错误。
用固定顺序缩短定位路径
同步失败时可以保持同一条诊断路径:先看 Application 的 Sync 与 Health 状态,再检查最近一次 Operation 和失败资源;能生成目标清单后才分析 Diff,资源已经进入 Kubernetes 后再查看 Events,最后才深入 Pod 日志。
这个顺序的关键不是“多执行几个命令”,而是每一步都回答一个层级问题:目标清单能否生成、资源能否提交、控制器能否让资源运行。先确定故障发生在哪一段,再处理具体错误,才能避免在 Git、Argo CD 和 Kubernetes 三层之间反复跳转。