
CI/CD / 系统课时
Helm 渲染成功但应用起不来
Helm 渲染成功但应用起不来
helm template 能成功生成 YAML,只能证明模板语法和取值过程基本可用,并不代表 Kubernetes 能成功创建资源,更不代表 Pod 能进入 Ready。本篇沿 Deployment、Pod、ConfigMap 和 Secret 建立一条可重复的运行故障定位路径。
学习目标
- 区分 Helm 渲染成功、资源创建成功与应用可运行三个阶段
- 根据 Deployment 和 Pod 状态快速缩小故障范围
- 验证 ConfigMap、Secret 等运行依赖是否正确注入
先确定故障发生在哪一层
Helm 的职责主要是把 Chart、Values 和模板渲染成 Kubernetes manifests。渲染成功以后,资源还要经过 API Server 校验、控制器调谐、调度、镜像拉取、容器启动和健康检查。因此“渲染成功”只是发布链路前半段通过。
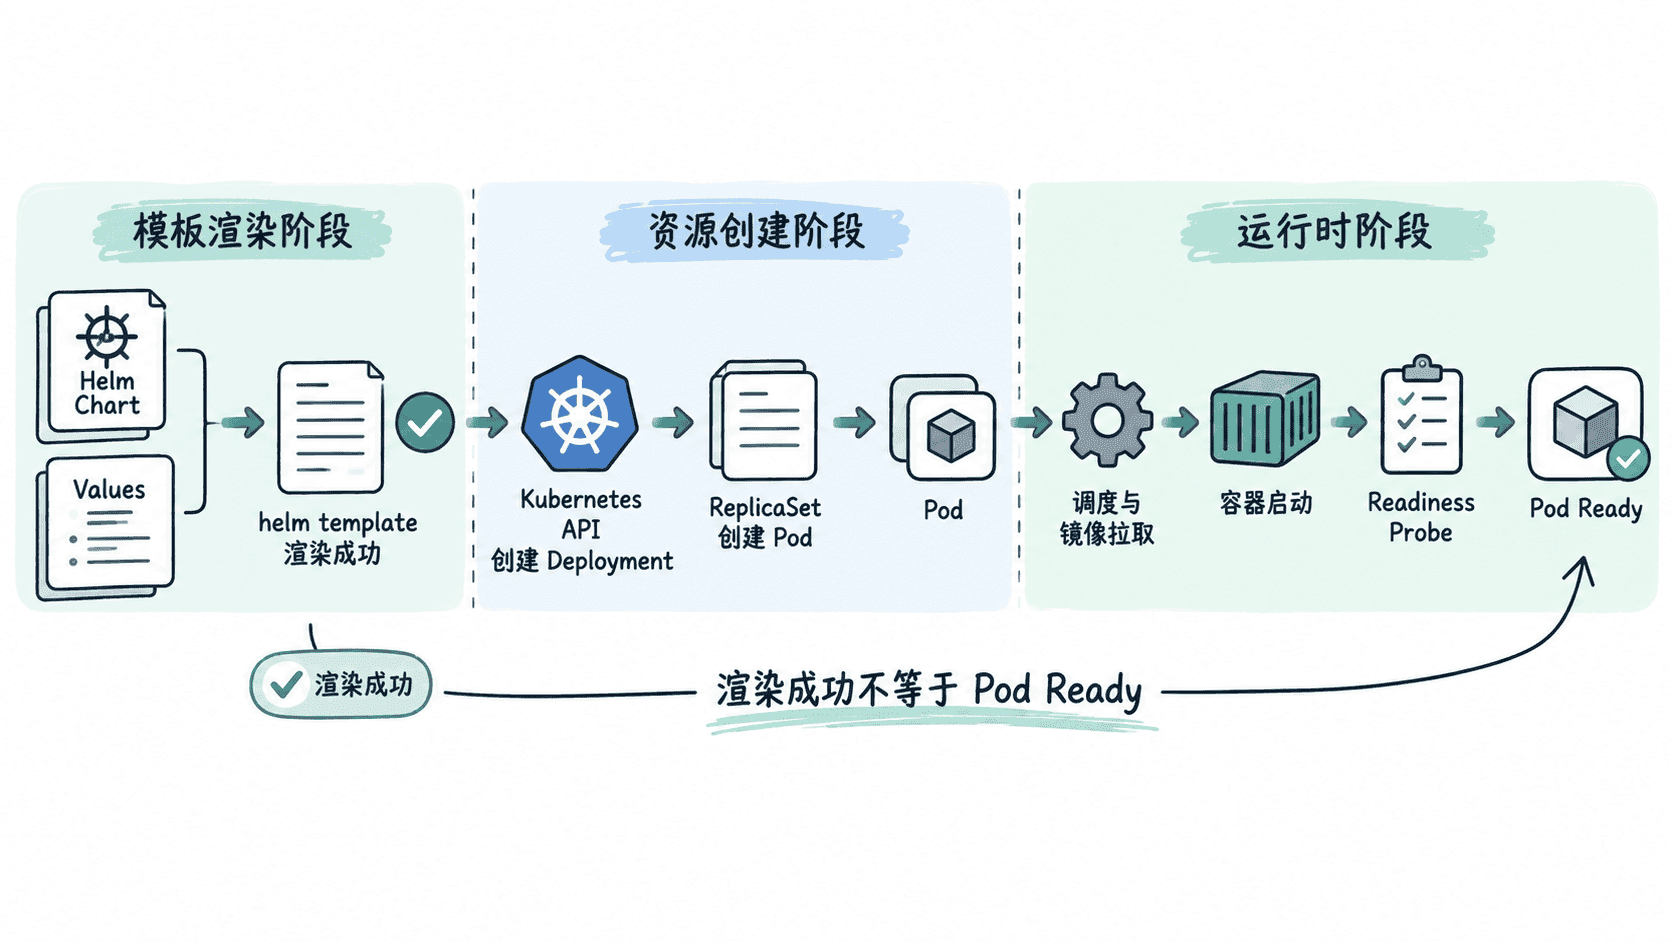
先查看 Deployment 和 Pod,而不是继续修改 Helm 模板:
kubectl get deployment,pod -n <NAMESPACE>
kubectl describe deployment <DEPLOYMENT> -n <NAMESPACE>
kubectl get events -n <NAMESPACE> --sort-by=.lastTimestamp
预期输出应至少能看到 Deployment 和 Pod 的实际状态;名称、时间和副本数以环境为准:
NAME                           READY   UP-TO-DATE   AVAILABLE
<DEPLOYMENT>                   0/1     1            0

NAME                           READY   STATUS             RESTARTS
<POD>                          0/1     CrashLoopBackOff   <ID>
这里的 CrashLoopBackOff 已经说明资源能够创建,问题应继续向容器运行阶段定位。如果根本没有 Pod,则优先检查 Deployment 的 Events、ReplicaSet 和资源定义。
从 Pod 状态选择下一条命令
不要只看 kubectl get pod 的一行状态。kubectl describe pod 会展示调度、挂载、探针和镜像等事件,容器已经启动过时还应查看日志:
kubectl describe pod <POD> -n <NAMESPACE>
kubectl logs <POD> -n <NAMESPACE> --all-containers=true
kubectl logs <POD> -n <NAMESPACE> --all-containers=true --previous
预期结果取决于故障类型。例如应用因缺少配置而退出时,日志可能明确指出某个配置项不存在;真实字段和文本由应用决定:
Error: required configuration <KEY> is missing--previous 对 CrashLoopBackOff 很重要,因为当前容器可能刚被重新创建,而真正的退出原因保留在上一实例日志中。若状态是 ImagePullBackOff,则应检查镜像地址和拉取凭据;若一直 Pending,则优先查看调度事件,而不是应用日志。
核对 ConfigMap 和 Secret 依赖
模板能够渲染出 configMapKeyRef 或 secretKeyRef,并不保证目标 Namespace 中对应对象和键真实存在。先从 Pod 定义确认引用关系,再检查对象:
kubectl get pod <POD> -n <NAMESPACE> -o yaml
kubectl get configmap <CONFIGMAP> -n <NAMESPACE> -o yaml
kubectl get secret <SECRET> -n <NAMESPACE>
预期结果是 Pod 引用的 ConfigMap 和 Secret 都能在同一 Namespace 找到;Secret 的敏感值无需为排障直接输出:
NAME         DATA   AGE
<SECRET>     <ID>   <TIME>
如果事件出现 configmap not found、secret not found 或某个 key 缺失,应回查 Chart 中对象名称是否受 fullnameOverride、Release 名称或 Values 条件控制。还要确认资源没有因为 enabled: false 一类条件而根本未被渲染。
把运行问题重新映射到 Helm 输入
找到 Kubernetes 层面的直接原因后,再回到 Helm 验证最终 manifests。这样可以避免凭感觉修改 Values:
helm template <RELEASE> <CHART_PATH> -n <NAMESPACE> -f <VALUES_PATH> > <PATH>
kubectl apply --dry-run=server -f <PATH>
预期输出在服务端校验通过时会显示资源被 dry-run 处理,具体资源名取决于 Chart:
deployment.apps/<DEPLOYMENT> configured (server dry run)helm template 用于检查最终渲染结果,--dry-run=server 则进一步让 API Server 按集群能力验证资源,但它仍不能证明镜像能够启动、外部依赖可连接或健康检查会通过。
排查这类故障时,应始终沿“渲染结果 → Deployment/ReplicaSet → Pod 事件 → 容器日志 → ConfigMap/Secret → Values”收敛。先确定失败层级,再修改 Chart,通常比反复重装 Release 更快找到根因。