
CI/CD / 系统课时
GitOps 到底解决哪些部署问题
GitOps 到底解决哪些部署问题
手工执行 kubectl 或发布脚本可以完成部署,但随着环境和人员增加,集群实际状态、配置来源与变更记录很容易分离。GitOps 的核心是把 Git 中声明的期望状态作为基准,由控制器持续对账并修正偏差,让发布、审计和回滚围绕同一份版本化配置进行。
学习目标
- 理解手工发布在状态一致性和审计上的主要问题
- 解释期望状态、持续对账和漂移修正之间的关系
- 判断 GitOps 能解决什么,以及它不能替代什么
从手工发布的问题开始
传统发布常由工程师在本机执行命令,例如修改镜像版本后直接更新 Deployment:
kubectl set image deployment/web web=example/web:1.4.0 -n production
kubectl get deployment/web -n production -o jsonpath='{.spec.template.spec.containers[0].image}'
预期输出:
example/web:1.4.0这次操作本身没有问题,但 Git 仓库中的清单可能仍写着旧版本。之后另一名工程师重新应用仓库配置,就可能把集群恢复到旧状态。更棘手的是,仅查看 Git 历史无法解释这次集群变更是谁、何时、为什么执行的。
GitOps 把部署改成持续对账
GitOps 不只是“用 Git 保存 YAML”。关键变化是:Git 保存期望状态,控制器读取期望状态并持续与集群实际状态比较。发现差异后,根据配置自动同步,或先报告差异等待人工确认。
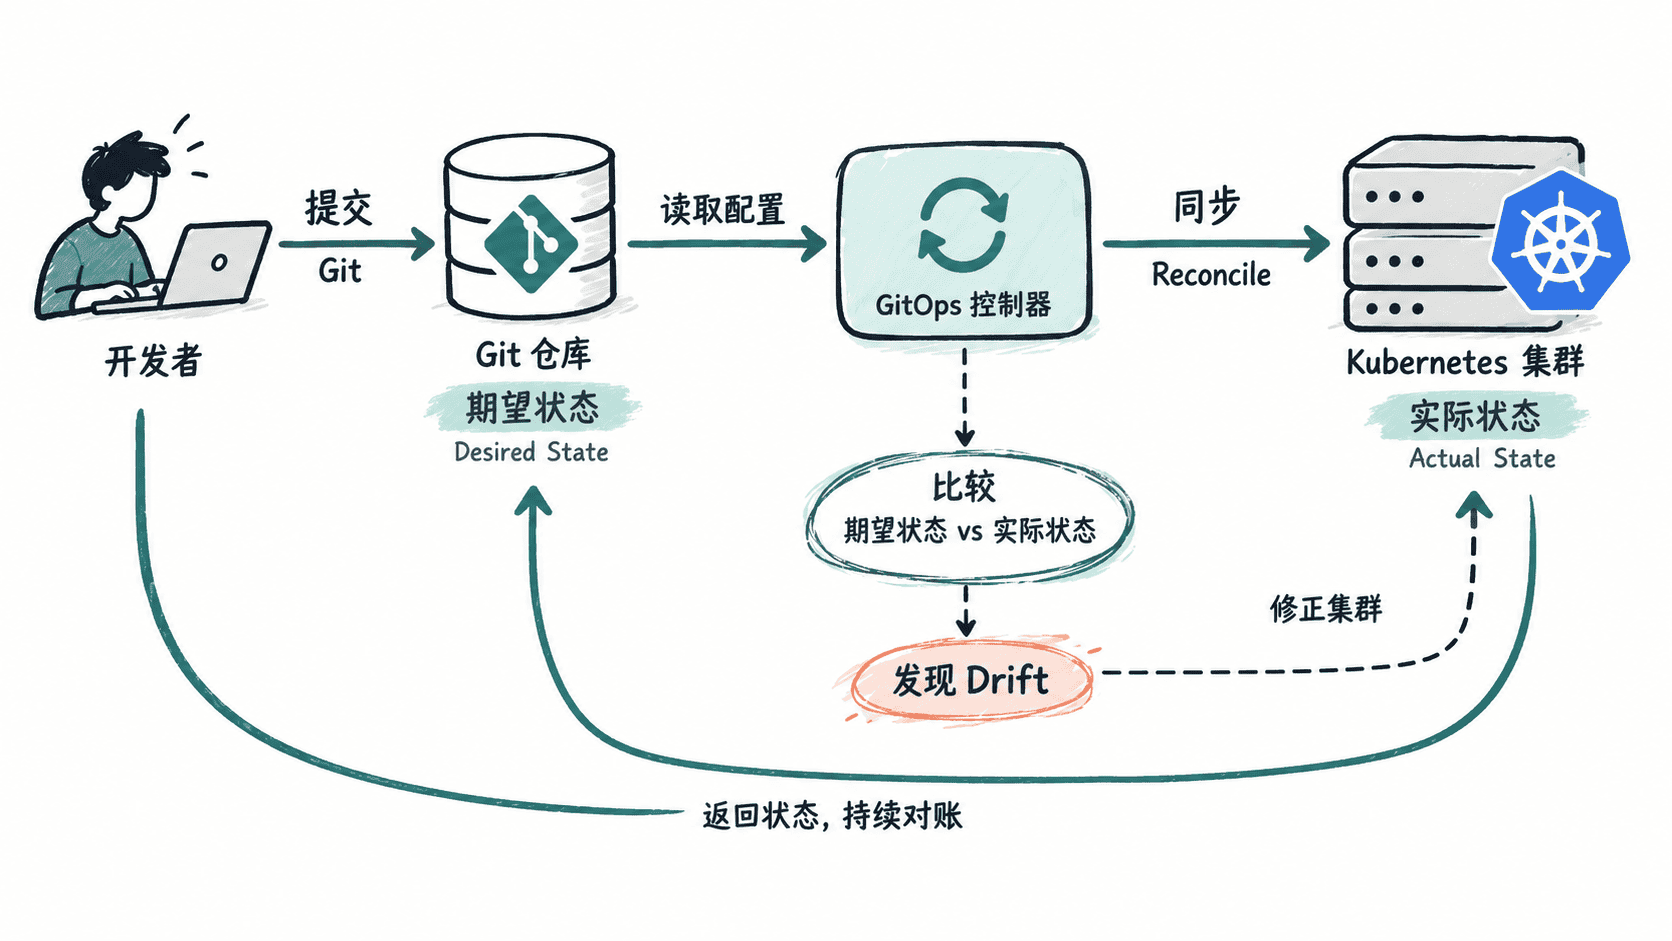
因此部署链路从“人在终端主动把配置推入集群”,转为“人修改 Git 中的声明,控制器主动把集群拉回声明状态”。即使有人临时修改集群,也能检测出这种漂移。
审计和回滚为什么更清楚
当生产变更必须先进入 Git,提交记录、Pull Request 和代码评审就能形成变更轨迹。需要回退时,通常不是寻找某台机器上的旧脚本,而是恢复 Git 中已知可用的声明版本,再让控制器重新对账。
这里要区分配置回滚与业务数据回滚。Git 可以恢复 Deployment、Service 或 Helm values 的历史版本,却不会自动撤销数据库迁移、消息消费或外部系统已经产生的副作用。涉及数据结构变化时,仍需单独设计向前兼容或数据恢复方案。
GitOps 的边界
GitOps 主要解决声明式资源的版本化、同步、漂移检测和审计问题,并不意味着所有运维动作都必须塞进 Git。临时诊断、数据库备份恢复、密钥生命周期和事故处置仍可能需要专门系统与流程。
判断一个流程是否适合 GitOps,可以先问:目标状态能否声明化、是否值得版本控制、是否能由控制器安全重复执行。如果答案基本为是,持续对账通常比依赖人工命令更容易保持环境一致。