
Web 图形与 3D / 系统课时
减少纹理采样与高成本分支
减少纹理采样与高成本分支
全屏 Shader 出现卡顿时,先排查每个片元重复读取多少纹理、循环执行多少次,以及分支是否让相邻像素走不同路径。本课用 WebGL2 把一次 5×5 高斯模糊改成水平、垂直两个 Pass,并对照输出像素和 GPU 时间,判断优化是否真正有效。
学习目标
- 估算纹理采样次数、迭代次数与全屏像素数的关系。
- 实现二维高斯模糊到两次一维采样的改写,并检查输出误差。
- 区分统一分支与逐像素分支,使用 GPU 查询逐项验证收益。
先固定比较条件
选择同一张 512×512 的 RGBA8 输入纹理,使用 NEAREST 采样、CLAMP_TO_EDGE 边界模式和相同的五点权重。一次只修改一种因素:采样路径、循环层数或分支策略,不能同时降低分辨率、缩小模糊半径后再声称算法更快。
一次 5×5 邻域卷积每个输出像素执行 25 次 texture();512×512 共发起 6,553,600 次采样调用。改为水平 5 次、垂直 5 次的两个全屏 Pass,总计约 2,621,440 次采样调用,但会增加一次临时纹理写入、一次读取路径及额外绘制提交。
采样调用数不等于显存读取次数,也不能直接换算成帧率;纹理缓存、带宽、Render Target 切换和屏幕分辨率都会影响结果。
把二维卷积拆成两个方向
采用权重 1, 4, 6, 4, 1,归一化因子为 16。二维 5×5 核是这组权重与自身的外积,总归一化因子为 256。因此先水平加权并除以 16,再对中间纹理垂直加权并除以 16,可得到同一模糊核;RGBA8 中间结果的量化会造成小幅误差。
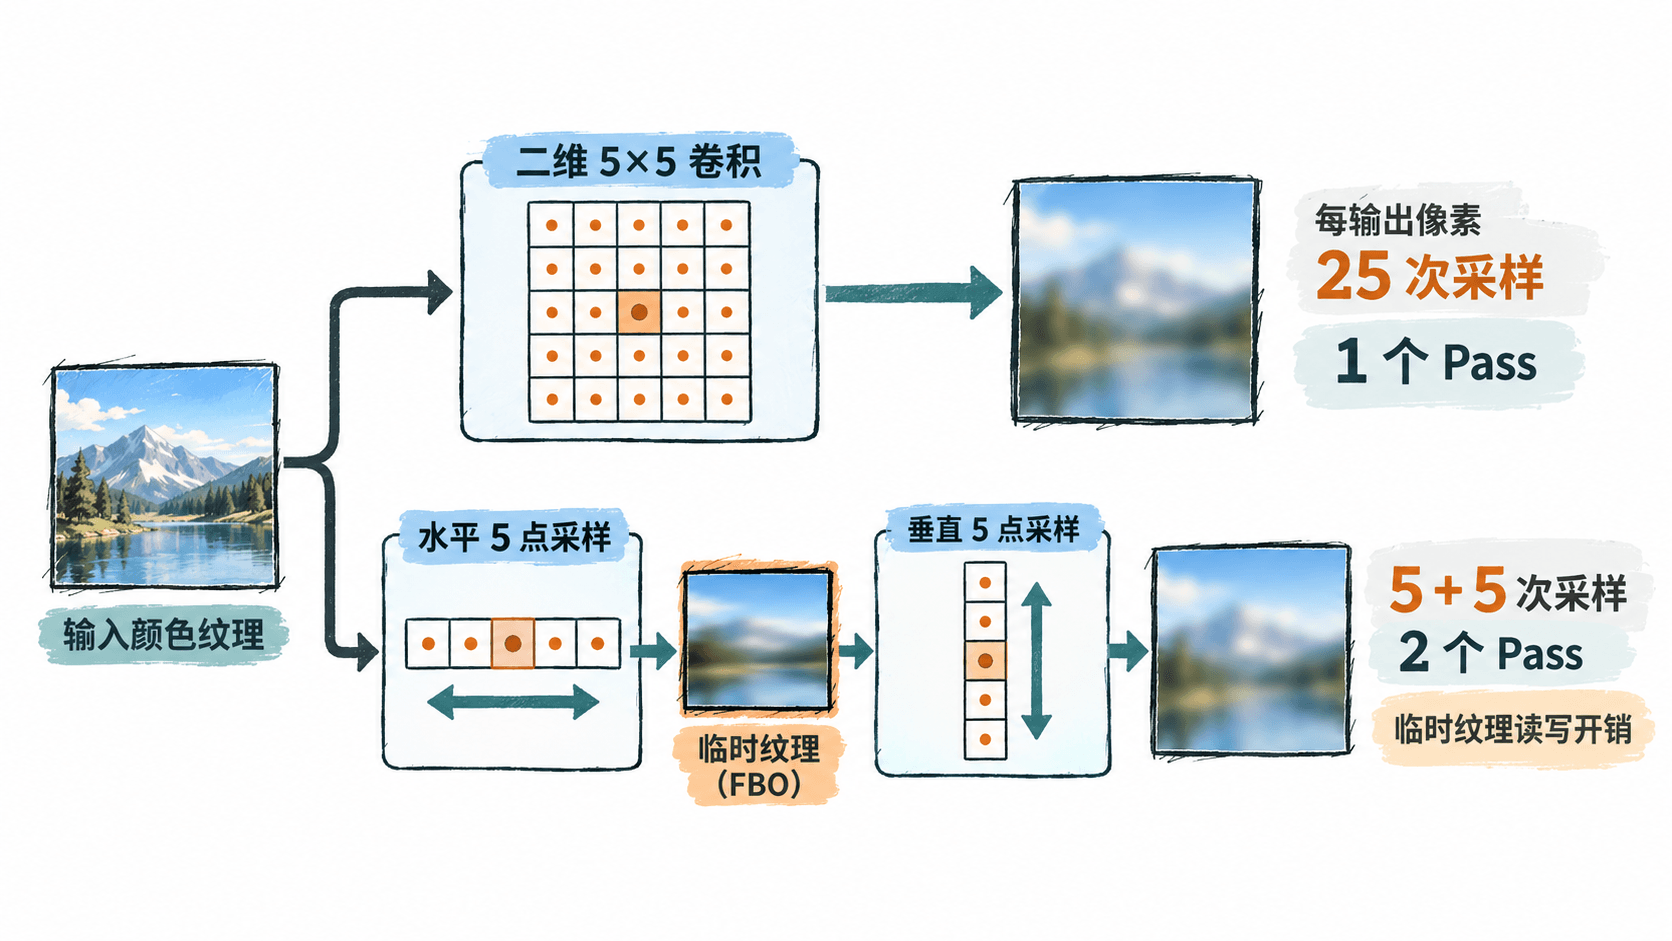
这次优化的代价是多一个 Pass。如果滤镜只有 3×3,直接卷积是 9 次采样,而分离后是 3+3 次,额外 Pass 可能抵消节省;模糊核越大,分离处理通常越值得测试。
运行对照实验
将以下完整内容保存为 blur.html,用支持 WebGL2 的浏览器打开,按 F12 查看 Console。程序分别创建直接卷积与分离卷积 Shader,用同一张棋盘渐变纹理绘制至三个 FBO;随后读回像素比较,并在扩展可用时测量 GPU 绘制时间。
<!doctype html>
<meta charset="utf-8">
<title>WebGL2 模糊采样对比</title>
<canvas id="c" width="512" height="512"></canvas>
<script>
(async () => {
  const N = 512;
  const gl = document.querySelector('#c').getContext('webgl2', {antialias: false});
  if (!gl) throw new Error('浏览器未提供 WebGL2');
  const vertex = `#version 300 es
void main() {
  vec2 p = vec2(float((gl_VertexID << 1) & 2), float(gl_VertexID & 2));
  gl_Position = vec4(p * 2.0 - 1.0, 0.0, 1.0);
}`;
  const header = `#version 300 es
precision highp float;
uniform sampler2D uTex;
out vec4 fragColor;
void main() {
  float w[5] = float[5](1.0, 4.0, 6.0, 4.0, 1.0);
  vec2 uv = gl_FragCoord.xy / 512.0;
  vec4 sum = vec4(0.0);
`;
  // 为二维卷积和两个一维 Pass 分别编译 Shader,避免按片元切换算法。
  const loops = {
    full: `for (int y = -2; y <= 2; ++y)
      for (int x = -2; x <= 2; ++x)
        sum += w[x+2] * w[y+2] * texture(uTex, uv + vec2(float(x), float(y)) / 512.0);`,
    horiz: `for (int x = -2; x <= 2; ++x)
      sum += w[x+2] * texture(uTex, uv + vec2(float(x), 0.0) / 512.0);`,
    vert: `for (int y = -2; y <= 2; ++y)
      sum += w[y+2] * texture(uTex, uv + vec2(0.0, float(y)) / 512.0);`
  };
  function program(mode) {
    const compile = (type, source) => {
      const s = gl.createShader(type);
      gl.shaderSource(s, source);
      gl.compileShader(s);
      if (!gl.getShaderParameter(s, gl.COMPILE_STATUS)) throw new Error(gl.getShaderInfoLog(s));
      return s;
    };
    const p = gl.createProgram();
    gl.attachShader(p, compile(gl.VERTEX_SHADER, vertex));
    gl.attachShader(p, compile(gl.FRAGMENT_SHADER,
      header + loops[mode] + `\nfragColor = sum / ${mode === 'full' ? '256.0' : '16.0'};\n}`));
    gl.linkProgram(p);
    if (!gl.getProgramParameter(p, gl.LINK_STATUS)) throw new Error(gl.getProgramInfoLog(p));
    return p;
  }
  function texture(data) {
    const t = gl.createTexture();
    gl.bindTexture(gl.TEXTURE_2D, t);
    gl.texParameteri(gl.TEXTURE_2D, gl.TEXTURE_MIN_FILTER, gl.NEAREST);
    gl.texParameteri(gl.TEXTURE_2D, gl.TEXTURE_MAG_FILTER, gl.NEAREST);
    gl.texParameteri(gl.TEXTURE_2D, gl.TEXTURE_WRAP_S, gl.CLAMP_TO_EDGE);
    gl.texParameteri(gl.TEXTURE_2D, gl.TEXTURE_WRAP_T, gl.CLAMP_TO_EDGE);
    gl.texImage2D(gl.TEXTURE_2D, 0, gl.RGBA8, N, N, 0, gl.RGBA, gl.UNSIGNED_BYTE, data);
    return t;
  }
  function target() {
    const tex = texture(null), fb = gl.createFramebuffer();
    gl.bindFramebuffer(gl.FRAMEBUFFER, fb);
    gl.framebufferTexture2D(gl.FRAMEBUFFER, gl.COLOR_ATTACHMENT0, gl.TEXTURE_2D, tex, 0);
    if (gl.checkFramebufferStatus(gl.FRAMEBUFFER) !== gl.FRAMEBUFFER_COMPLETE) throw new Error('FBO 不完整');
    return {tex, fb};
  }
  // 测试图案同时覆盖锐利边界和连续色阶。
  const data = new Uint8Array(N * N * 4);
  for (let y = 0; y < N; ++y) for (let x = 0; x < N; ++x) {
    const i = (y * N + x) * 4;
    data[i] = ((x >> 4) ^ (y >> 4)) & 1 ? 255 : 10;
    data[i + 1] = x * 255 / (N - 1);
    data[i + 2] = y * 255 / (N - 1);
    data[i + 3] = 255;
  }
  const src = texture(data), direct = target(), tmp = target(), result = target();
  const [pFull, pH, pV] = ['full', 'horiz', 'vert'].map(program);
  gl.bindVertexArray(gl.createVertexArray());
  gl.disable(gl.BLEND);
  gl.disable(gl.DEPTH_TEST);
  function draw(p, input, output) {
    gl.bindFramebuffer(gl.FRAMEBUFFER, output.fb);
    gl.viewport(0, 0, N, N);
    gl.useProgram(p);
    gl.activeTexture(gl.TEXTURE0);
    gl.bindTexture(gl.TEXTURE_2D, input);
    gl.uniform1i(gl.getUniformLocation(p, 'uTex'), 0);
    gl.drawArrays(gl.TRIANGLES, 0, 3);
  }
  const doFull = () => draw(pFull, src, direct);
  const doSep = () => { draw(pH, src, tmp); draw(pV, tmp.tex, result); };
  doFull();
  doSep();
  function pixels(fb) {
    const out = new Uint8Array(N * N * 4);
    gl.bindFramebuffer(gl.FRAMEBUFFER, fb);
    gl.readPixels(0, 0, N, N, gl.RGBA, gl.UNSIGNED_BYTE, out);
    return out;
  }
  // 读回 RGBA8 对比结果,容许中间纹理量化引入的微小误差。
  const a = pixels(direct.fb), b = pixels(result.fb);
  let maxDiff = 0;
  for (let i = 0; i < a.length; ++i) maxDiff = Math.max(maxDiff, Math.abs(a[i] - b[i]));
  console.log('采样次数:25 与 5+5');
  console.log('最大通道误差<=3:', maxDiff <= 3);
  // 计时只覆盖绘制,不包含 Shader 编译和纹理上传。
  const ext = gl.getExtension('EXT_disjoint_timer_query_webgl2');
  if (ext) {
    for (let i = 0; i < 5; ++i) { doFull(); doSep(); } // 预热 shader 和纹理
    gl.finish();
    async function measure(run) {
      const q = gl.createQuery();
      gl.beginQuery(ext.TIME_ELAPSED_EXT, q);
      for (let i = 0; i < 30; ++i) run();
      gl.endQuery(ext.TIME_ELAPSED_EXT);
      gl.flush();
      await new Promise(resolve => {
        const poll = () => gl.getQueryParameter(q, gl.QUERY_RESULT_AVAILABLE)
          ? resolve() : requestAnimationFrame(poll);
        poll();
      });
      const ms = gl.getParameter(ext.GPU_DISJOINT_EXT) ? null
        : gl.getQueryParameter(q, gl.QUERY_RESULT) / 30e6;
      gl.deleteQuery(q);
      return ms;
    }
    const t0 = await measure(doFull), t1 = await measure(doSep);
    console.log(t0 === null || t1 === null ? 'GPU 计时无效,需重测'
      : `GPU均时:直接 ${t0.toFixed(3)}ms,分离 ${t1.toFixed(3)}ms`);
  } else {
    console.log('浏览器未提供 GPU 计时扩展');
  }
  gl.bindFramebuffer(gl.READ_FRAMEBUFFER, result.fb);
  gl.bindFramebuffer(gl.DRAW_FRAMEBUFFER, null);
  gl.blitFramebuffer(0, 0, N, N, 0, 0, N, N, gl.COLOR_BUFFER_BIT, gl.NEAREST);
})();
</script>
预期输出(支持 GPU 计时扩展时,<TIME> 是随设备变化的毫秒数):
采样次数:25 与 5+5
最大通道误差<=3: true
GPU均时:直接 <TIME>ms,分离 <TIME>ms
页面还会显示分离模糊后的画面。如果不支持扩展,第三行是 浏览器未提供 GPU 计时扩展;如果计时期间 GPU 发生 disjoint,第三行是 GPU 计时无效,需重测。两次绘制的颜色允许存在极小整数误差,true 表示最大单通道差不超过 3,而不是两张纹理逐字节一致。
限制迭代与高成本分支
噪声叠加、射线步进和滤镜循环也需按单像素计算工作量。例如某噪声效果每层要采样纹理 4 次,6 层就是每像素 24 次;将层数改为 4 层后是 16 次,但高频细节会减少。先比较 6 层与 4 层的相同画面,再检查轮廓、闪烁和低对比度区域,不能只比较平均 FPS。
if (uQuality == 0) 这类由整次 Draw 共享的 uniform 条件通常不会产生相邻片元的分歧;if (mask > 0.5) 若随像素变化,则可能让同一执行组分别处理两条昂贵路径。稳定的质量档位可由 JavaScript 预先选定不同 Shader 程序,像上例的三个程序一样,不必让每个片元判断当前 Pass。
用 GPU 时间验收
示例先预热 5 组,再分别以 GPU 查询计时 30 组:直接方案每组 1 个 Pass,分离方案每组 2 个 Pass。EXT_disjoint_timer_query_webgl2 的查询结果以纳秒计,代码换算为每组毫秒,并在 GPU_DISJOINT_EXT 为真时放弃该次结果;浏览器未提供扩展时不要把 JavaScript 提交 drawArrays() 的时间当成 GPU 执行时间。
正式排障时,在目标手机或显卡上重复至少 5 轮,交替测量两种路径,记录中位数,并同时检查 maxDiff 和画面。建议把优化前后分辨率、纹理格式、Pass 数和设备型号记在一行记录中。只有画质达到需求且整条后处理链的 GPU 时间稳定下降,才保留改写;如果额外的中间纹理开销更大,就保留直接卷积或尝试降采样后再模糊。