
Web 图形与 3D / 系统课时
用计时和帧率定位 GPU 瓶颈
用计时和帧率定位 GPU 瓶颈
画面掉到 30 FPS 时,单看帧率无法判断瓶颈来自 JavaScript、绘制调用,还是片元着色器。本课将同时记录帧间隔、Three.js 绘制统计和 WebGL2 GPU 耗时,再通过降低分辨率验证推断,避免凭感觉删减 Shader 效果。
学习目标
- 区分帧间隔、CPU 渲染提交耗时与 GPU 执行耗时。
- 使用异步 GPU 查询及
renderer.info获取可对照的指标。 - 根据测量结果设计一次只改变一个变量的排障实验。
先确认帧预算和测量范围
60 FPS 对应平均每帧约 16.67 ms,30 FPS 约 33.33 ms,120 FPS 约 8.33 ms。requestAnimationFrame 两次回调的时间差叫帧间隔,包含浏览器调度和垂直同步等待,不能直接视作 GPU 渲染耗时。除了平均 FPS,建议记录最近 120 帧间隔的 P95,找出偶发慢帧。
| 指标 | 采集方式 | 能说明什么 |
|---|---|---|
| 帧间隔 P95 | 相邻 requestAnimationFrame 时间戳 |
用户可感知的帧节奏是否稳定 |
| CPU 提交时间 | performance.now() 包围 renderer.render() |
场景处理和渲染命令提交在 CPU 上用了多久 |
| Draw calls、三角形数 | renderer.info.render.calls、triangles |
场景提交规模;数量高不等于必然卡顿 |
| GPU 耗时 | EXT_disjoint_timer_query_webgl2 |
被查询区间内的 GPU 命令耗时,不包括浏览器最终显示耗时 |
先保持窗口尺寸、渲染像素比例、相机和特效配置不变;后台标签页通常会限速,不能拿它测正常帧率。
用 WebGL2 异步查询记录数据
下面示例适用于 Three.js r180(three@0.180.0)和支持 WebGL2 的浏览器。保存为 index.html,在文件目录运行 python3 -m http.server 8000(Windows 可用 py -m http.server 8000),打开 http://localhost:8000/,按 F12 查看 Console。首次 Shader 编译可能较慢,先运行数秒再读数。
<!doctype html>
<html lang="zh-CN">
<head><meta charset="utf-8"><title>GPU 计时实验</title></head>
<body style="margin:0;overflow:hidden">
<script type="module">
import * as THREE from "https://cdn.jsdelivr.net/npm/three@0.180.0/build/three.module.js";

const renderer = new THREE.WebGLRenderer({ antialias: false });
const scale = new URLSearchParams(location.search).get("scale") === "0.5" ? 0.5 : 1;
renderer.setPixelRatio(scale); // URL 参数用于只改变物理渲染像素数
document.body.appendChild(renderer.domElement);
function resize() { renderer.setSize(innerWidth, innerHeight); }
addEventListener("resize", resize);
resize();

const scene = new THREE.Scene();
const camera = new THREE.OrthographicCamera(-1, 1, 1, -1, 0, 1);
const material = new THREE.ShaderMaterial({
  glslVersion: THREE.GLSL3,
  uniforms: { uTime: { value: 0 } },
  vertexShader: `out vec2 vUv;
    void main() { vUv = uv; gl_Position = vec4(position, 1.0); }`,
  fragmentShader: `precision highp float;
    in vec2 vUv; uniform float uTime; out vec4 fragColor;
    void main() {
      float wave = 0.0;
      for (int i = 1; i <= 24; i++) {
        wave += sin(vUv.x * float(i) * 5.0 + uTime) * 0.01;
      }
      fragColor = vec4(0.3 + wave, vUv.y * 0.7, 0.6, 1.0);
    }`
});
scene.add(new THREE.Mesh(new THREE.PlaneGeometry(2, 2), material));

const gl = renderer.getContext();
const ext = gl.getExtension("EXT_disjoint_timer_query_webgl2");
const gaps = [], cpuSamples = [];
let previous = 0, frame = 0, pending = null, gpuMs = null;
const mean = values => values.reduce((sum, v) => sum + v, 0) / values.length;

function tick(now) {
  if (previous) {
    gaps.push(now - previous);
    if (gaps.length > 120) gaps.shift();
  }
  previous = now;

  // GPU 查询必须跨帧轮询;结果未就绪时绝不阻塞等待。
  if (pending) {
    const disjoint = gl.getParameter(ext.GPU_DISJOINT_EXT);
    const available = gl.getQueryParameter(pending, gl.QUERY_RESULT_AVAILABLE);
    if (available && !disjoint) {
      gpuMs = gl.getQueryParameter(pending, gl.QUERY_RESULT) / 1e6;
    }
    if (available || disjoint) {
      gl.deleteQuery(pending);
      pending = null;
      if (disjoint) gpuMs = null;
    }
  }

  const query = ext && !pending && frame % 30 === 0 ? gl.createQuery() : null;
  if (query) gl.beginQuery(ext.TIME_ELAPSED_EXT, query);
  material.uniforms.uTime.value = now / 1000;
  const start = performance.now();
  renderer.render(scene, camera);
  const cpuMs = performance.now() - start;
  if (query) {
    gl.endQuery(ext.TIME_ELAPSED_EXT);
    pending = query;
  }
  cpuSamples.push(cpuMs);
  if (cpuSamples.length > 120) cpuSamples.shift();

  if (frame > 0 && frame % 120 === 0 && gaps.length) {
    const ordered = [...gaps].sort((a, b) => a - b);
    const p95 = ordered[Math.ceil(ordered.length * 0.95) - 1];
    const gpu = !ext ? "不支持" : gpuMs === null ? "等待结果" : `${gpuMs.toFixed(2)}ms`;
    console.log(`FPS≈${(1000 / mean(gaps)).toFixed(1)} | P95=${p95.toFixed(1)}ms | CPU提交=${mean(cpuSamples).toFixed(2)}ms | calls=${renderer.info.render.calls} | triangles=${renderer.info.render.triangles} | GPU=${gpu}`);
  }
  frame++;
  requestAnimationFrame(tick);
}
requestAnimationFrame(tick);
</script>
</body>
</html>
预期结果:画布显示随时间变化的彩色条纹,控制台每约 120 帧打印一行;一张全屏平面通常产生 1 次 Draw Call、2 个三角形。以下 <FPS>、<MS> 表示设备相关的实际读数,不是固定性能承诺。
FPS≈<FPS> | P95=<MS>ms | CPU提交=<MS>ms | calls=1 | triangles=2 | GPU=<MS>ms扩展不存在时,输出中的 GPU=不支持 属于正常降级。查询返回的是纳秒,除以 1e6 才是毫秒;必须等 QUERY_RESULT_AVAILABLE 为真且 GPU_DISJOINT_EXT 为假后再使用,不能用 gl.finish() 强制同步。
对照三个指标判断瓶颈位置
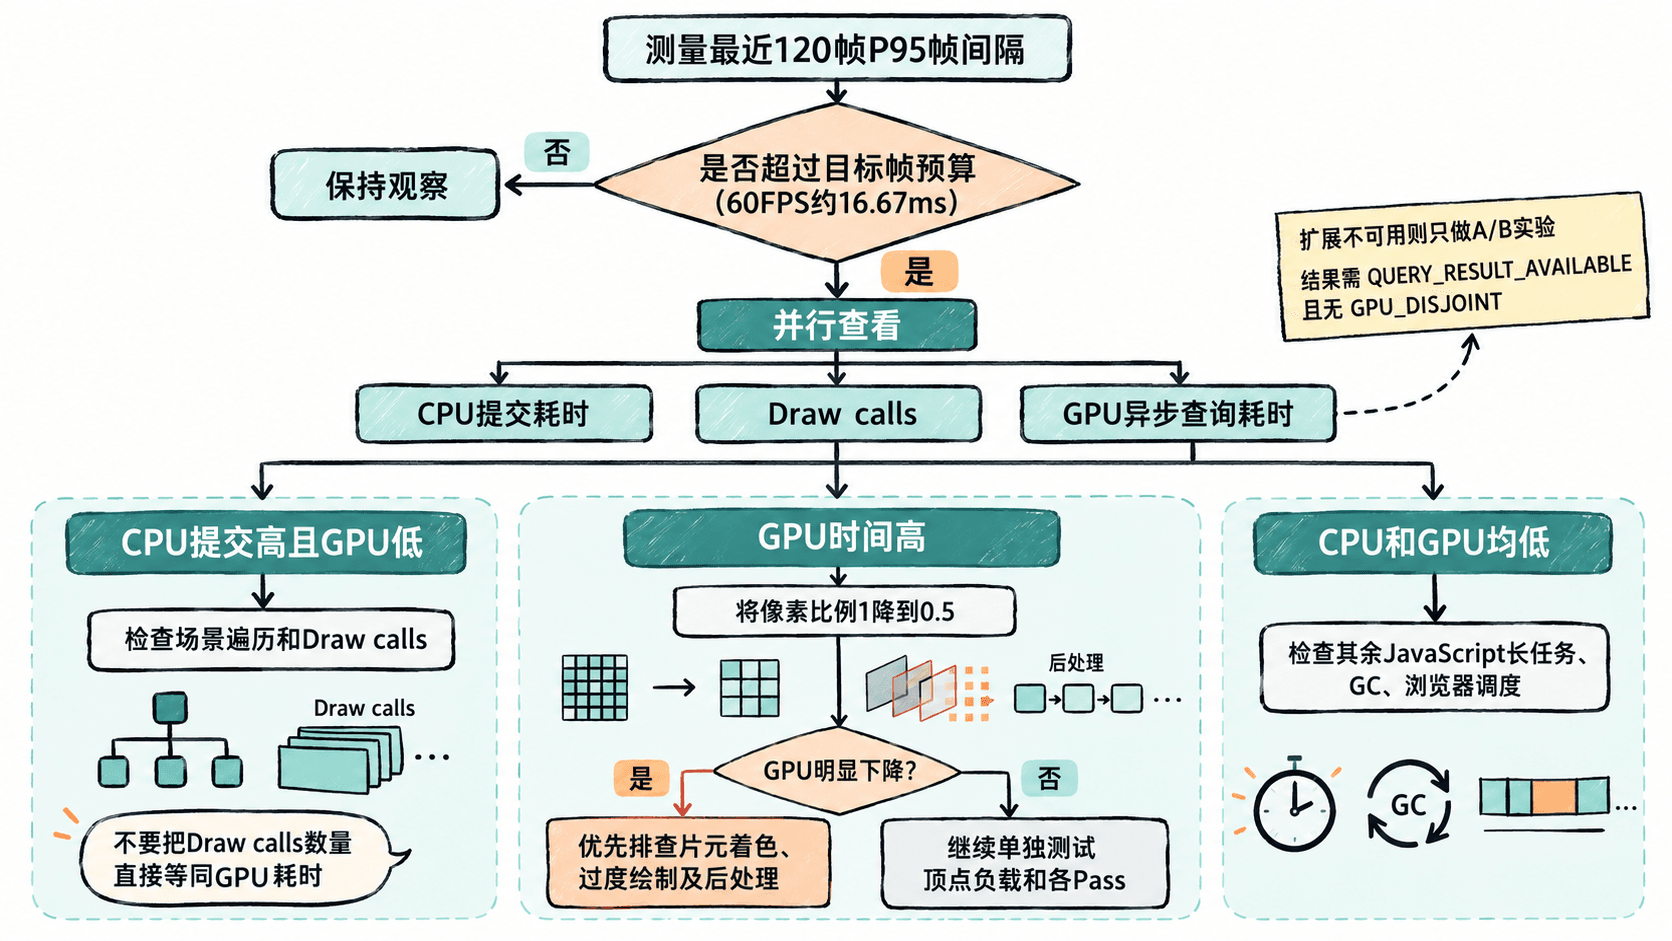
以下数字是用于练习判断的三组假设观测值,不是某款显卡的基准。表内 GPU 时间只覆盖本示例包围的绘制区间,P95 则包含整条浏览器帧节奏。
| 情况 | 帧间隔 P95 | CPU 提交均值 | GPU 样本 | Draw calls | 下一步 |
|---|---|---|---|---|---|
| A | 28 ms | 12 ms | 4 ms | 900 | 检查场景遍历、材质切换和过多绘制提交 |
| B | 27 ms | 2 ms | 21 ms | 3 | 降渲染分辨率、关闭 Bloom 等片元密集 Pass |
| C | 35 ms | 2 ms | 3 ms | 8 | 检查其余 JS、垃圾回收、浏览器调度及同步等待 |
A 的高 Draw Call 是线索而不是结论;B 的 GPU 时间明显较高,但还需实验区分片元、带宽或顶点开销;C 说明被计时的渲染区间不足以解释慢帧,应查看浏览器 Performance 面板的主线程长任务。
只改一个变量验证推断
- 保持同一个窗口、相机、画面内容和浏览器前台状态,预热数秒,记录三轮各 120 帧的 P95、CPU 和 GPU 样本。
- 访问
http://localhost:8000/?scale=0.5,把物理宽高各减半,像素总量变成原来的 25%。若 Draw calls 不变、GPU 时间明显下降,而 CPU 提交变化很小,优先排查全屏 Shader、后处理采样、透明过绘与像素带宽;GPU 时间不必严格下降四倍。 - 恢复
scale=1,一次只停用一个后处理 Pass(例如 Bloom 模糊),分别记录变化;如果 GPU 时间主要跟随某个 Pass 改变,就集中检查该 Pass 的采样次数和渲染目标尺寸。 - 若 CPU 提交偏高但 GPU 较低,尝试实例化或合批重复网格,观察 Draw calls 与 CPU 时间是否一起下降。若两者都低而 P95 仍高,则检查 JS 更新、资源上传或浏览器主线程任务。
多 Pass 工程中,renderer.info 默认可能在每次 renderer.render() 时重置;需要整帧合计时,设 renderer.info.autoReset = false,在该帧所有 Pass 结束后读取统计,再调用 renderer.info.reset()。不要把单个 Pass 的调用数误报成整帧数量。
避免无效计时结论
GPU 查询是可选扩展,某些浏览器或驱动不会提供;计时查询还可能因 GPU disjoint、上下文丢失而无效。遇到无效结果应丢弃并重测,而不是把它当成 0 ms。performance.now() 包围 WebGL 调用测到的是 CPU 侧提交,不等于 GPU 命令执行完成时间。
比较性能时优先看多轮数据的趋势:帧间隔是否改善、CPU 提交是否下降、GPU 耗时是否响应单一变量。三者形成因果证据后再改 Shader,比只追求控制台的 FPS 数字更可靠。相关接口可查阅 WebGL2 计时扩展规范 与 Three.js WebGLRenderer 文档。