
容器与云原生 / 系统课时
容器隔离的边界
容器隔离的边界
容器能隔离进程、文件系统、网络等运行视图,但它通常不会像虚拟机那样拥有独立内核。本篇从“共享什么、隔离什么、哪些配置会削弱隔离”三个角度建立安全边界,并用命令验证 Linux 容器与宿主运行环境的关系。
学习目标
- 说明容器与虚拟机在内核隔离上的关键差异
- 理解 namespaces、cgroups 与 Linux 安全机制分别解决什么问题
- 识别会显著扩大容器权限和宿主机攻击面的高风险配置
隔离不是一台更轻的虚拟机
Linux 容器本质上是宿主机上的普通进程,只是这些进程被放进不同的 namespaces,并受到 cgroups 和权限机制约束。容器内看到独立的 PID、网络接口、挂载点和主机名,不代表它拥有自己的 Linux 内核。
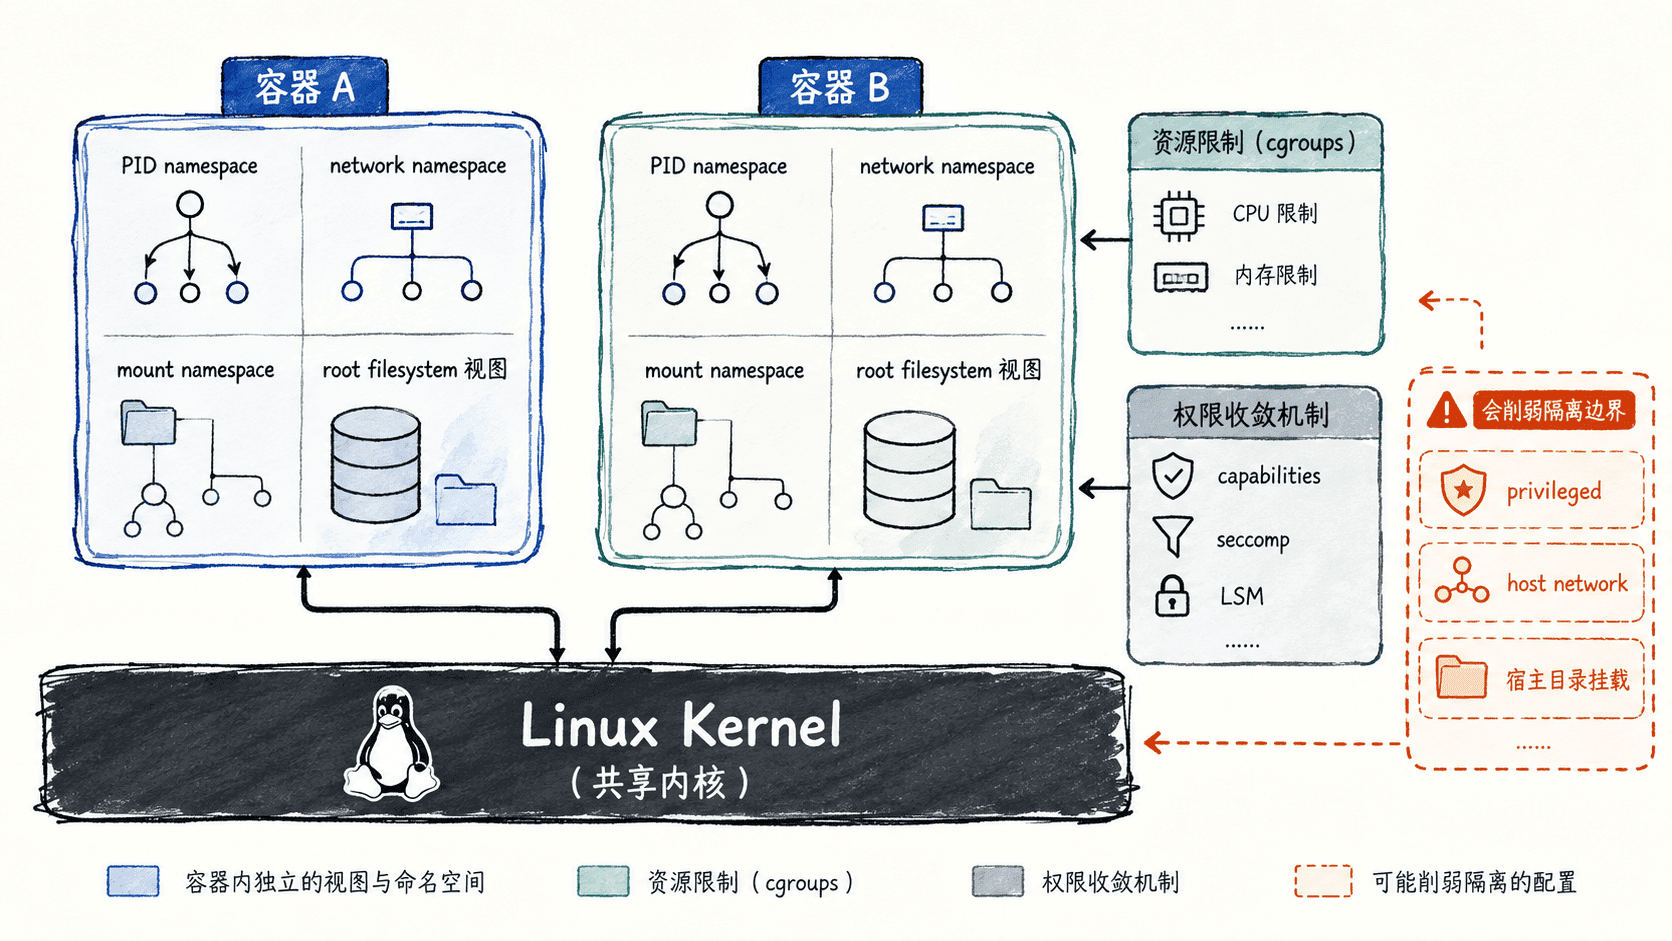
虚拟机通常通过 hypervisor 为每个来宾系统提供独立内核;容器则共享承载它的 Linux 内核。因此,内核漏洞、过高权限或危险宿主资源映射,可能让“容器内的问题”跨过边界影响宿主机。
在原生 Linux Docker Engine 上,可以直接比较内核版本:
uname -r
docker run --rm alpine:3.22 uname -r
预期输出中,两行通常是同一个 Linux 内核版本:
<KERNEL_VERSION>
<KERNEL_VERSION>namespaces 隔离运行视图
namespaces 让同一内核中的进程看到不同的“世界”。PID namespace 让容器拥有自己的进程编号空间,network namespace 提供独立网络栈视图,mount namespace 隔离挂载树,UTS namespace 则隔离主机名等信息。
下面启动一个临时容器观察 PID 视图:
docker run --rm alpine:3.22 sh -c 'echo "shell pid=$$"; ps -o pid,comm'预期结果中,容器主进程通常显示为 PID 1;后续命令的 PID 可能不同。
shell pid=1
PID   COMMAND
1     sh
<ID>  ps
这不是新建了一套内核,而是同一个内核向该进程组提供了独立 PID namespace。
cgroups 管资源,不等于安全沙箱
cgroups 负责限制和统计 CPU、内存、进程数量等资源,主要解决“一个容器能消耗多少宿主资源”。它可以降低资源争抢和部分拒绝服务风险,但不会单独阻止进程调用危险系统调用,也不会自动消除高权限带来的攻击面。
更完整的容器边界通常还依赖 Linux capabilities、seccomp、AppArmor 或 SELinux,以及 Docker 默认的非特权运行策略。安全设计应理解这些机制是叠加关系,而不是某一个开关提供绝对隔离。
会削弱隔离的高风险配置
--privileged 会大幅提升容器可用权限并放宽设备访问;挂载 /var/run/docker.sock 等控制接口,可能让容器获得操纵 Docker Engine 的能力;直接挂载宿主敏感目录,也会把原本隔离的文件边界主动打通。
--network host 会让容器直接使用宿主网络 namespace,在需要高性能或特殊网络行为时可能合理,但同时减少网络层隔离。类似配置并不必然“错误”,关键是清楚它们改变了哪一层边界,并把权限缩到业务真正需要的最小范围。
判断容器安全性时,最重要的问题不是“它是不是容器”,而是“它共享了哪些宿主资源、被授予了哪些能力、哪些隔离层被主动绕过”。只有把共享内核这一前提放在首位,才能正确评估容器与宿主机之间的风险边界。