
容器与云原生 / 系统课时
控制服务依赖与健康状态
控制服务依赖与健康状态
depends_on 能解决“谁先启动”,却不会自动证明依赖服务已经可以接收请求。本篇用数据库与客户端服务构造一个可运行示例,把启动顺序、健康检查和 service_healthy 的边界一次讲清,并给出验证与失败处理方法。
学习目标
- 区分“容器已启动”和“服务已就绪”两个状态
- 使用
healthcheck与depends_on.condition控制依赖服务的启动条件 - 能根据健康状态定位依赖服务迟迟不启动的问题
depends_on 真正保证什么
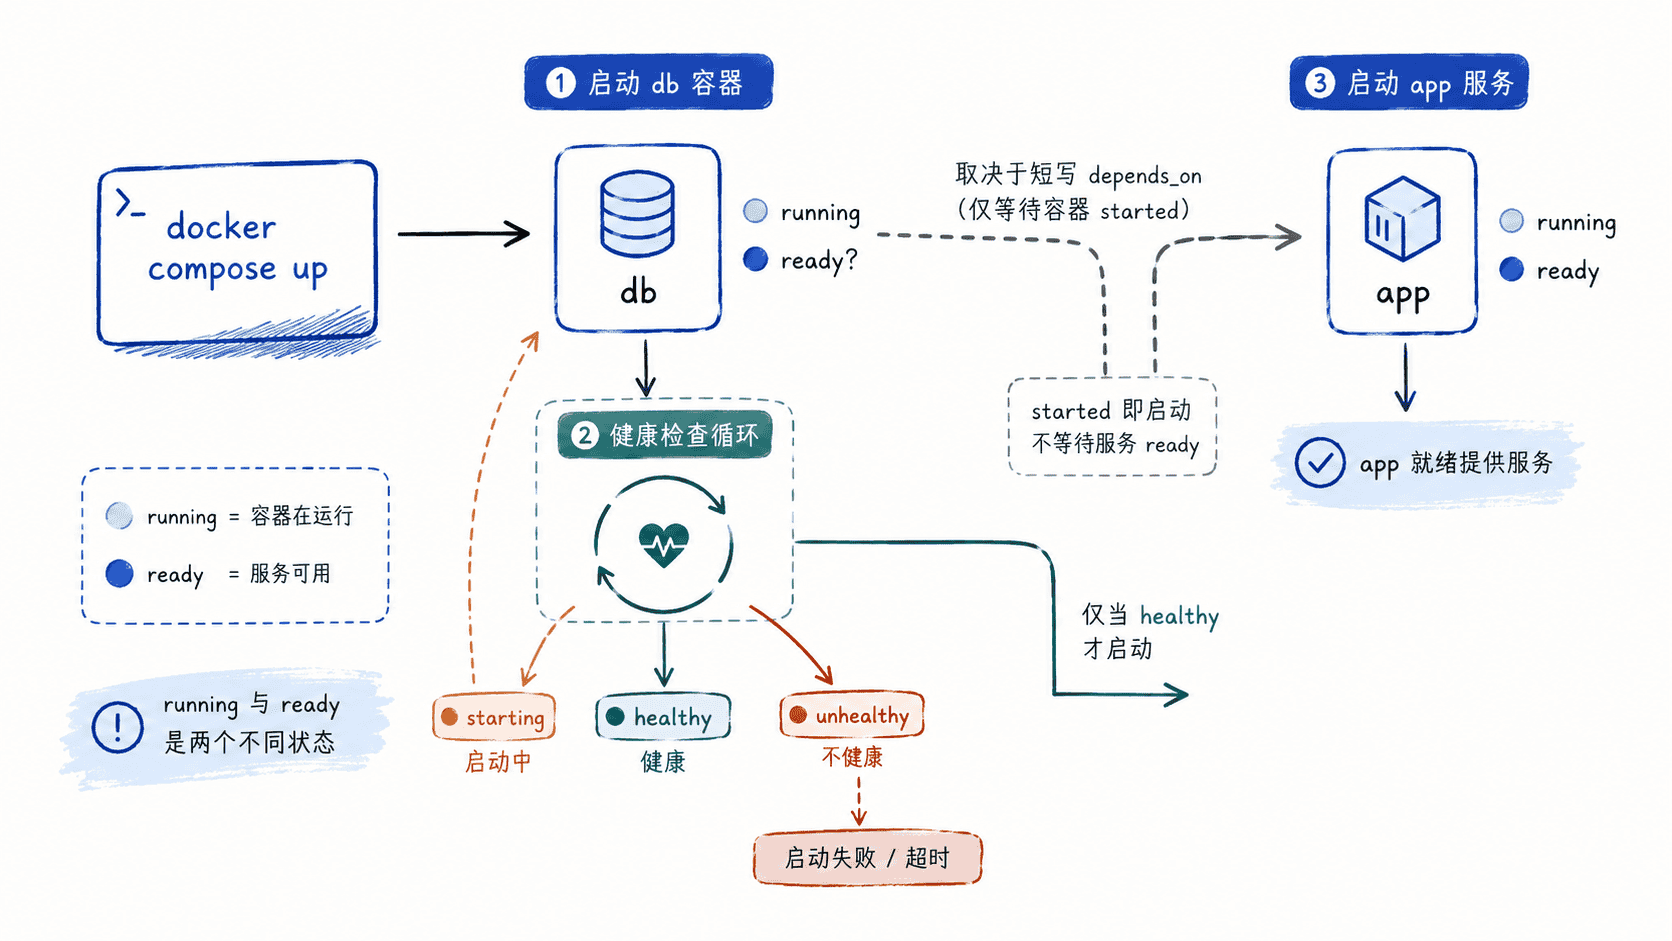
Compose 会根据服务依赖关系决定创建和启动顺序。短写法 depends_on: [db] 只要求先启动 db,随后就可以启动当前服务;它不等待数据库完成初始化,也不保证端口背后的业务已经可用。
这一区别在数据库、消息队列、搜索引擎等启动较慢的服务上尤其重要。容器进程存在,只说明容器进入了 running 状态;应用真正“ready”,还需要由服务自己的健康探针证明。
用健康检查控制启动条件
下面的 compose.yaml 使用 PostgreSQL 作为依赖服务。db 通过 pg_isready 报告健康状态,app 只有在数据库变为 healthy 后才执行一次 SQL。
services:
  db:
    image: postgres:16-alpine
    environment:
      POSTGRES_USER: demo
      POSTGRES_PASSWORD: demo
      POSTGRES_DB: demo
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U demo -d demo"]
      interval: 2s
      timeout: 2s
      retries: 10
      start_period: 5s

  app:
    image: postgres:16-alpine
    depends_on:
      db:
        condition: service_healthy
    environment:
      PGPASSWORD: demo
    command:
      - psql
      - -h
      - db
      - -U
      - demo
      - -d
      - demo
      - -c
      - SELECT 1 AS ready;
这里的关键点不是 depends_on 本身,而是依赖服务必须先定义可反映“业务可用”的 healthcheck。condition: service_healthy 才能把健康状态转换成后续服务的启动门槛。
启动并查看结果:
docker compose up -d
docker compose wait app
docker compose ps -a
docker compose logs app预期结果中,db 最终应显示为 healthy,app 在数据库健康后执行 SQL 并以退出码 0 结束;具体容器名和时间会因项目目录与运行时不同而变化。
NAME              SERVICE   STATUS
<PROJECT>-db-1    db        Up <TIME> (healthy)
<PROJECT>-app-1   app       Exited (0) <TIME>

 ready
-------
     1
(1 row)
健康检查应该检查业务能力
探针应回答“依赖方现在能不能正常使用这个服务”,而不是只检查进程是否存在。数据库适合执行连接就绪检查,HTTP 服务适合请求轻量健康端点,消息系统则应验证其监听与基础响应能力。
interval 决定检查频率,timeout 限制单次探针时间,retries 控制连续失败多少次后判为 unhealthy,start_period 则给启动阶段留出宽限时间。参数应根据服务真实初始化时长设置,而不是盲目缩短。
依赖卡住时按状态定位
如果 app 一直没有启动,先查看 Compose 状态和数据库健康检查日志,而不是反复重启整个项目。
docker compose ps
docker inspect --format '{{json .State.Health}}' "$(docker compose ps -q db)"
预期结果应包含 Status、FailingStreak 和最近几次探针记录。若服务仍在初始化,状态可能是 starting;连续失败后可能变成 unhealthy。
{"Status":"<starting|healthy|unhealthy>","FailingStreak":<VALUE>,"Log":[...]}实际 JSON 中时间戳、退出码和日志文本会随运行环境变化。若探针命令本身不存在、认证参数错误或服务启动时间超过重试窗口,应先修正健康检查,再观察依赖服务是否按预期放行。
depends_on 解决的是 Compose 内部的启动协调,不是运行期高可用机制。服务启动后如果数据库再次故障,应用仍需要连接重试、超时、熔断等自身容错策略;不要把健康依赖当作完整的故障恢复方案。