
游戏客户端架构 / 系统课时
Unity、Unreal、Godot如何复用同一模型
Unity、Unreal、Godot如何复用同一模型
跨引擎复用存档系统,不是把 Unity 的 C# 文件直接搬到 Unreal 或 Godot,而是把稳定的数据契约、版本规则和存取流程从引擎对象中剥离。做到这一点后,真正需要重写的只剩运行时对象读取、资源定位和平台存储等适配部分。
学习目标
- 区分可以跨引擎复用的存档模型与必须适配的引擎能力
- 用稳定 ID 和纯数据结构隔离场景对象、资源对象与存档数据
- 建立 Core、Adapter、Storage 三层边界,降低迁移引擎或升级项目的成本
跨引擎真正不同的是什么
Unity、Unreal 和 Godot 都能序列化数据,但它们的运行时对象体系并不相同。Unity 常围绕 GameObject、Component、ScriptableObject 工作;Unreal 有 Actor、UObject、Asset;Godot 则以 Node、Resource 和场景树为核心。
因此,下面这些内容不适合作为跨引擎存档模型直接保存:
| 内容 | 为什么不应直接进入核心存档 |
|---|---|
| 场景对象引用 | 通常只在当前运行时或当前场景实例中有效 |
| 组件、Actor、Node 实例 | 带有引擎生命周期和内部状态 |
| 资源内存引用 | 重启游戏后原地址和实例关系通常不存在 |
| 引擎专用序列化对象 | 换引擎后类型系统与序列化规则不同 |
真正适合复用的是纯数据,例如角色等级、任务状态、物品数量、世界实体 ID、资源逻辑 ID 和存档版本号。核心原则是:存档描述游戏事实,而不是描述某个引擎此刻的内存对象。
把差异压到适配层
可以把完整方案拆成三层:核心模型定义存什么以及怎样迁移;引擎适配层负责从运行时对象提取数据并把数据恢复回对象;存储层只处理文件、云端或平台存档接口。
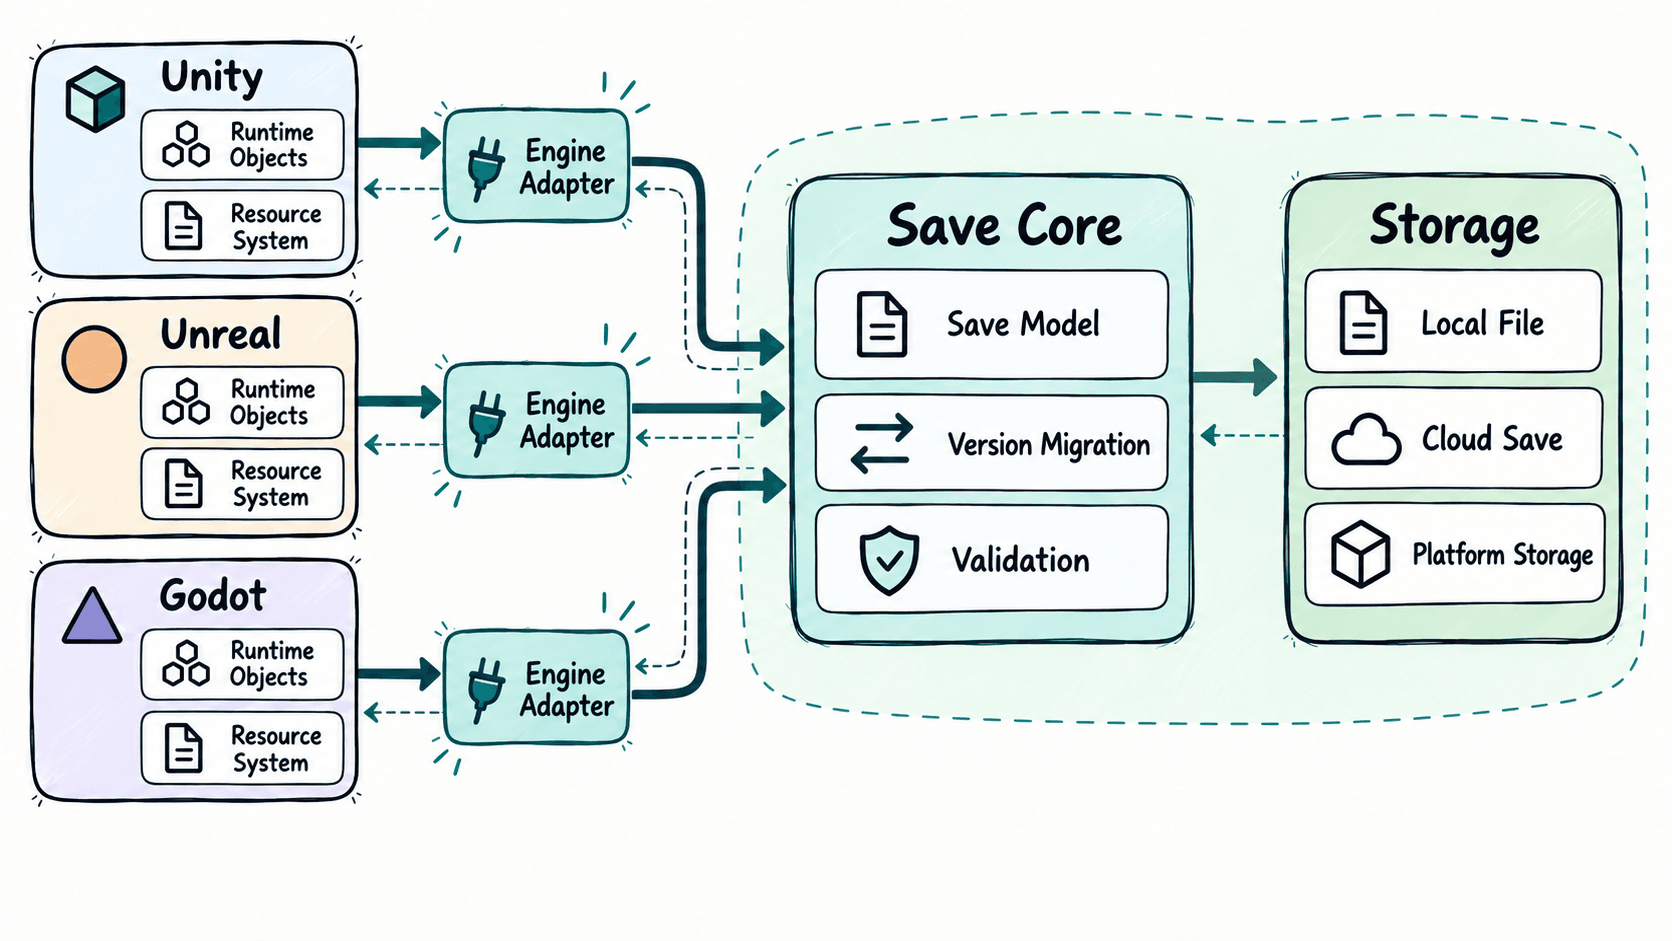
这种结构下,更换引擎时不需要重新设计存档文件含义。例如三个项目都可以约定玩家数据具有下面的逻辑结构:
{
  "saveVersion": 3,
  "player": {
    "level": 18,
    "health": 92,
    "equippedWeaponId": "weapon-iron-sword"
  },
  "quests": {
    "quest-find-relic": "completed"
  }
}
这是数据结构示例,不依赖某个引擎的序列化 API。Unity 可以把组件状态转换成该结构,Unreal 可以从 Actor 或 SaveGame 对象生成它,Godot 也可以从 Node 状态构造相同数据。验证方法是让三个适配层针对同一份逻辑数据执行导出,再比较关键字段的名称、类型和语义是否一致。
用稳定 ID 跨过资源和对象边界
最容易破坏跨引擎复用的地方,是把资源引用或运行时对象引用写进存档。更稳妥的做法是保存稳定的业务 ID,读档时再由当前引擎的适配层解析。
例如存档只记录 weapon-iron-sword。Unity 适配层可以把它映射到某个 Addressables 资源,Unreal 可以映射到 Asset,Godot 可以映射到 Resource。核心模型不需要知道资源实际位于哪个目录,也不需要保存 GUID、内存地址或节点路径。
同样的方法适用于世界实体。假设玩家打开了地图中的宝箱,存档记录的应该是类似 chest-village-003 的稳定实体 ID 和 opened=true,而不是 Unity 的对象实例、Unreal 的 Actor 指针或 Godot 的节点引用。
什么时候算真正复用了同一模型
判断跨引擎设计是否成功,可以做一个简单的契约测试:准备同一份逻辑存档,分别交给三个引擎的适配层恢复,再检查玩家等级、装备、任务和世界状态是否得到同样的业务结果。只要核心字段的含义不随引擎改变,迁移逻辑也不依赖场景对象类型,就说明边界基本正确。
反过来,如果每增加一个存档字段都必须先考虑 GameObject、Actor 或 Node 应该怎样序列化,说明引擎细节已经侵入核心模型。长期可演进的方案应让模型面向游戏规则,让适配层面向引擎;未来换资源系统、换存储后端甚至换引擎时,存档格式才不必跟着推倒重来。