
游戏客户端架构 / 系统课时
版本升级怎样自动迁移存档
版本升级怎样自动迁移存档
游戏更新后,新增字段、重命名属性或改变数据结构都可能让旧存档无法直接读取。可靠的做法不是在加载代码里堆满版本判断,而是建立从旧 schema 到新 schema 的单向迁移链,让每一步只负责相邻版本之间的转换,并在迁移完成后再进入正常业务校验。
学习目标
- 设计从旧 schema 到当前 schema 的有序迁移链
- 理解为什么迁移应按相邻版本逐步执行,而不是跨版本猜测
- 实现可验证、可失败退出且不会直接破坏原存档的迁移流程
把版本迁移做成一条链
假设当前存档版本是 3,玩家仍可能持有版本 1 的文件。最稳定的路线不是直接写一个 v1ToV3,而是执行 v1 -> v2 -> v3。这样版本 2 的存档也可以复用后半段迁移逻辑,以后升级到版本 4 时只需新增 v3 -> v4。
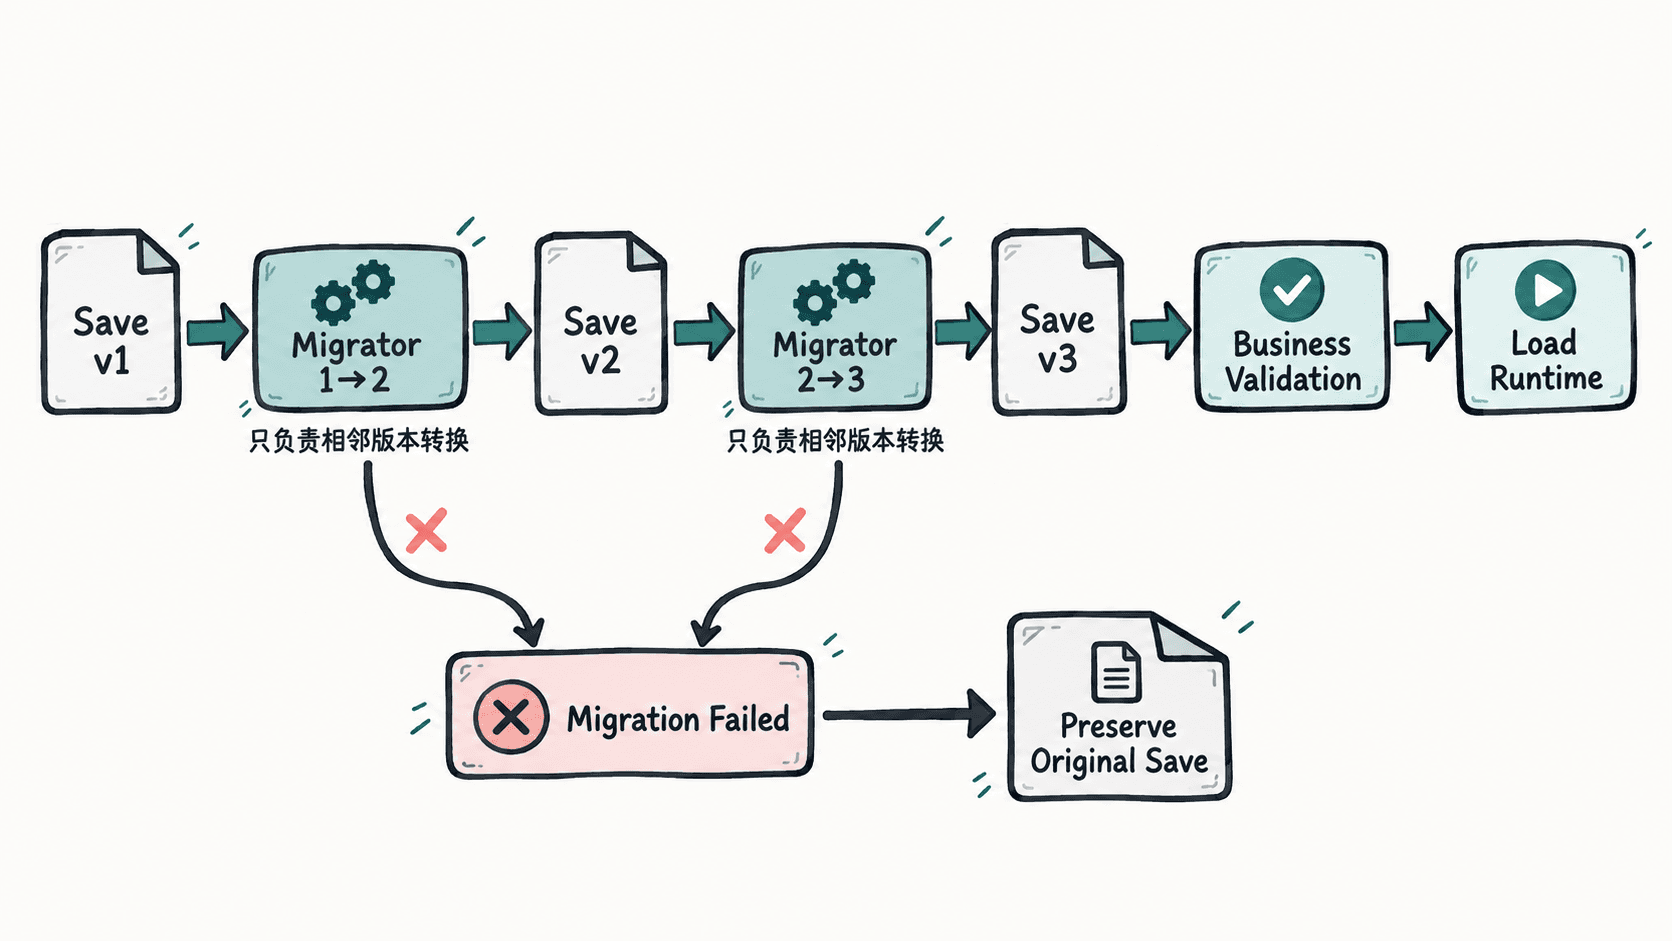
迁移器最好满足三个约束:输入版本明确、输出版本明确、一次只跨一个版本。迁移成功后立即更新 schemaVersion,下一步只根据新的版本继续处理。这样每一步都可以单独测试,也更容易判断失败发生在哪次升级。
用版本号驱动迁移器
下面使用 Java 的 Map<String, Object> 表示已经完成格式解析的存档对象。示例包含两个迁移器:版本 1 把 coins 改名为 gold,版本 2 新增 difficulty,最终升级到版本 3。
import java.util.LinkedHashMap;
import java.util.Map;

public class SaveMigrationDemo {
    interface Migrator {
        int fromVersion();
        int toVersion();
        Map<String, Object> migrate(Map<String, Object> save);
    }

    static class V1ToV2 implements Migrator {
        public int fromVersion() { return 1; }
        public int toVersion() { return 2; }

        public Map<String, Object> migrate(Map<String, Object> save) {
            // 字段改名时先复制值,再删除旧字段,避免同时存在两套含义。
            Object coins = save.remove("coins");
            save.put("gold", coins == null ? 0 : coins);
            save.put("schemaVersion", 2);
            return save;
        }
    }

    static class V2ToV3 implements Migrator {
        public int fromVersion() { return 2; }
        public int toVersion() { return 3; }

        public Map<String, Object> migrate(Map<String, Object> save) {
            // 新字段必须给旧存档确定的默认值,而不是留给运行时猜测。
            save.putIfAbsent("difficulty", "NORMAL");
            save.put("schemaVersion", 3);
            return save;
        }
    }

    static Map<String, Object> migrateToLatest(
            Map<String, Object> save,
            Map<Integer, Migrator> migrators,
            int latestVersion) {

        int version = (int) save.get("schemaVersion");
        while (version < latestVersion) {
            Migrator migrator = migrators.get(version);
            if (migrator == null || migrator.toVersion() != version + 1) {
                throw new IllegalStateException("Missing migrator from version " + version);
            }
            save = migrator.migrate(save);
            version = (int) save.get("schemaVersion");
        }
        return save;
    }

    public static void main(String[] args) {
        Map<String, Object> oldSave = new LinkedHashMap<>();
        oldSave.put("schemaVersion", 1);
        oldSave.put("playerName", "Ari");
        oldSave.put("coins", 120);

        Map<Integer, Migrator> migrators = Map.of(
            1, new V1ToV2(),
            2, new V2ToV3()
        );

        Map<String, Object> upgraded = migrateToLatest(oldSave, migrators, 3);
        System.out.println(upgraded);
    }
}
预期输出:
{schemaVersion=3, playerName=Ari, gold=120, difficulty=NORMAL}这里用旧版本号作为迁移器索引,因此读取到版本 1 时只能找到 1 -> 2,完成后才能继续查找 2 -> 3。如果中间某一步缺失,程序立即失败,而不是尝试跳过未知结构。
迁移之后还要重新验证
迁移器只负责把数据结构转换成新 schema,并不能证明数据一定满足当前业务规则。例如旧版本允许金币为负数,而新版本禁止,那么结构升级成功后仍应执行一次当前版本的完整业务校验。
推荐的顺序是:解析原始文件,读取 schemaVersion,确认该版本处于支持范围,复制一份工作数据,依次执行迁移器,按当前 schema 做格式与业务验证,最后再写出升级后的存档。只有所有步骤成功,才替换正式文件。
对于比程序当前版本还新的存档,例如程序只认识版本 3 却读到版本 4,也不要尝试降级解析。那通常表示玩家使用过更新版本的客户端,正确处理是明确返回“不支持的未来版本”。
让迁移可测试也可重复判断
每个迁移器都应准备至少一组真实旧版本样本,并验证三个结果:目标字段是否正确生成、旧字段是否按设计保留或删除、输出的 schemaVersion 是否准确。完整链路还应覆盖从最老受支持版本一路升级到当前版本的测试。
迁移过程中最好不要依赖当前时间、随机数或外部网络,否则同一个旧存档多次迁移可能得到不同结果。确实需要新增值时,优先使用明确的默认值或由旧字段确定性计算。
当版本升级被拆成独立的 vN -> vN+1 迁移器后,读档代码只需要负责选择和串联迁移步骤。新增版本时补上一段新的迁移器即可,不必反复修改所有历史版本的判断逻辑。