
游戏客户端架构 / 系统课时
旧字段删除后还能正常读吗
旧字段删除后还能正常读吗
代码里删掉一个字段,并不代表玩家磁盘上的旧存档会自动消失。真正决定能否读档的是解析器是否仍认识旧结构,以及迁移窗口是否已经覆盖足够多的历史版本。本节用“兼容读取、只写新格式、最终清理”三阶段说明旧字段该什么时候删。
学习目标
- 区分“代码字段已删除”和“旧存档字段仍存在”这两件事
- 能实现兼容旧字段的读取逻辑,同时只写入新格式
- 能判断何时可以永久迁移并移除旧字段兼容代码
删除字段后为什么还可能读成功
JSON、字典或键值型存档通常允许出现解析器不关心的字段,所以旧存档里多出来的字段本身并不会导致失败。真正危险的是新版代码只认新字段,却没有旧字段回退规则。
例如旧版本使用 hpLimit,新版本改成 maxHp。如果新版只读取 maxHp,旧存档就会得到缺失值;如果读取时先看 maxHp,不存在时再回退到 hpLimit,旧数据仍可正常进入新版内存模型。
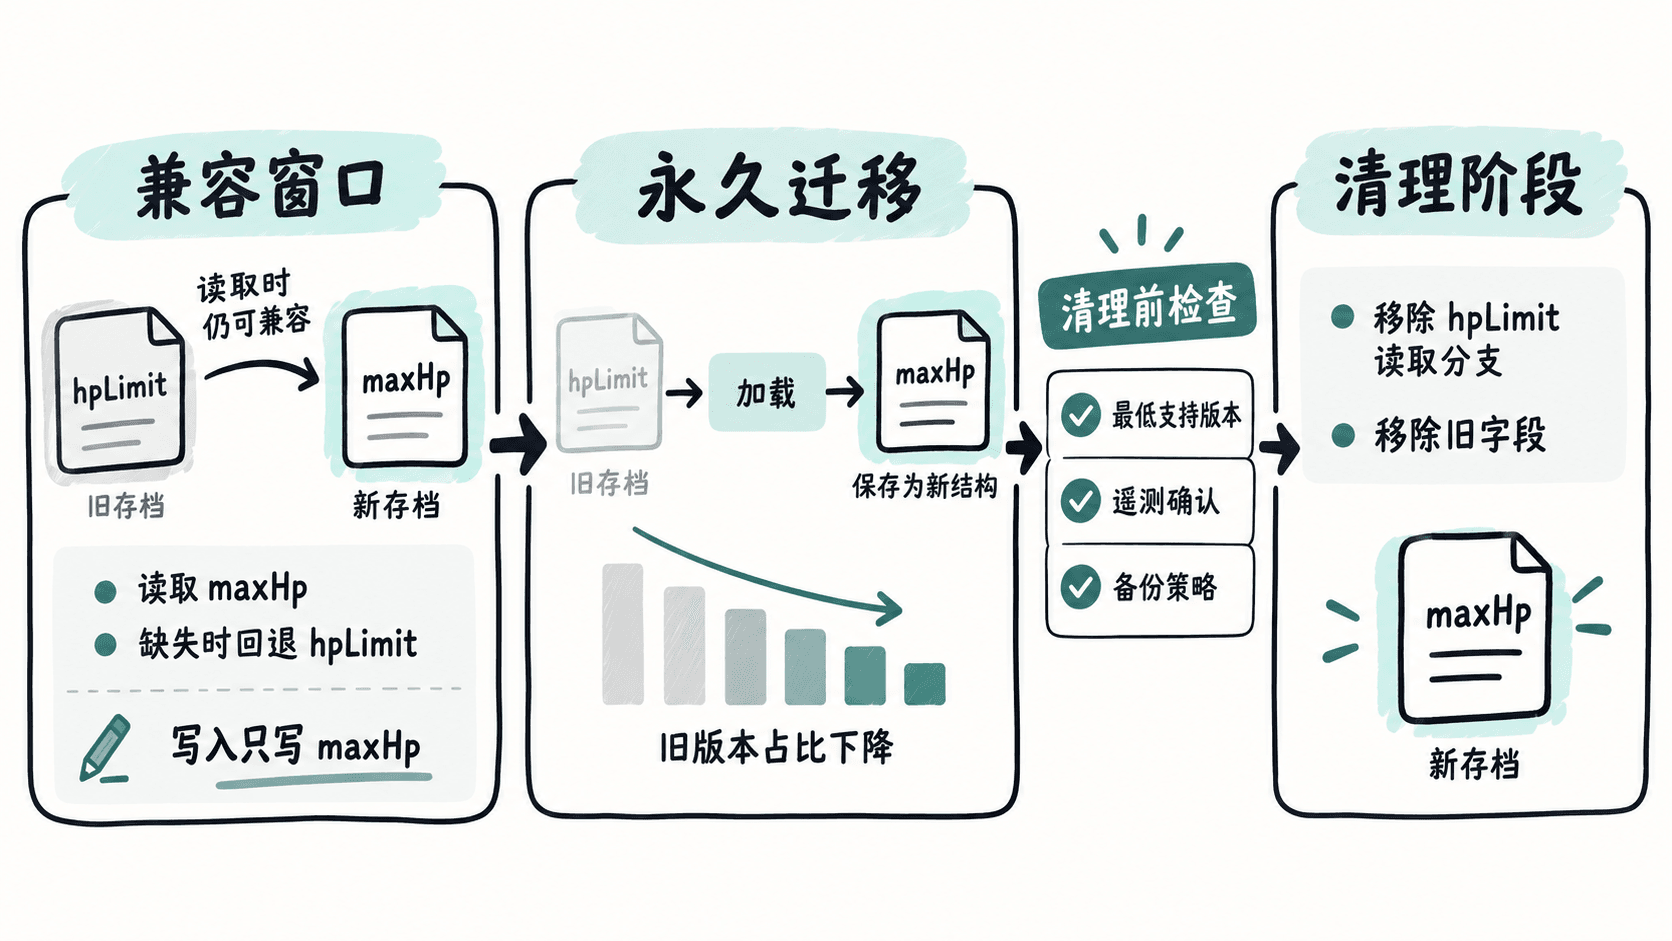
兼容期应该“多读一种,少写一种”
最稳妥的策略是:读取时同时接受新旧字段,写回时只输出新字段。这样玩家每次正常读档并再次保存,旧格式都会自然收敛到新格式,而不会继续制造新的旧数据。
下面的 Node.js 示例同时读取 maxHp 和 hpLimit,但序列化时只保留 maxHp。
function readNumber(value) {
  return typeof value === "number" && Number.isFinite(value) ? value : undefined;
}

function parseSave(raw) {
  const newValue = readNumber(raw.player?.maxHp);
  const oldValue = readNumber(raw.player?.hpLimit);
  const maxHp = newValue ?? oldValue;

  if (maxHp === undefined) {
    throw new Error("Save is missing player max HP");
  }

  return {
    version: 4,
    player: {
      name: String(raw.player?.name ?? "Unknown"),
      maxHp
    }
  };
}

function serializeSave(save) {
  return JSON.stringify(save);
}

const oldSave = {
  version: 2,
  player: { name: "Mira", hpLimit: 120 }
};

const normalized = parseSave(oldSave);
console.log(JSON.stringify(normalized));
console.log(serializeSave(normalized));
预期输出:
{"version":4,"player":{"name":"Mira","maxHp":120}}
{"version":4,"player":{"name":"Mira","maxHp":120}}这里的关键不是“忽略旧字段”,而是在解析边界把旧结构归一化成当前内存模型。业务代码从此只处理 maxHp,兼容逻辑被限制在读档入口。
兼容窗口什么时候可以结束
兼容代码不能无限保留,否则字段别名会越来越多,解析器也会逐渐变成历史包袱。删除旧字段支持前,至少要确认旧数据已经有明确去路。
可以同时参考三类条件:当前版本已经运行过一段足够长的兼容期;低于某个存档版本的文件会在读取后被永久迁移;线上统计或测试样本确认旧字段占比已经接近零。如果产品允许玩家多年后直接拿极老存档回来,则还要明确“最低可支持存档版本”,而不能只看近期活跃用户。
永久迁移后的清理策略
进入清理阶段后,可以把旧字段删除分成两部分处理:持久化数据中的旧字段由迁移过程清掉;代码中的旧字段别名、测试夹具和回退分支则在确认迁移覆盖后删除。保留一组最老支持版本的回归样本,能防止未来重构时无意间破坏兼容链。
如果存档格式允许未知字段存在,短期内“旧字段还留在文件里”通常不是故障;真正需要避免的是新版读取路径失去旧字段语义。先兼容读取、再只写新格式、最后清理旧分支,才能让字段删除从一次冒险操作变成可控的版本演进。