
游戏客户端架构 / 系统课时
读档后如何重建运行时对象
读档后如何重建运行时对象
存档里保存的是可持久化数据,而不是场景中的真实对象引用。读档真正困难的部分,是把这些静态数据重新变成对象、组件和彼此之间的关系,并保证依赖顺序正确。本节用“先创建、再赋值、后连线”的方式完成一次可验证的重建流程。
学习目标
- 区分存档数据与运行时对象,避免直接序列化对象引用
- 掌握按稳定 ID 重建对象、组件状态和对象关系的顺序
- 为旧版本迁移、缺失对象和加载后初始化预留处理位置
为什么不能反序列化完就直接用
存档通常只应包含 ID、数值、枚举、字符串等稳定数据。场景对象、组件实例、事件订阅、缓存和资源句柄都属于运行时状态,它们可能在下一次启动时拥有完全不同的内存地址,也可能根本不存在。
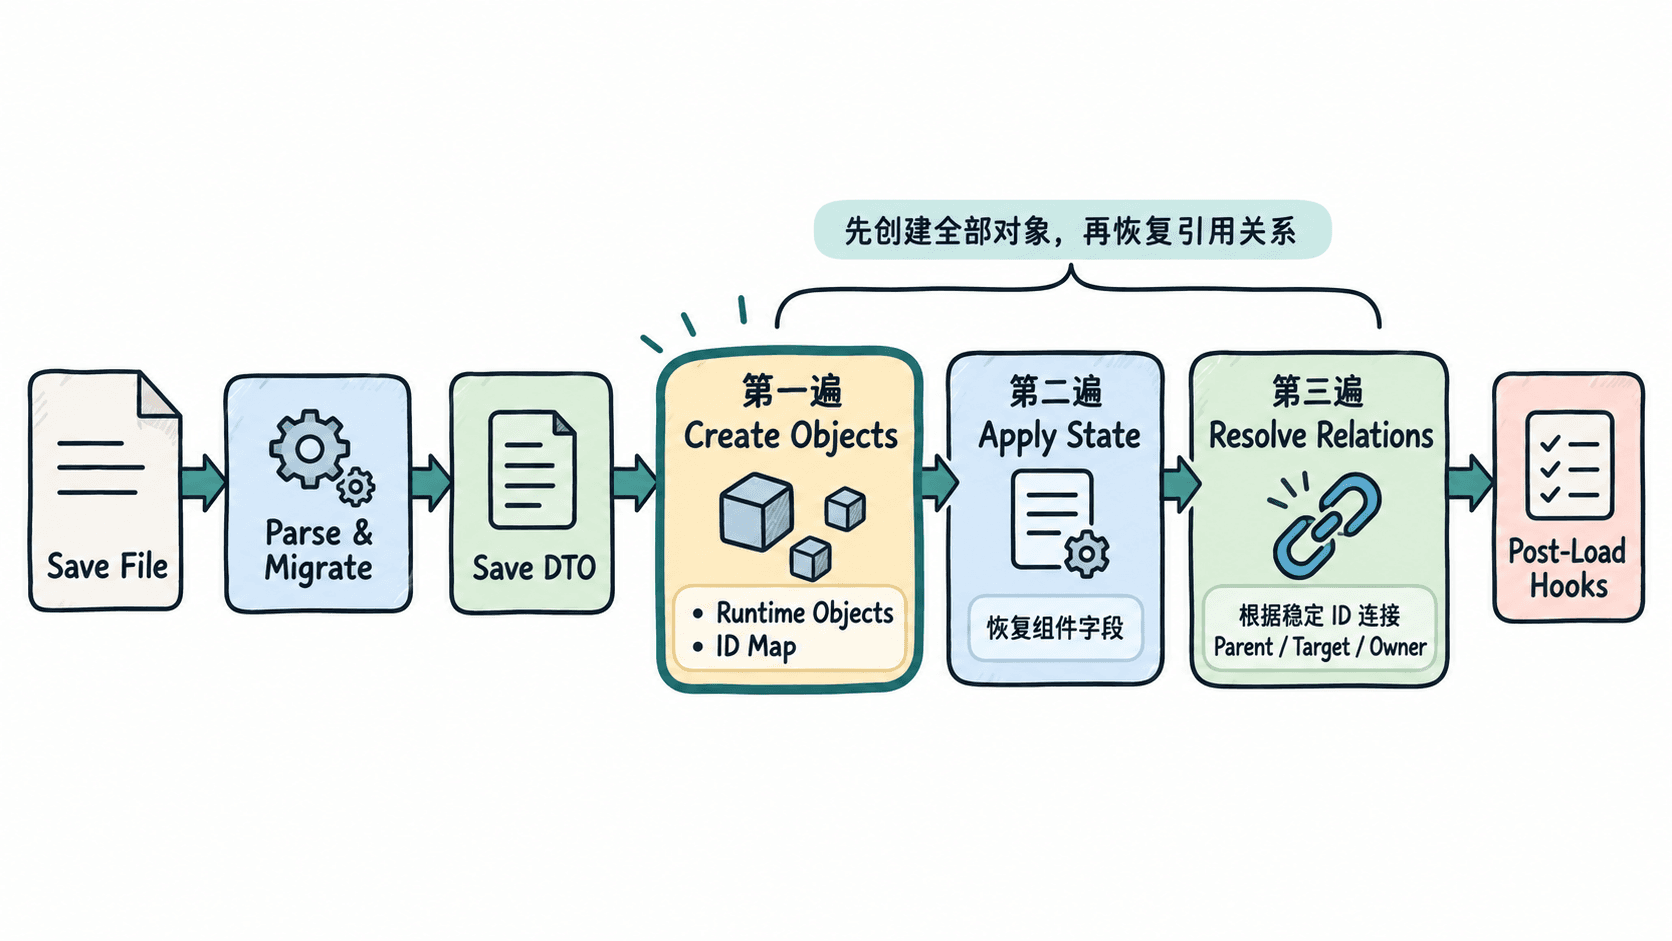
因此,读档至少要区分两层:先把文件解析成“存档 DTO”,再由重建器创建运行时对象。若存档带版本号,还应在进入重建器前完成迁移,让后续逻辑只面对当前结构。
用稳定 ID 分阶段重建
下面的示例假设 JSON 已经完成解析和版本迁移,输入是当前版本的 DTO。关键点是先创建所有对象并放进 idMap,再恢复父子关系;否则子对象引用的父对象可能还没有被创建。
using System;
using System.Collections.Generic;

public sealed record EntitySave(
    string Id,
    string Name,
    int Hp,
    string? ParentId
);

public sealed class RuntimeEntity
{
    public string Id { get; }
    public string Name { get; }
    public int Hp { get; set; }
    public RuntimeEntity? Parent { get; set; }

    public RuntimeEntity(string id, string name)
    {
        Id = id;
        Name = name;
    }
}

public static class SaveRebuilder
{
    public static Dictionary<string, RuntimeEntity> Rebuild(
        IReadOnlyList<EntitySave> saves)
    {
        var idMap = new Dictionary<string, RuntimeEntity>();

        foreach (var save in saves)
        {
            // 第一遍只负责创建对象,确保所有稳定 ID 都能被找到。
            idMap[save.Id] = new RuntimeEntity(save.Id, save.Name);
        }

        foreach (var save in saves)
        {
            var entity = idMap[save.Id];
            entity.Hp = save.Hp;

            // 第二遍再解析对象关系,避免受存档顺序影响。
            if (save.ParentId is not null &&
                idMap.TryGetValue(save.ParentId, out var parent))
            {
                entity.Parent = parent;
            }
        }

        return idMap;
    }
}

public static class Program
{
    public static void Main()
    {
        var saves = new[]
        {
            new EntitySave("player", "Hero", 80, null),
            new EntitySave("pet", "Wolf", 35, "player")
        };

        var entities = SaveRebuilder.Rebuild(saves);
        var pet = entities["pet"];

        Console.WriteLine($"{pet.Name}: HP={pet.Hp}");
        Console.WriteLine($"Parent={pet.Parent?.Name ?? "<none>"}");
    }
}
预期输出:
Wolf: HP=35
Parent=Hero
这段代码没有依赖对象在文件中的先后顺序。即使 pet 记录写在 player 前面,第一遍也会先把两个对象都创建出来,因此第二遍总能通过稳定 ID 查找关系。
组件状态与关系要分开恢复
真实项目里,一个对象往往还有位置、背包、任务、AI、技能冷却等多个组件。适合的做法是让每类组件保存自己的 DTO,再由对应恢复器把字段写回现有组件,而不是让某个巨大的加载函数知道所有细节。
对象关系要尽量保存为稳定 ID。例如任务目标保存 targetEntityId,装备归属保存 ownerId。读档时统一通过 ID 映射解析。若引用目标不存在,不要立即崩溃;应根据业务决定忽略、使用默认对象,或把该槽位标记为损坏。
最后再执行加载后初始化
字段和关系恢复完成后,才能执行依赖完整世界状态的逻辑,例如重新订阅事件、刷新 UI、重建寻路缓存、恢复 AI 状态机或计算派生属性。可以把这些操作统一放进 OnPostLoad 一类的生命周期钩子中。
这个顺序也为旧数据兼容留下了清晰边界:文件解析失败属于读取阶段,结构升级属于迁移阶段,对象缺失属于重建阶段,运行时缓存刷新属于加载后阶段。把问题分层后,读档失败会更容易定位,也不会因为某个对象尚未创建就产生大量连锁异常。