
游戏客户端架构 / 系统课时
存档系统和游戏逻辑如何分层
存档系统和游戏逻辑如何分层
如果角色、任务和场景对象都自己打开文件、拼接 JSON、决定保存路径,项目很快会出现重复代码和难以迁移的存档格式。更稳妥的做法是把业务状态、存档数据模型与持久化服务分开,让每一层只负责一种变化原因。
学习目标
- 区分游戏业务状态、存档数据模型和持久化服务的职责
- 理解为什么业务对象不应该直接操作文件系统
- 建立从游戏状态收集数据、写盘、读盘再恢复业务状态的完整边界
三层分别负责什么
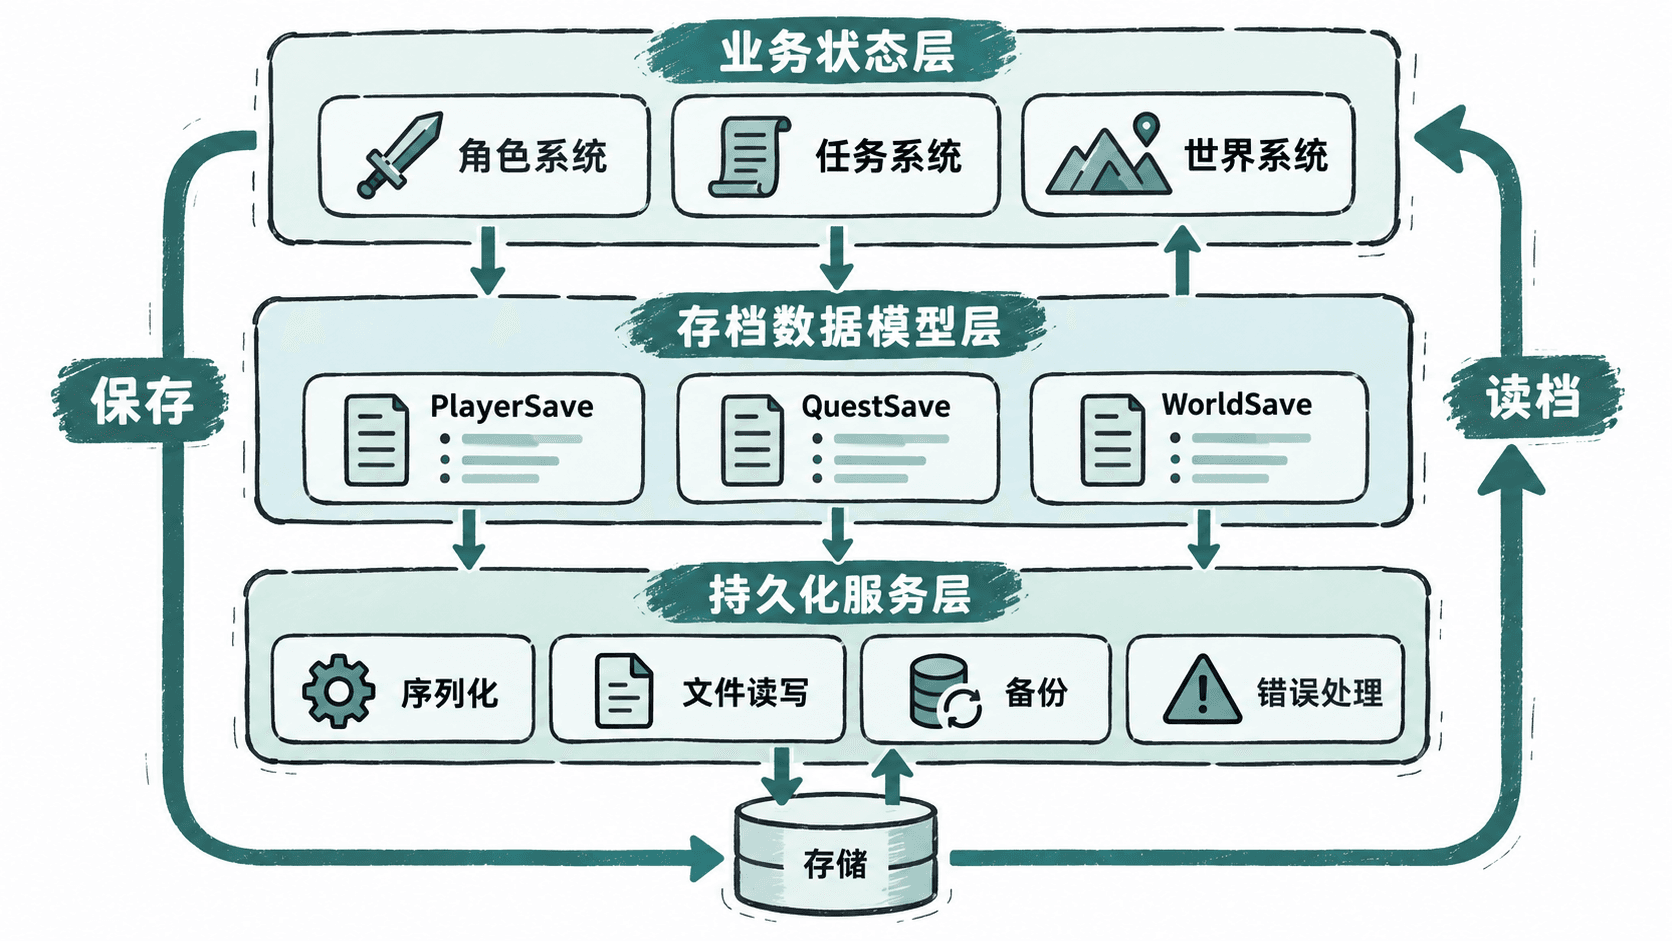
业务状态层负责“游戏现在是什么样”。角色系统知道当前等级和装备,任务系统知道哪些任务完成,世界系统知道哪些机关被触发。这一层应该专注游戏规则,而不是磁盘路径、序列化格式或加密算法。
存档数据模型负责“哪些事实需要跨会话保存”。它通常由稳定、简单的数据结构组成,例如玩家进度、任务记录、世界变化和存档版本。这里应避免直接持有场景节点、组件实例、文件句柄等运行时对象。
存档服务则负责“怎样把数据安全地保存和取回”。文件路径、序列化、临时文件替换、错误处理、备份以及以后可能加入的压缩或云同步,都应该集中在这一层。
保存时让业务提供数据
保存操作最好由一个上层协调者发起,而不是让每个游戏对象各自写文件。协调者向角色、任务、世界等系统收集需要持久化的状态,将它们组合成统一的存档数据模型,再交给存档服务写入。
这里的关键是:业务系统知道“保存什么”,存档服务知道“怎么保存”。例如任务系统可以提供已完成任务 ID 集合,但不应该知道最终文件叫 slot1.json,也不应该决定 JSON 使用什么字段缩进方式。
这种边界还能避免多个系统同时修改同一个文件。存档服务得到的是某一时刻已经组装完成的数据对象,因此可以统一执行序列化、校验和原子替换,减少半写入文件造成损坏的风险。
读档时不要反向污染业务层
读档流程与保存相反:存档服务先读取并解析持久化数据,上层协调者再把不同部分分发给对应业务系统。角色系统恢复玩家进度,任务系统恢复任务记录,世界系统根据保存的事实重新设置场景状态。
业务对象不应该持有存档文件本身,也不要把序列化字段名扩散到整个项目。否则一旦文件格式从 JSON 改成二进制格式,或者加入云端存储,角色、任务和场景代码都会被迫修改。
数据模型不要直接等同于运行时对象
直接序列化角色组件看似省事,但运行时对象往往混合了持久化状态和大量临时状态。角色组件可能同时包含等级、当前动画引用、移动控制器、事件回调和缓存对象,其中只有少量字段真正属于存档。
独立数据模型相当于一道防火墙。业务代码可以自由重构内部结构,只要仍然能把必要状态转换成稳定的存档模型,旧存档就不必跟着场景层级和组件设计一起变化。
这也为版本迁移留下了位置。例如旧版本存档只有金币数量,新版本增加背包容量时,可以在加载旧数据后为缺失字段补默认值,而不是要求旧游戏对象能够直接反序列化成新的运行时组件。
用依赖方向检查设计是否健康
可以用一个简单标准检查分层是否失控:业务层可以依赖“保存数据的抽象”,但不应依赖具体文件系统;持久化层可以处理数据模型,但不应该调用角色升级、任务结算等游戏规则。
当更换文件格式、增加自动备份或接入云存档时,如果主要修改集中在存档服务和数据转换层,而角色战斗、任务判定等核心逻辑几乎不受影响,说明边界划分基本合理。
最终需要形成的不是一个无所不包的 SaveManager,而是一条清楚的数据责任链:业务系统拥有真实游戏状态,存档模型承载需要长期保留的事实,存档服务负责可靠持久化。三者职责分开后,存档格式升级、测试和故障恢复都会更容易控制。