
图形渲染与 Shader / 系统课时
顶点数据怎样进入管线
顶点数据怎样进入管线
模型文件里的“一个顶点”并不会自动变成顶点着色器的输入。本篇把 Vertex Buffer、顶点属性、步长与输入布局串起来,说明 GPU 如何从一段字节中取出位置、法线和 UV,并给出一套能快速检查错位问题的判断方法。
学习目标
- 理解 Vertex Buffer 保存的内容,以及顶点属性为什么必须有明确格式。
- 能根据
offset、stride与属性类型读懂一份顶点内存布局。 - 能说清绘制调用中从绑定缓冲区到顶点着色器收到数据的完整路径。
顶点缓冲区只是连续字节
Vertex Buffer 本质上是一段 GPU 可读取的连续内存。它可以保存位置、法线、纹理坐标、切线等属性,但缓冲区本身通常不携带“第 12 个字节开始是法线”这样的语义,真正的解释规则来自输入布局与着色器接口。
以一个交错存储的顶点为例:位置使用 3 个 32 位浮点数,占 12 字节;法线再占 12 字节;UV 使用 2 个 32 位浮点数,占 8 字节。因此单个顶点步长是 32 字节,第二个顶点从第 32 字节开始。
| 属性 | 类型 | 起始偏移 | 大小 |
|---|---|---|---|
| Position | 3 × float32 | 0 | 12 B |
| Normal | 3 × float32 | 12 | 12 B |
| UV | 2 × float32 | 24 | 8 B |
这种交错布局适合一次取出同一顶点的多项属性。也可以把位置、法线、UV 分别放入不同缓冲区;两种方式都成立,关键是绑定方式必须与输入布局完全一致。
输入布局决定怎样解释每个顶点
输入布局描述每个属性的格式、所在缓冲区、相对偏移以及顶点之间的步长。不同图形 API 的字段名称不完全相同,但核心问题一致:从哪个字节开始,按什么类型读取,读完后交给着色器的哪个输入位置或语义。
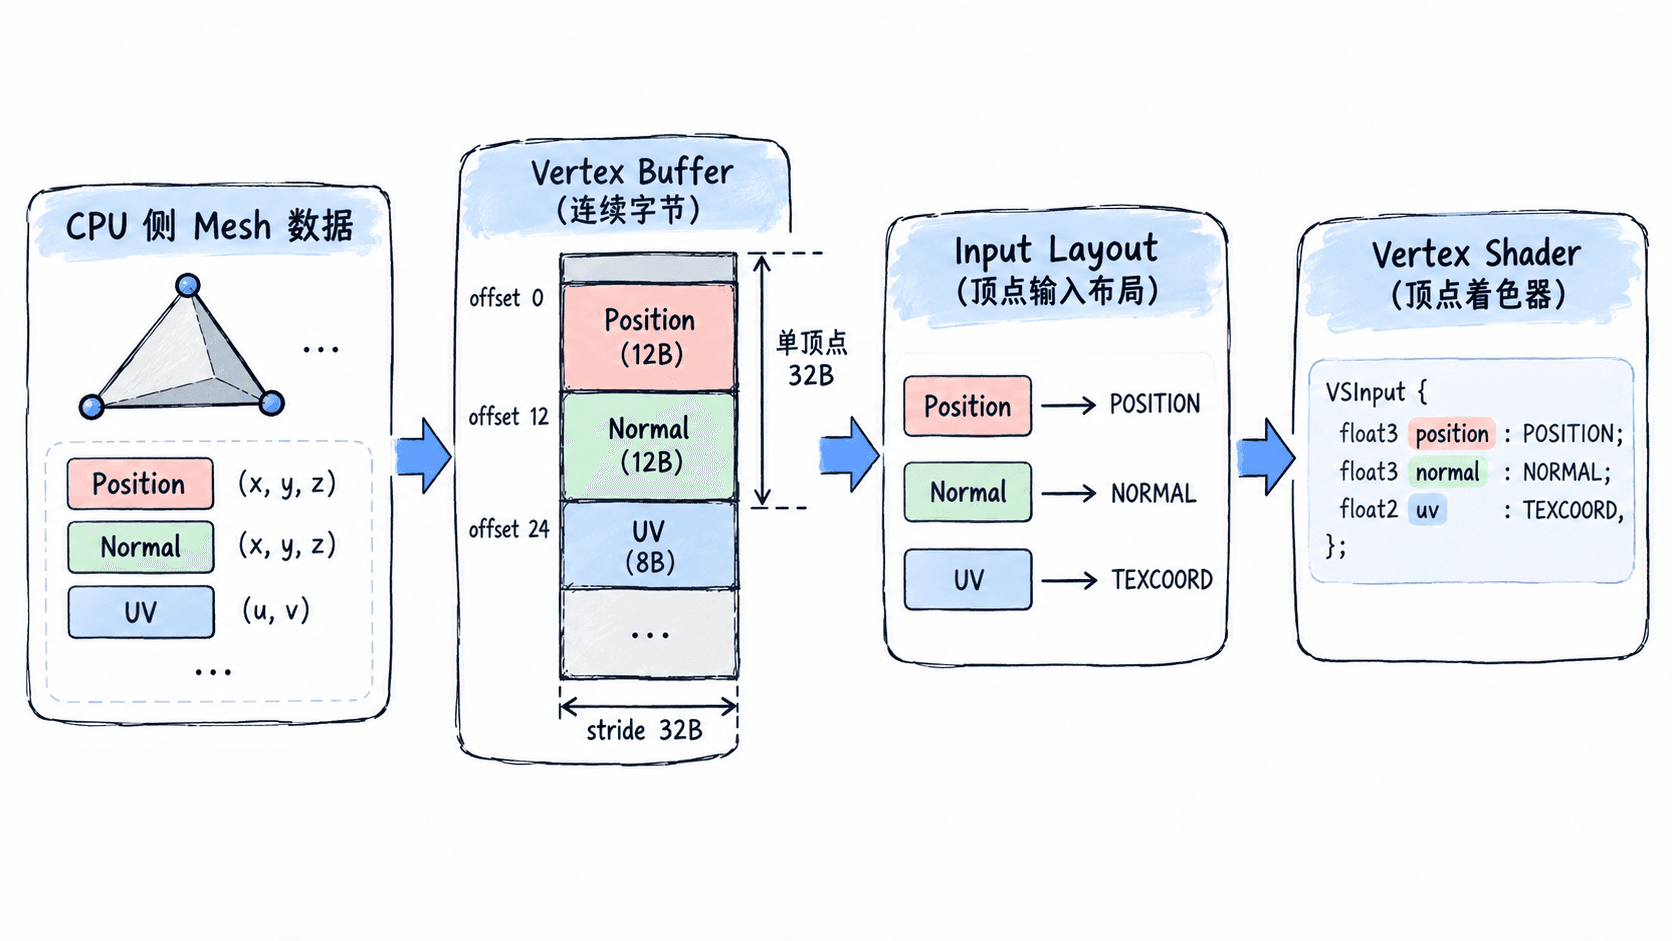
如果布局声明 Position 为 3 个浮点数,但实际缓冲区写入的是 4 个浮点数,后续属性的起点就可能整体错位。若格式把归一化整数误当成普通整数,读取到的数值范围也会完全不同。因此“类型、偏移、步长”必须作为一个整体核对。
绘制时数据怎样被取出
一次绘制通常先绑定图形管线,再绑定一个或多个 Vertex Buffer,并在需要时绑定 Index Buffer。随后发出绘制命令。GPU 的顶点输入阶段根据顶点编号或索引找到对应记录,再按输入布局提取各属性,最终把结构化数值送入顶点着色器。
如果使用索引绘制,Index Buffer 保存的是“使用哪个顶点”的编号,而不是完整顶点数据。多个三角形可以复用同一个顶点索引,减少重复存储;真正的位置、法线和 UV 仍来自 Vertex Buffer。
看到几何错乱时先查布局
如果模型整体炸开、UV 像随机数、法线方向异常,而索引数量又看起来正常,优先检查顶点输入而不是先改着色器算法。最有效的顺序是核对 stride,再核对每个属性的 offset 和格式,最后确认缓冲区绑定槽位与着色器输入一一对应。
一个实用判断是只保留 Position 属性做最小绘制:如果几何恢复正常,再逐项加回 Normal、UV 与 Tangent。这样可以迅速定位是哪一项属性的格式或偏移破坏了整条输入链路,而不必同时怀疑模型、矩阵和材质。