
图形渲染与 Shader / 系统课时
纹理采样为什么会变贵
纹理采样为什么会变贵
纹理采样不是简单地按 UV 读取一个数组元素。GPU 还要决定访问哪个 Mip 层级、取得哪些纹素、执行过滤并处理缓存命中情况;当采样次数、过滤范围和数据带宽同时增加时,片元阶段很容易从算术受限转为纹理或带宽受限。
学习目标
- 理解一次纹理采样背后的 Mip 选择、纹素读取和过滤过程
- 判断采样次数、过滤方式与缓存局部性怎样影响成本
- 能用减少采样和改善访问方式验证纹理是否是当前瓶颈
一次 texture 调用背后发生什么
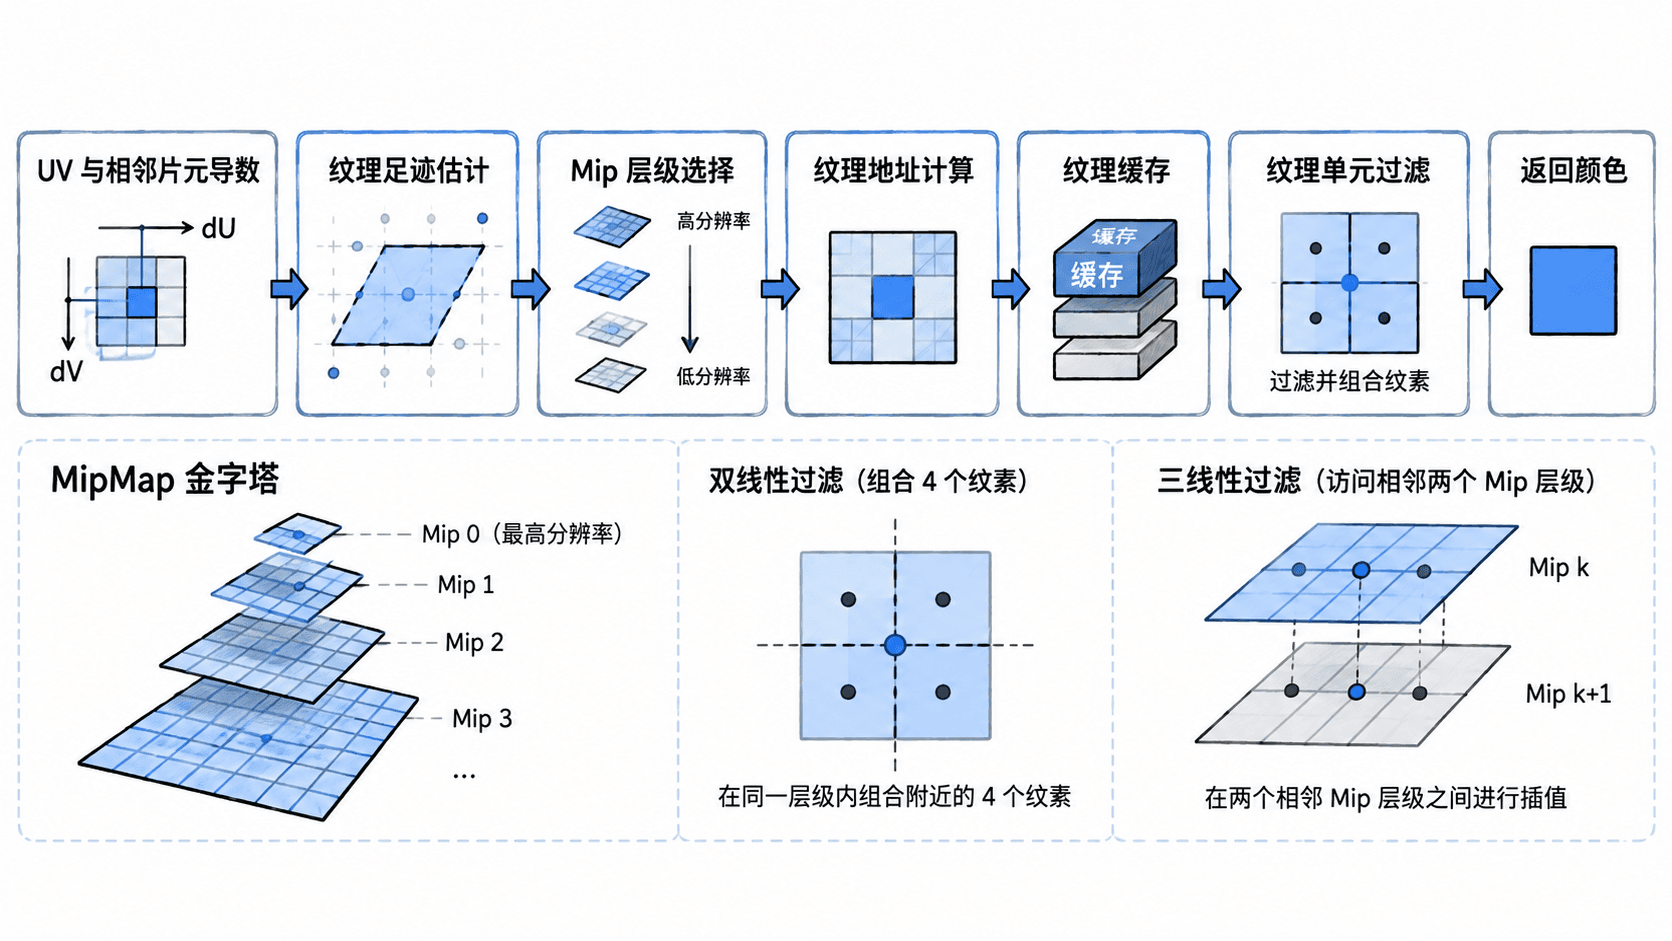
片元着色器调用 texture() 后,纹理单元首先根据纹理坐标以及相邻片元形成的坐标变化估计屏幕上的纹理覆盖范围,并据此选择合适的 Mip 层级。随后才会读取需要的纹素、执行过滤并返回采样结果。
双线性过滤通常需要组合目标 Mip 层级附近的多个纹素;三线性过滤还会在两个相邻 Mip 层级之间继续插值;各向异性过滤面对倾斜表面时可能沿纹理足迹读取更多位置。因此,一条采样指令并不等同于一次物理内存读取。
MipMap 为什么通常反而更省
远处物体的一个屏幕像素可能覆盖原始纹理中的大量纹素。如果始终读取最高分辨率纹理,不仅容易产生闪烁和摩尔纹,还会浪费带宽,因为最终仍需把大范围信息压缩到一个片元结果中。
MipMap 预先保存逐级缩小的纹理。GPU 根据纹理在屏幕上的投影尺度选择较小层级,可以用更少的数据近似原本的大面积纹理信息。虽然三线性过滤会同时读取两个 Mip 层级,但合适的 Mip 选择通常仍能显著改善缓存局部性并减少高分辨率纹理访问。
缓存和访问方式决定真实代价
纹理缓存擅长处理相邻片元访问相邻纹素的情况。一个三角形内部连续变化的 UV 往往具有良好的空间局部性,同一小块纹理数据可以被多个片元重复利用。
成本容易升高的情况包括随机或剧烈跳变的 UV、特别大的工作集、多个不同纹理交替读取,以及先根据一次采样结果再计算下一次采样坐标的依赖式读取。这些模式会降低缓存复用,使纹理单元更频繁地等待数据。
纹理压缩也会影响带宽。合适的 GPU 纹理压缩格式可以让更多纹素进入相同缓存容量,并减少显存传输量;但具体格式是否适合颜色、法线或高精度数据,需要结合平台和画质要求判断。
采样次数为什么会快速累积
一个材质看起来只输出一次颜色,并不代表只采一次纹理。基础色、法线、粗糙度、阴影和环境遮蔽就可能分别产生采样;后处理中的模糊、抗锯齿和屏幕空间效果还常常需要读取多个邻域位置。
下面用四个邻域采样实现最简单的盒式过滤。片段示例依赖顶点阶段提供 vUV,宿主程序需要绑定输入纹理,并把 uTexelSize 设置为纹理宽高的倒数。
#version 300 es
precision highp float;

in vec2 vUV;

uniform sampler2D uSource;
uniform vec2 uTexelSize;

out vec4 outColor;

void main() {
    // 半个纹素偏移让四个采样点分布在当前 UV 周围。
    vec2 d = uTexelSize * 0.5;

    vec4 c0 = texture(uSource, vUV + vec2(-d.x, -d.y));
    vec4 c1 = texture(uSource, vUV + vec2( d.x, -d.y));
    vec4 c2 = texture(uSource, vUV + vec2(-d.x,  d.y));
    vec4 c3 = texture(uSource, vUV + vec2( d.x,  d.y));

    // 四个样本平均后形成轻微平滑效果。
    outColor = (c0 + c1 + c2 + c3) * 0.25;
}
预期结果
画面会产生轻微邻域平滑效果;每个片元执行 4 条 texture() 采样调用。实际显存访问次数仍取决于过滤方式、缓存命中和 GPU 实现。如果这个着色器覆盖 1920×1080 的全屏目标,那么仅这一 Pass 就会产生约两百万次片元调用,而代码又为每个片元安排四次纹理采样。继续扩展到 9 点、16 点甚至更多邻域时,采样压力会按每片元的指令数量继续放大。
怎样确认纹理采样真的是瓶颈
不要仅凭 shader 中 texture() 的数量判断性能。更可靠的方法是做受控实验:保持输出分辨率和其他逻辑不变,把部分采样临时替换为常量或减少邻域数量,再比较 GPU 帧时间。如果时间明显下降,说明纹理读取或相关带宽很可能占据了重要成本。
还可以分别尝试降低渲染目标分辨率、启用合适的 MipMap、减少重复采样、打包可共同读取的材质数据,或选用平台支持的纹理压缩格式。每次只改变一个因素,才能判断真正起作用的是采样次数、缓存局部性还是内存带宽。
纹理采样最值得优化的通常是覆盖面积大的材质和全屏效果。少量模型上的一次额外采样可能无关紧要,而全屏 Pass 中每个片元增加数次读取,就可能把额外成本放大到数百万次采样调用。