
图形渲染与 Shader / 系统课时
GPU 同步为什么容易出错
GPU 同步为什么容易出错
GPU 同步难,不是因为 Fence 或 Semaphore 名字多,而是因为你必须同时回答“谁等谁”“等到什么完成”“资源何时可见”三个问题。CPU、多个队列和同一资源的读写依赖属于不同层次,混在一起最容易形成卡死或数据竞争。
学习目标
- 区分 CPU-GPU、队列之间和资源访问之间的同步
- 理解 Fence、Semaphore 与 Barrier 分别解决什么问题
- 能按依赖方向检查常见的等待错误和资源可见性问题
先把三类同步分开
CPU-GPU 同步解决的是主机什么时候可以确认一批 GPU 工作已经结束,例如复用一帧的命令缓冲或销毁临时资源。Fence 常用于这种“GPU 完成后通知 CPU”的场景。
队列之间同步解决的是一条队列的工作必须在另一条队列完成某个点之后才能开始,例如计算队列先写纹理,图形队列再采样。Semaphore 更适合表达这种 GPU 内部的先后关系。
资源之间的同步还多一层要求:即使执行顺序正确,也必须保证前一次写入对后一次读取可见。Barrier 或资源状态转换承担的就是这部分职责。只等待而没有正确的内存可见性约束,仍可能读到未准备好的数据。
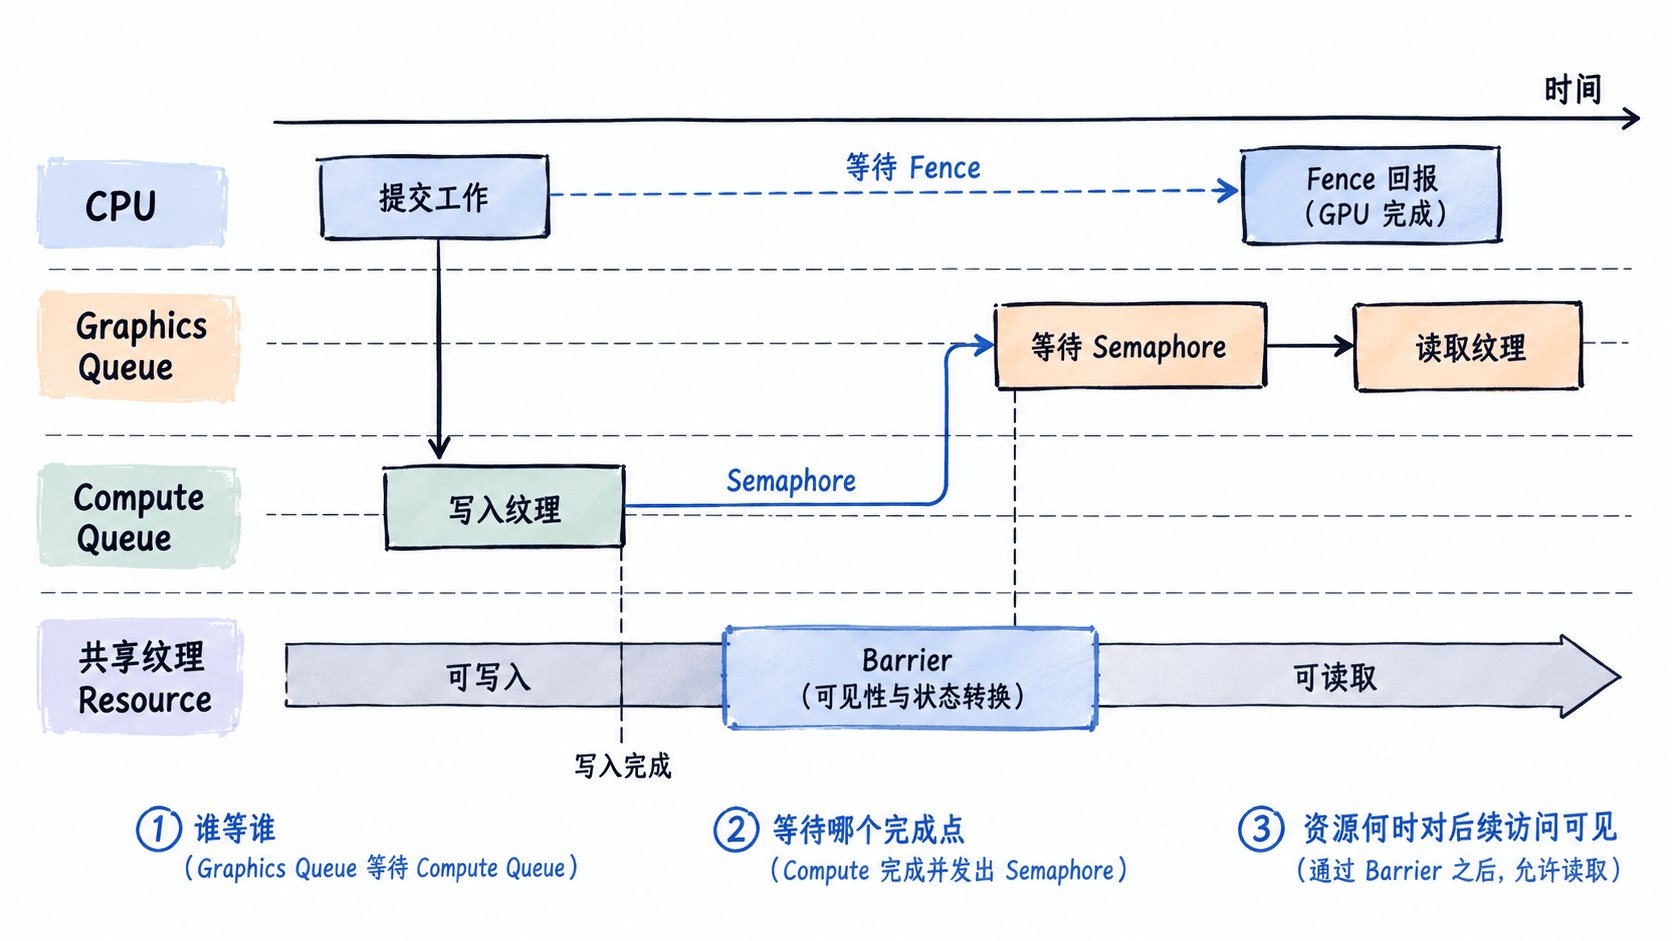
Fence、Semaphore、Barrier 不能互相替代
Fence 的典型方向是设备到主机:CPU 提交命令后继续做别的事,真正需要复用资源时再等待 Fence。把 CPU 每帧都立刻等待,会把并行流水线退化成串行。
Semaphore 的典型方向是 GPU 工作之间:提交 B 时声明必须等待提交 A 发出的信号。它适合跨提交甚至跨队列建立依赖,但它本身并不自动替你描述一个图像从“计算写”到“着色器读”的访问范围。
Barrier 描述执行与内存依赖,告诉 GPU 哪类早期访问必须在后续哪类访问之前完成,并使对应写入对后续读取可见。在显式 API 中,正确同步通常是“队列顺序或 Semaphore + 合适的 Barrier”,而不是只挑一个原语。
一个提交链怎样把职责分开
下面是片段示例,假定命令缓冲、队列、二进制 Semaphore 和 Fence 已创建。这里用两个提交说明“GPU 等 GPU”与“CPU 等 GPU”分别放在哪里。
VkPipelineStageFlags waitStage =
    VK_PIPELINE_STAGE_FRAGMENT_SHADER_BIT;

VkSubmitInfo firstSubmit{};
firstSubmit.sType = VK_STRUCTURE_TYPE_SUBMIT_INFO;
firstSubmit.commandBufferCount = 1;
firstSubmit.pCommandBuffers = &computeCmd;
firstSubmit.signalSemaphoreCount = 1;
firstSubmit.pSignalSemaphores = &computeFinished;

vkQueueSubmit(computeQueue, 1, &firstSubmit, VK_NULL_HANDLE);

VkSubmitInfo secondSubmit{};
secondSubmit.sType = VK_STRUCTURE_TYPE_SUBMIT_INFO;
secondSubmit.waitSemaphoreCount = 1;
secondSubmit.pWaitSemaphores = &computeFinished;
secondSubmit.pWaitDstStageMask = &waitStage;
secondSubmit.commandBufferCount = 1;
secondSubmit.pCommandBuffers = &graphicsCmd;

vkQueueSubmit(graphicsQueue, 1, &secondSubmit, frameFence);
这里 computeFinished 只负责让第二次提交等待第一次提交的信号,frameFence 则在第二次提交全部完成后变为已发信号状态,供 CPU 查询或等待。若 computeCmd 写入的资源随后被 graphicsCmd 读取,还需要在命令缓冲内加入与真实访问类型匹配的 Barrier;仅有 Semaphore 不能替代资源访问范围与可见性的描述。
最容易出现的三种错误
第一类是等待环。队列 A 等队列 B 的信号,同时 B 又直接或间接等待 A,任何一方都无法前进。定位时从每个 wait 点反向追踪对应 signal,确认依赖图最终能回到一个不依赖其他 GPU 工作的起点。
第二类是过度同步。最常见表现是 CPU 每帧提交后立即等待 Fence,或者用覆盖范围过大的 Barrier 把无关阶段全部串起来。程序通常“能跑但不快”,因为本可并行的工作被人为排队。
第三类是顺序正确但内存依赖错误。日志看起来提交顺序没有问题,GPU 也没有死锁,但画面偶发闪烁、读取旧数据或 Validation 报资源状态冲突。这时应检查生产者的写阶段、消费者的读阶段、访问掩码与资源状态是否真正匹配,而不是继续叠加更多 Semaphore。
用依赖链而不是原语名排查
排错时先画出生产者和消费者,再决定原语。先问“谁产生数据”,再问“谁消费数据”,最后确定两者是否在同一队列。如果跨队列,需要队列级信号;如果 CPU 要知道完成点,需要 Fence;只要资源从写变读或用途改变,就继续检查 Barrier 与状态转换。
同步正确性的目标不是让所有东西都等,而是只建立真实存在的数据依赖。依赖越精确,越容易验证,也越能保留 GPU 并行度。