
图形渲染与 Shader / 系统课时
Draw Call 到底提交了什么
Draw Call 到底提交了什么
一次 Draw Call 不是“让 GPU 画一个模型”这么简单。它真正表达的是:使用哪些几何数据、着色程序、纹理与渲染状态,以什么参数发起一次绘制。理解这些组成,才能判断提交次数为什么会影响 CPU 开销,以及合批为什么有效。
学习目标
- 说清一次 Draw Call 依赖的几何、资源、状态和绘制参数
- 区分 CPU 提交命令与 GPU 实际执行绘制两个阶段
- 判断减少 Draw Call 能优化什么,以及它不能解决什么
一次绘制需要哪些信息
从渲染器视角看,单独一个“绘制三角形”的命令并不足够。GPU 必须先知道顶点从哪里读取、执行哪套着色程序、采样哪些纹理,以及深度测试和混合等规则如何设置。
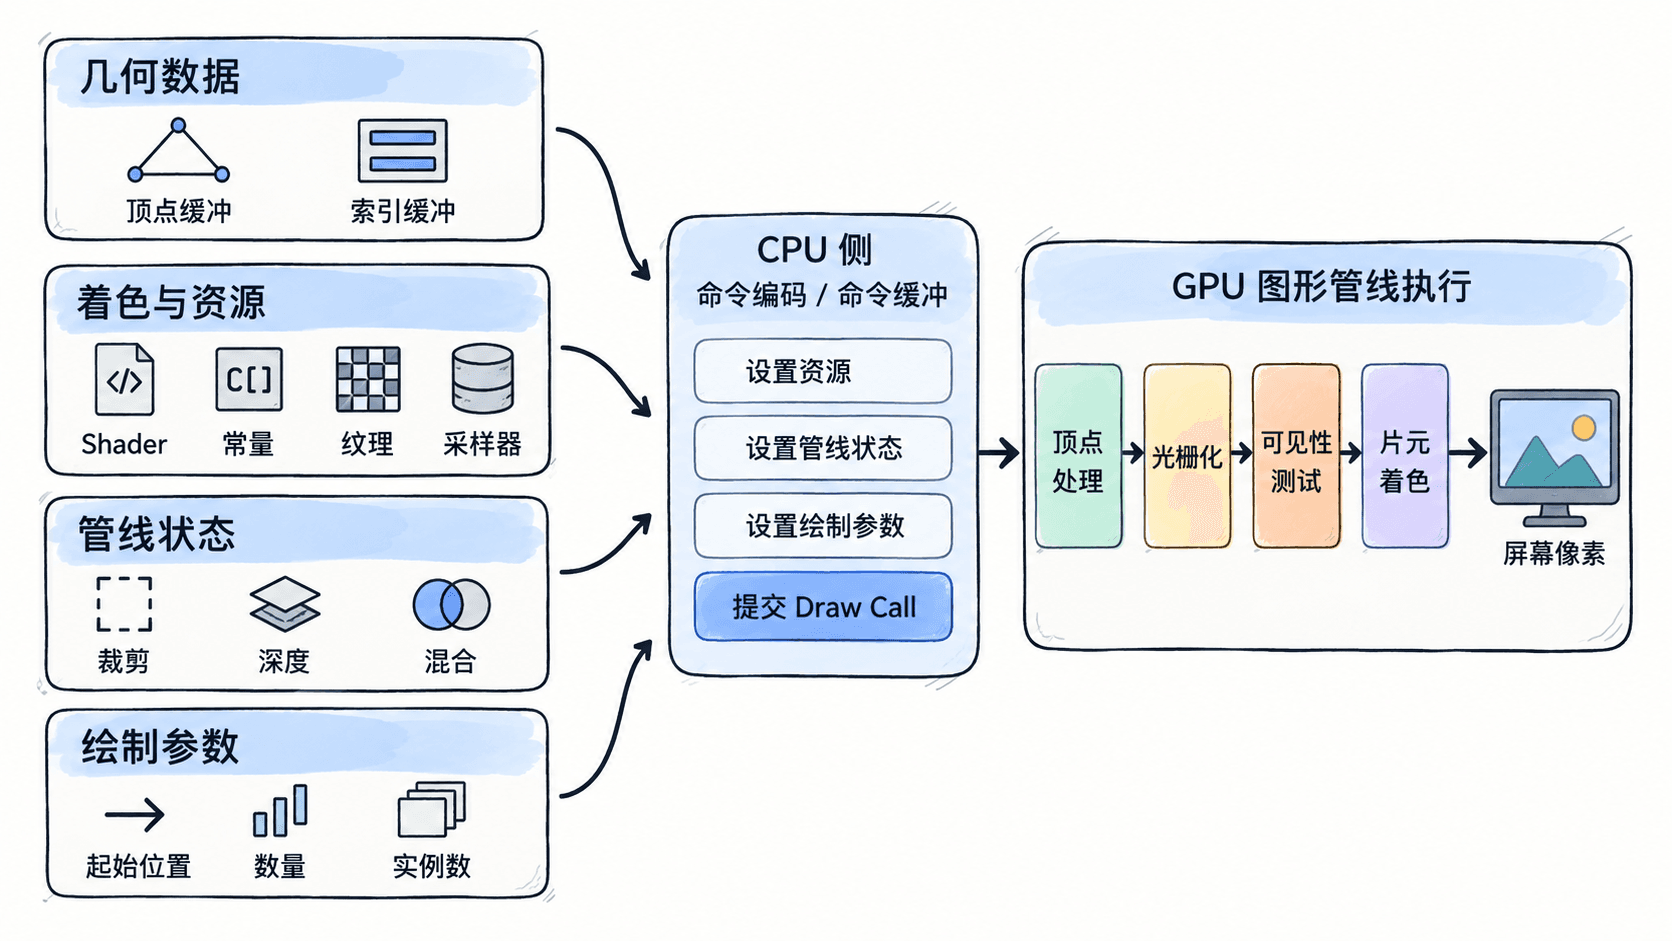
一次完整绘制通常依赖四类信息:
- 几何数据:顶点缓冲、索引缓冲,以及顶点属性的解释方式。
- 着色与资源:顶点着色器、片元着色器,以及着色器需要的常量、纹理、采样器等资源。
- 管线状态:例如图元类型、裁剪、深度测试、模板测试、混合和写入掩码。
- 绘制参数:例如从哪个索引开始、绘制多少个索引、实例数量是多少。
这些信息有些会预先组合成管线状态对象,有些以资源绑定或动态状态单独提供,具体组织方式取决于图形 API,但核心问题始终相同:GPU 必须拥有足够上下文,才能解释这条绘制命令。
Draw Call 不等于立即执行
在现代图形 API 中,应用通常先在 CPU 上设置状态、绑定资源并记录绘制命令,再把一批命令提交给 GPU。调用绘制接口的那个瞬间,并不意味着对应像素已经出现在屏幕上。
可以把过程理解为:CPU 描述“接下来怎么画”,命令进入命令缓冲或驱动管理的队列,GPU 随后按照依赖关系和执行顺序处理这些工作。CPU 与 GPU 因此可以并行推进不同帧或不同阶段的任务。
这一区分也解释了为什么性能分析不能只看某个 Draw Call 本身执行了多久。CPU 侧可能消耗在状态切换、资源绑定、命令编码和驱动处理上,GPU 侧则可能消耗在顶点处理、光栅化、片元着色和内存访问上。
为什么大量 Draw Call 会产生提交成本
假设场景里有 1000 个小物体,每个物体都需要单独切换资源并发出绘制命令。即使每个物体只有很少的三角形,CPU 仍需要重复完成大量状态准备、资源绑定和命令记录工作。
因此常见优化手段会尝试减少重复提交,例如把兼容的网格合批、使用实例化绘制,或者按照材质和管线状态排序。它们的共同目标不是“让一个三角形更便宜”,而是让更多几何共享一次状态准备和一次绘制描述。
合批也有边界
减少 Draw Call 主要解决提交与状态管理成本,并不会自动减少像素着色、纹理采样或显存带宽。如果把大量彼此不可见或材质差异很大的物体强行合并,还可能增加剔除粒度、内存占用或无效绘制。
判断是否值得合批时,应同时观察两端:如果 CPU 渲染线程因大量小绘制而繁忙,降低 Draw Call 往往有效;如果 GPU 已经被高分辨率、复杂片元着色或大量重叠像素压满,仅减少提交次数通常不会消除主要瓶颈。
理解 Draw Call 的关键,是把它看成一份完整的绘制工作描述,而不是一个孤立的“画模型”函数。优化时也应先确认昂贵的是提交、状态切换,还是命令真正进入 GPU 后产生的几何与像素工作。