
图形渲染与 Shader / 系统课时
Command Buffer 记录了什么
Command Buffer 记录了什么
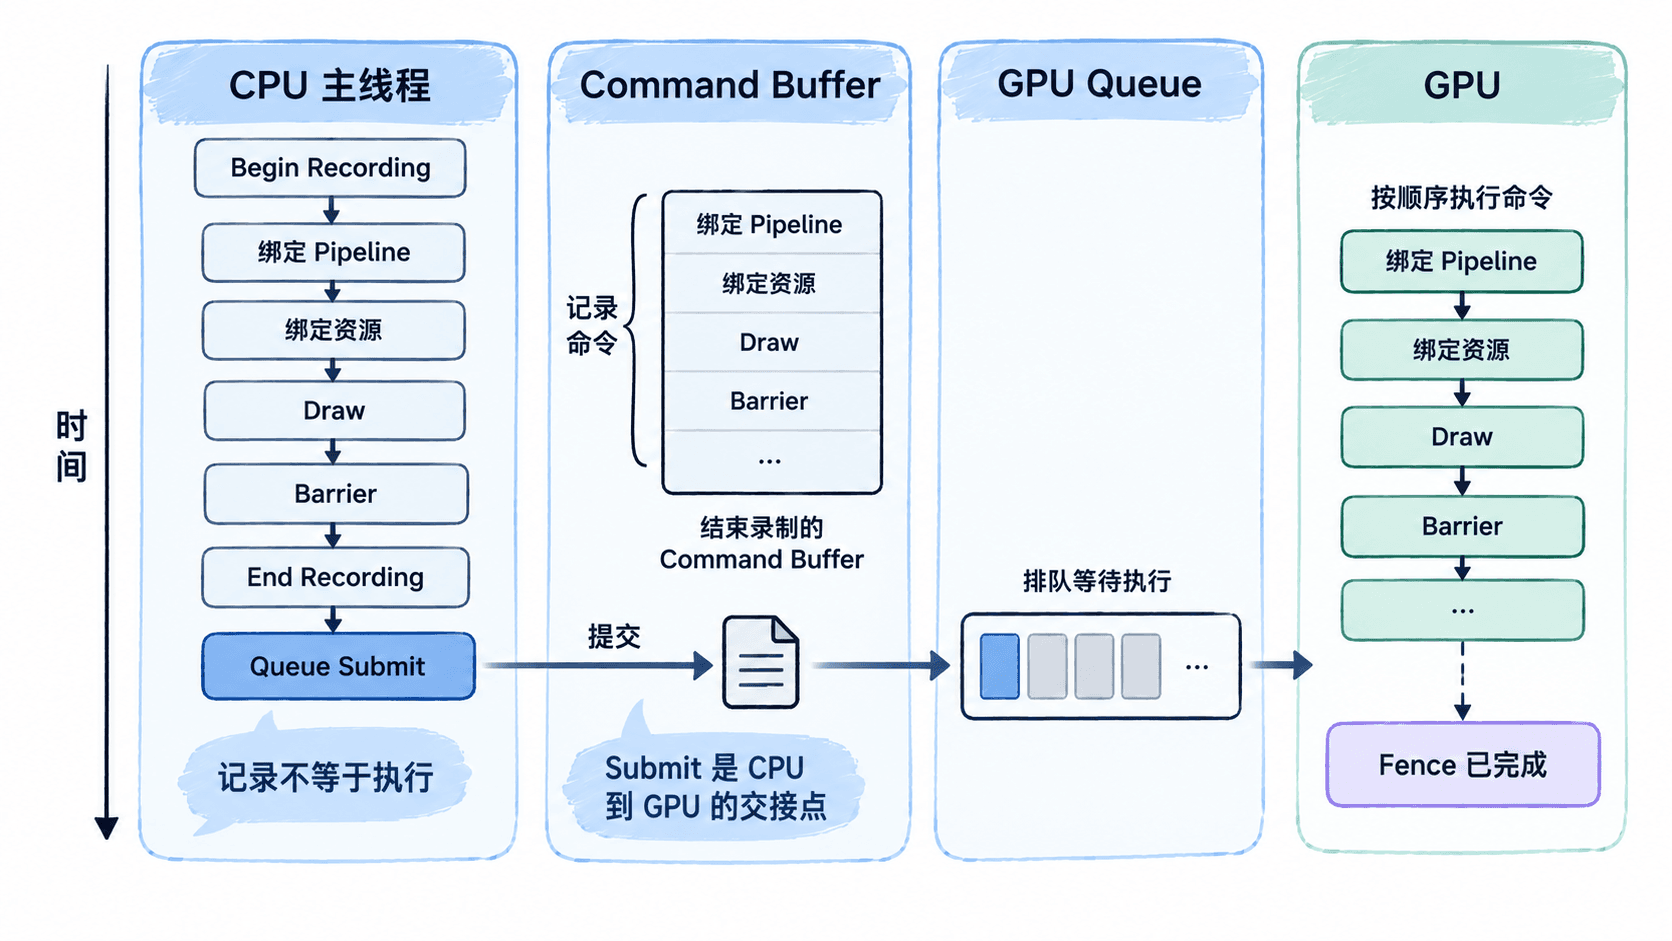
调用一次绘制 API 并不意味着 GPU 当场开始画这一帧。现代显式图形 API 通常先让 CPU 把绘制、资源绑定、状态设置和同步命令写入 Command Buffer,再把完整命令序列提交到 GPU 队列执行。理解这个边界,是理解多线程录制和帧同步的基础。
学习目标
- 理解 Command Buffer 中记录的是 GPU 工作描述,而不是立即执行的结果。
- 能区分命令记录、队列提交和 GPU 实际执行三个阶段。
- 理解资源引用与同步信息为什么必须在提交前保持一致。
记录阶段只是在构造工作序列
Command Buffer 可以把一次渲染所需的操作按顺序组织起来,例如开始渲染、绑定 Pipeline、绑定顶点缓冲、绑定描述符、发出绘制命令、插入资源屏障以及结束渲染。CPU 在这个阶段主要是在构造 GPU 将来要执行的命令序列。
因此,记录 draw 命令时,GPU 并不一定已经执行它。CPU 可以继续准备后续 Command Buffer,甚至由多个线程并行录制彼此独立的命令。真正把这些工作交给 GPU 的边界通常是 Queue Submit。
Command Buffer 里有哪些信息
它记录的内容可以分成三类。第一类是工作命令,如 Draw、Dispatch、Copy;第二类是执行这些工作的上下文,例如绑定哪个 Pipeline、Descriptor Set、Vertex Buffer;第三类是同步与资源转换信息,例如 Barrier。
Command Buffer 通常记录的是对资源和状态对象的引用,而不是把所有资源内容复制进去。这意味着在 GPU 完成相关提交之前,应用不能随意销毁被引用的 Pipeline、Buffer、Image 等对象,也不能复用仍被 GPU 使用的临时资源。
下面的 Vulkan 片段展示“记录”和“提交”的边界。示例假设已经进入有效的渲染范围,并且 pipeline、vertexBuffer、commandBuffer、queue 与 fence 都已正确创建。
VkCommandBufferBeginInfo beginInfo{};
beginInfo.sType = VK_STRUCTURE_TYPE_COMMAND_BUFFER_BEGIN_INFO;

vkBeginCommandBuffer(commandBuffer, &beginInfo);

vkCmdBindPipeline(
    commandBuffer,
    VK_PIPELINE_BIND_POINT_GRAPHICS,
    pipeline);

VkDeviceSize offset = 0;
vkCmdBindVertexBuffers(
    commandBuffer,
    0,
    1,
    &vertexBuffer,
    &offset);

vkCmdDraw(commandBuffer, 3, 1, 0, 0);

vkEndCommandBuffer(commandBuffer);

VkSubmitInfo submitInfo{};
submitInfo.sType = VK_STRUCTURE_TYPE_SUBMIT_INFO;
submitInfo.commandBufferCount = 1;
submitInfo.pCommandBuffers = &commandBuffer;

vkQueueSubmit(queue, 1, &submitInfo, fence);这是片段示例:它依赖完整的 Vulkan 初始化与有效渲染范围,不能单独运行。vkCmdDraw 只是把绘制命令写进 Command Buffer;直到 vkQueueSubmit,这组命令才进入 GPU 队列。验证时可以在图形调试器中捕获一帧,检查提交后的命令序列和实际 Draw Call 顺序。
提交之后 GPU 才接管工作
Queue Submit 把一个或多个已经结束录制的 Command Buffer 交给指定 GPU 队列。提交之后,CPU 通常不需要等待 GPU 立刻完成,可以继续处理下一帧;队列会按照 API 定义以及信号量、屏障等同步条件决定何时执行。
这也是 Fence 和 Semaphore 分工的来源。Fence 常用于让 CPU 知道某次 GPU 提交何时完成,例如决定某个 Command Buffer 或帧资源能否复用;Semaphore 更常用于 GPU 工作之间建立跨提交甚至跨队列依赖。Command Buffer 本身负责描述“做什么”,同步对象负责约束“什么时候可以做”。
什么时候可以重置和复用
一个 Command Buffer 被提交后,只要 GPU 仍可能执行其中的命令,就不能把它当成空闲对象直接重录。典型做法是为每个飞行中的帧准备独立的 Command Buffer 和 Fence:CPU 开始复用某帧资源前,先确认对应 Fence 已完成,再重置命令池或 Command Buffer。
把一帧理解成“CPU 记录命令 → 提交队列 → GPU 异步执行 → 完成信号返回”后,多帧并行、Command Buffer 复用以及后续的 Fence、Semaphore 同步就会落在同一套执行模型中。