
图形渲染与 Shader / 系统课时
Shader 分支为什么影响性能
Shader 分支为什么影响性能
Shader 里的 if 不一定慢,真正的风险来自同一执行组中的线程走向不同路径。此时 GPU 往往需要分阶段执行各分支并屏蔽不参与的线程。本节把动态分支、线程束分歧和着色器变体放到同一模型中,说明什么时候该保留分支,什么时候该换成变体。
学习目标
- 理解 warp、wave 等执行组发生分歧时的额外成本
- 区分统一条件、像素级动态条件与编译期着色器变体
- 能避免“为了去掉 if 反而执行更多计算”的常见优化误区
分支成本取决于执行组是否分歧
GPU 会把一组着色调用以 SIMD/SIMT 方式并行执行。不同厂商会使用 warp、wave 等不同名称和组大小,但共同点是:同一组线程通常共享指令推进节奏。
当组内所有线程的条件相同时,整个组只走一条路径,分支成本可能很低。若一部分线程走 if,另一部分走 else,硬件通常需要分别执行两条路径,并用掩码让不属于当前路径的线程暂时不写结果,这就是分歧。
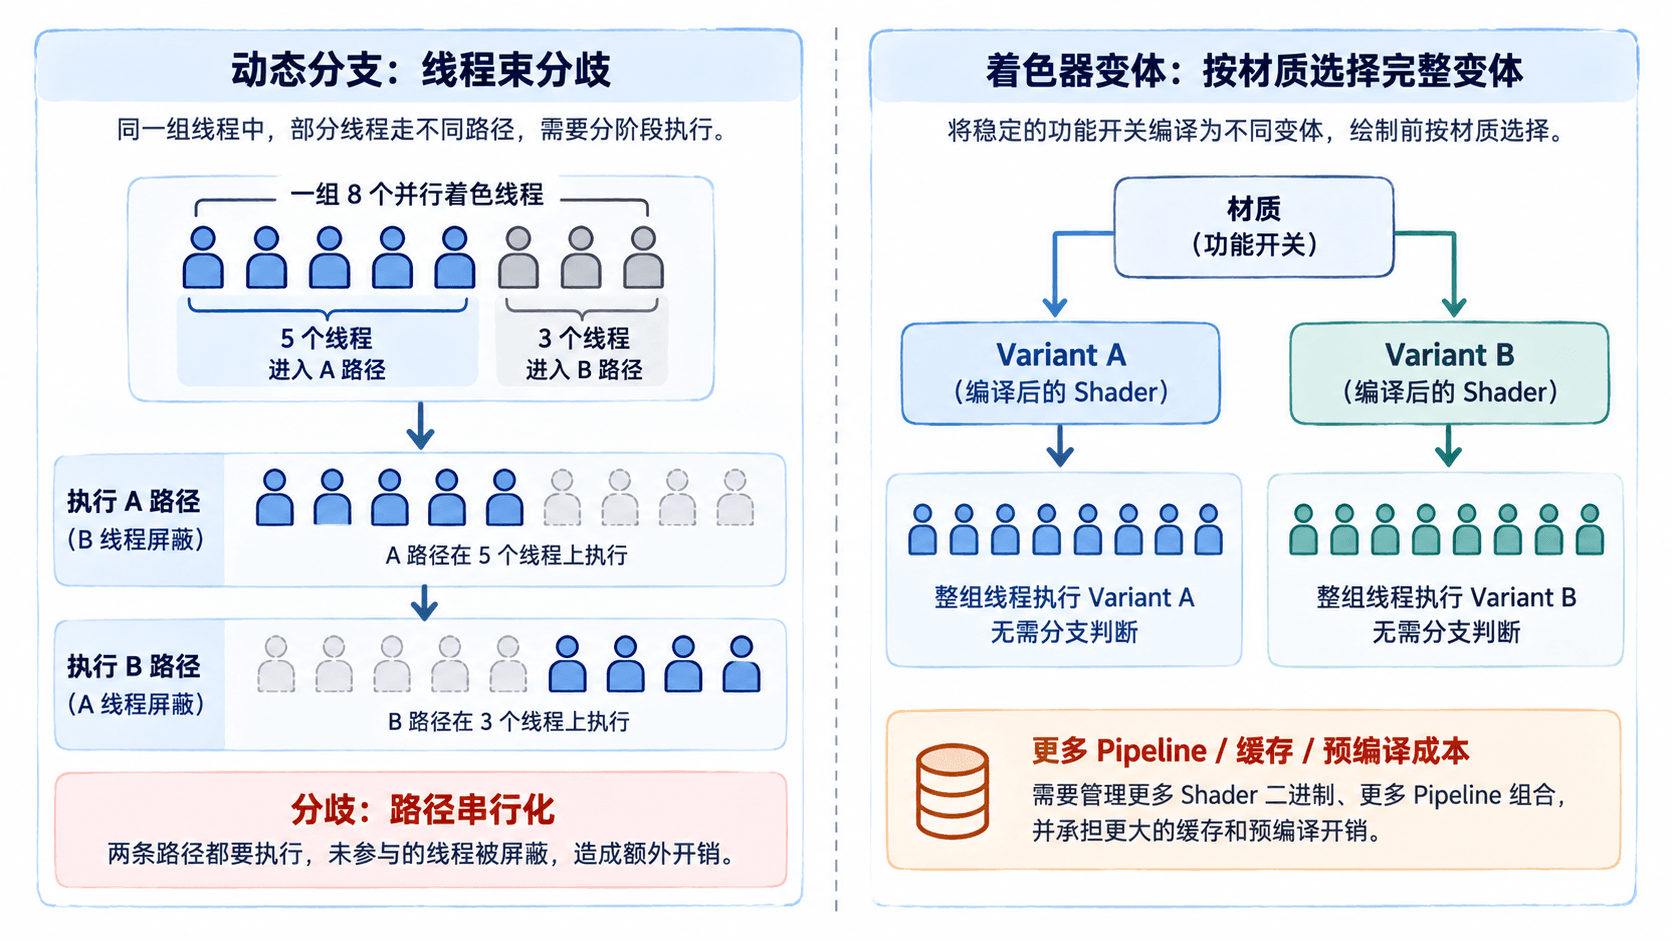
分歧的代价与分支体长度有关。如果两条路径都很短,影响可能不明显;如果两边包含多次纹理采样、复杂光照或循环,组内线程就可能为另一半线程“陪跑”较长时间。
哪些条件更容易造成高成本
判断一个分支前,先看条件来自哪里,而不是只看有没有 if。
| 条件来源 | 组内一致性 | 一般风险 |
|---|---|---|
| 每次 Draw 固定的材质开关 | 通常较高 | 低到中,编译器或硬件可能很好处理 |
| 顶点属性或实例数据 | 取决于批次组织 | 中,混合数据可能形成分歧 |
| 像素位置、噪声、纹理采样结果 | 往往变化剧烈 | 中到高,邻近像素也可能走不同路径 |
因此,“分支数量”不是可靠指标。一个每个像素都不同的昂贵分支,可能比多个全组一致的材质开关更值得优化。
用着色器变体移走稳定功能开关
如果某个功能在一次绘制期间始终固定,例如是否使用法线贴图,可以把它变成编译期宏,生成不同 Shader 变体。这样运行时不必为这个功能判断动态条件。
下面是片段示例,需要由构建系统分别以定义或不定义 USE_NORMAL_MAP 的方式编译两个变体,不能独立运行。
vec3 resolveNormal(vec3 geometricNormal, vec3 tangentNormal)
{
#ifdef USE_NORMAL_MAP
    // 变体开启时只保留法线贴图路径。
    return normalize(tangentNormal);
#else
    return normalize(geometricNormal);
#endif
}
变体把运行时分支换成了资源管理成本:更多 Shader 二进制、更多 Pipeline 组合、更大的缓存压力,以及更复杂的预编译策略。功能组合一多,变体数量还可能快速膨胀,所以只适合处理稳定、可枚举且确实有性能价值的开关。
不要把所有 if 都改成无分支写法
常见误区是用 mix、数学插值或同时计算两边结果来“消灭分支”。如果两个候选结果都包含昂贵纹理采样,那么无分支写法可能让所有线程无条件执行两份工作,反而更慢。
更可靠的判断顺序是:先用 GPU Profiler 找到真正耗时的 pass,再确认瓶颈是否与分歧相关,最后用代表性场景比较动态分支、变体或重排数据后的 GPU 时间。还要同时观察 Shader 变体数量、Pipeline 创建时间和缓存占用,避免只优化单帧执行成本。
当条件在执行组内高度一致时,保留动态分支通常更简单;当条件高度发散且分支体很重时,才值得考虑数据重排或变体。性能优化的目标不是“代码里没有 if”,而是让 GPU 少做无效工作。