
图形渲染与 Shader / 系统课时
GPU 峰值后如何缩小范围
GPU 峰值后如何缩小范围
遇到单帧 GPU 时间突然冲高时,先把“这一帧很慢”转换成可验证的问题:是哪一段事件最贵、属于哪个渲染阶段、最终落到哪个 Draw 或 Dispatch。本文用帧捕获、事件排序和阶段对比建立一条可重复的定位闭环。
学习目标
- 从 GPU 峰值帧中筛出最可疑的渲染事件
- 用阶段耗时与事件排序把范围缩小到具体 Draw 或 Dispatch
- 通过前后帧和开关实验确认根因,而不是只看一次捕获
先拿到能解释峰值的捕获
捕获对象必须是“真正出现峰值的那一帧”,而不是附近随便一帧。先在性能曲线上确认峰值发生位置,再用 RenderDoc、PIX、Nsight Graphics 或引擎自带 GPU Profiler 捕获相邻帧,至少保留一个正常帧作为对照。工具名称可以不同,但需要能看到事件树、GPU 时间和 Draw/Dispatch 详情。
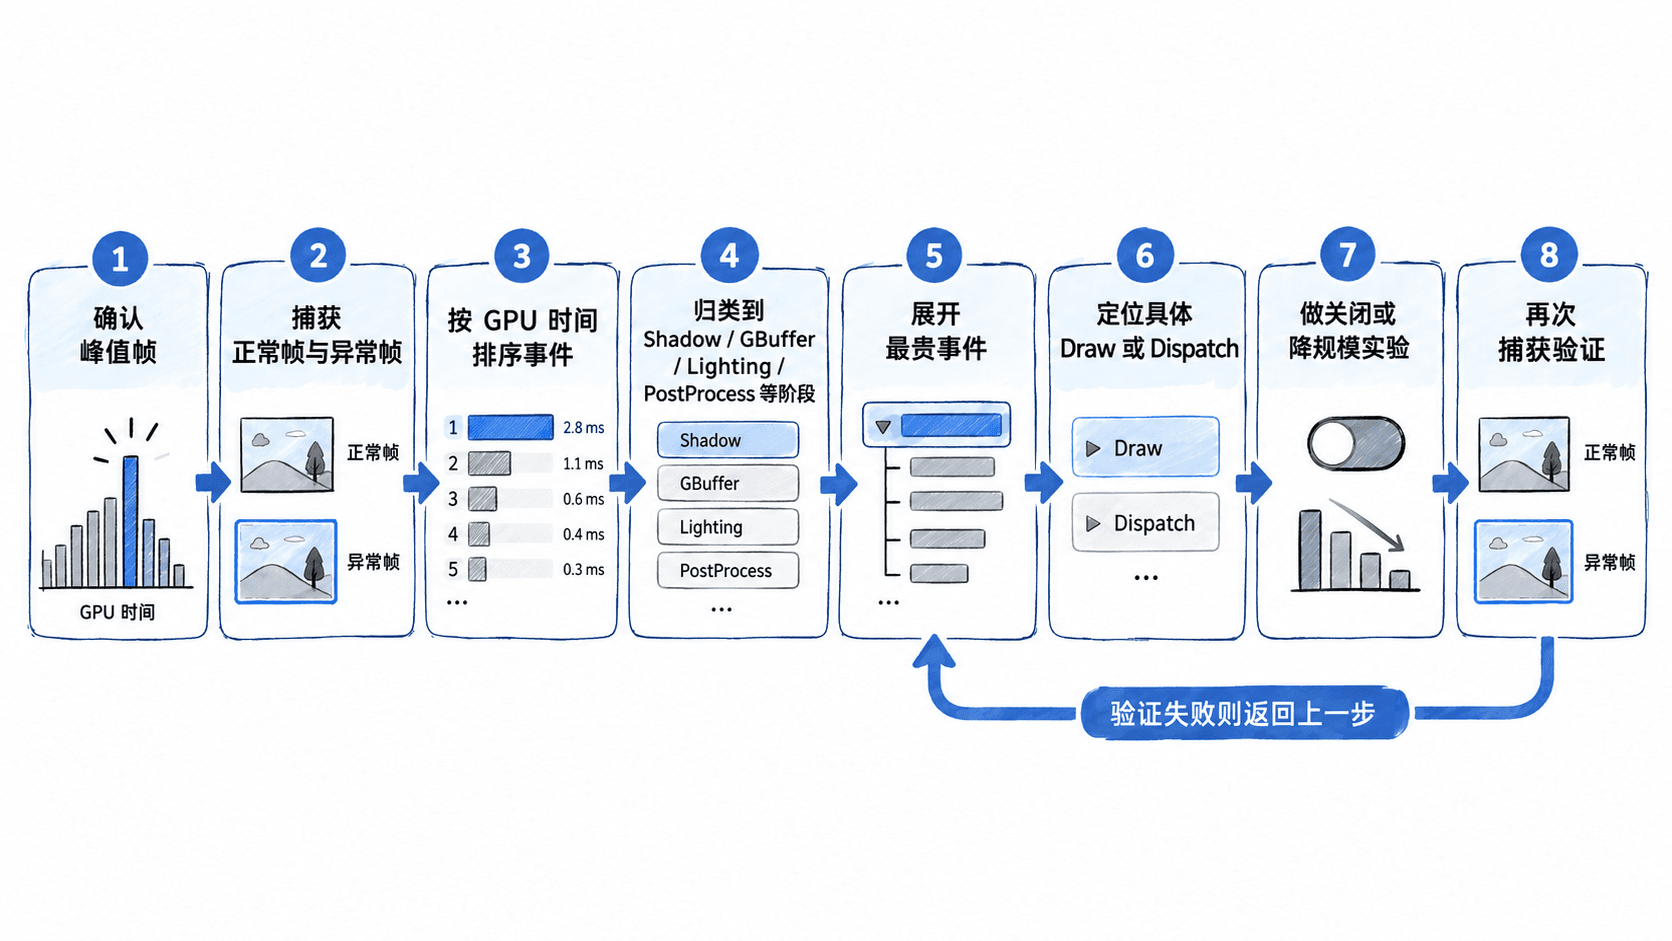
先看大阶段,不要一开始就钻进几千个 Draw。常见阶段包括阴影、深度预通过、GBuffer、不透明光照、透明、后处理和计算任务。若总 GPU 时间从 12 ms 变成 28 ms,而阴影阶段从 3 ms 变成 17 ms,那么范围已经从“整帧”缩到了“阴影”。
用排序找到最值得看的事件
事件树适合看层级,排序适合快速找重灾区。把捕获结果按 GPU 时间从高到低排序,再把异常帧与正常帧放在一起比较。关注的不是“谁最贵”这一条,而是“谁在异常帧里涨得最多”。
下面用一组教学数据演示这个判断。字段是自定义示例,不代表任何分析工具的导出格式。
events = [
    {"name": "Shadow/Cascade0", "normal_ms": 1.8, "spike_ms": 9.7},
    {"name": "GBuffer/Opaque", "normal_ms": 4.2, "spike_ms": 4.5},
    {"name": "Lighting/Deferred", "normal_ms": 2.6, "spike_ms": 2.9},
    {"name": "PostProcess/TAA", "normal_ms": 1.1, "spike_ms": 1.2},
]

for event in events:
    event["delta_ms"] = event["spike_ms"] - event["normal_ms"]

for event in sorted(events, key=lambda x: x["delta_ms"], reverse=True):
    print(f'{event["name"]}: +{event["delta_ms"]:.1f} ms')
预期输出
Shadow/Cascade0: +7.9 ms
GBuffer/Opaque: +0.3 ms
Lighting/Deferred: +0.3 ms
PostProcess/TAA: +0.1 ms
这个结果说明优先展开 Shadow/Cascade0,而不是继续平均地检查所有阶段。真实捕获中的耗时会因硬件、驱动和场景变化而不同,但“比较增量”比只看绝对值更容易找到突发峰值。
从阶段继续下钻到 Draw 或 Dispatch
进入最可疑阶段后,再按事件层级逐层展开。每次只问一个问题:耗时是在少量事件突然变贵,还是 Draw/Dispatch 数量突然增多。前者常见于分辨率、覆盖面积、复杂 Shader、纹理带宽或缓存失效;后者常见于可见性失控、实例数异常、阴影投射体暴增或重复提交。
定位到单个 Draw 后,应核对至少这些信息:渲染目标尺寸、顶点或索引数量、实例数、绑定的管线状态、关键纹理尺寸、Shader 变体、深度与混合状态。对于 Dispatch,则重点看线程组数量、每组线程数、读写资源尺寸和是否出现额外同步。
用最小实验确认根因
一次捕获只能说明“相关”,还不能证明“因果”。定位到可疑 Draw 后,要做最小开关实验:禁用该 Pass、减少实例、降低阴影级联数量、缩小渲染目标,或切换到简化 Shader,然后重新捕获同一场景。如果峰值同步消失,才算建立了因果证据。
最后再恢复原设置,只保留真正的修复,例如修正错误的可见性范围、去掉重复提交、限制异常纹理尺寸或替换高开销 Shader 变体。完整闭环应能回答四个问题:峰值在哪一帧、哪个阶段上涨、哪个 Draw 或 Dispatch 负责、修改后峰值是否消失。做到这一步,GPU 优化才从“猜测哪里慢”变成了可复现的工程定位。