
数据结构与算法 / 系统课时
按问题结构选择动态规划模型
按问题结构选择动态规划模型
没有“最长”“背包”“区间”之类关键词时,动态规划仍然可以系统建模。关键不是猜模板名称,而是观察问题如何分阶段推进、一次选择受到什么限制、当前答案依赖哪些更小问题,以及最终要求的是最值、计数还是可行性,再据此选择状态结构。
学习目标
- 从阶段、选择约束、依赖结构和答案类型四个角度拆解题目
- 根据结构判断更接近序列、背包、区间、树形或状态压缩 DP
- 在多个模型都看似可用时,用状态含义和依赖关系排除错误建模
先找问题怎样向前推进
动态规划必须存在某种可以逐步扩展的“阶段”。阶段不一定是时间,也可以是已经处理的元素数量、区间长度、树的层级、已经选择的集合或当前容量。
若题目天然按照下标从左到右处理,状态通常会包含位置 i,容易形成序列 DP。若每加入一个物品都需要考虑剩余容量,则阶段是物品集合的处理进度,容量成为另一个状态维度。若问题要求从短区间组合成长区间,阶段往往是区间长度,对应区间 DP。
一个有效的状态应该让“已经处理的部分”与“还未处理的部分”形成清楚边界。若定义状态后仍然不知道下一步究竟推进哪个量,往往说明阶段还没有找对。
再看选择受到什么约束
同样是逐个处理元素,不同约束会产生完全不同的模型。选择一个元素之后,真正影响未来的不是完整历史,而是历史中仍会约束后续决策的那部分信息。
例如,“总重量不能超过容量”意味着未来只关心已经占用了多少容量,因此背包 DP 会记录容量;“相邻元素不能同时选”意味着未来只需要知道前一个元素是否被选;“某些对象是否已经使用过”则可能需要一个二进制集合记录选择历史,从而进入状态压缩 DP。
用依赖结构识别模型家族
状态定义之后,观察一个状态依赖哪些更小状态,往往比关键词更能暴露模型类型。
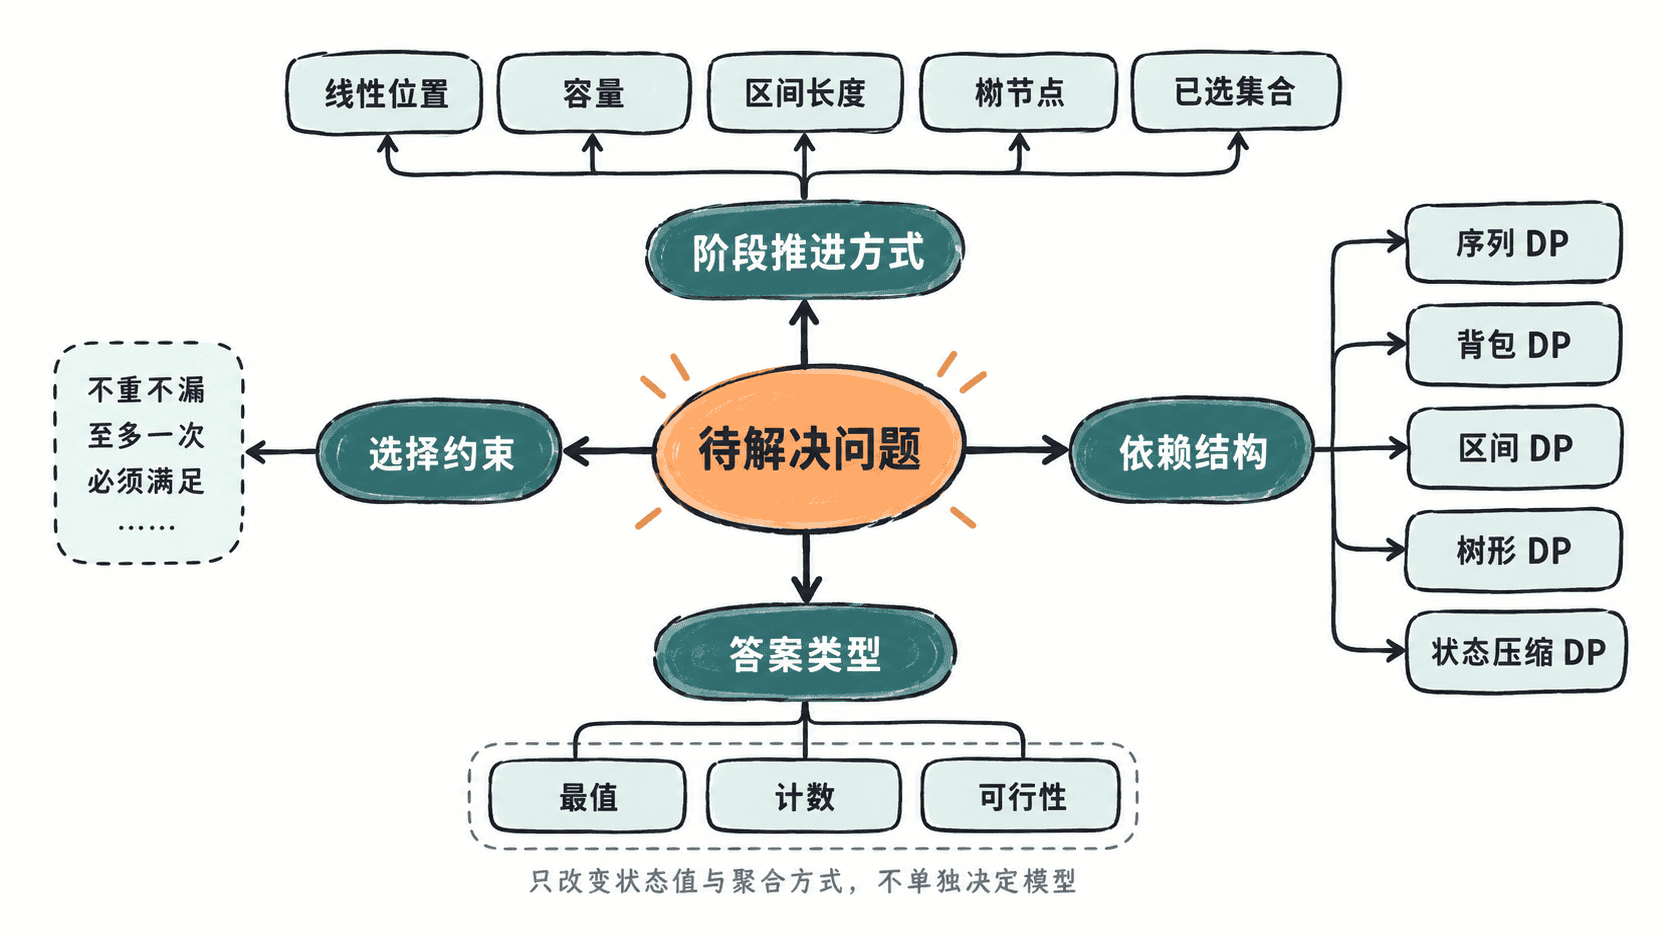
如果 dp[i] 只依赖较小下标,通常属于线性序列结构;如果 dp[l][r] 依赖更短的 [l, k]、[k+1, r],明显具有区间合并结构;如果父节点答案由若干子节点状态合并得到,则更接近树形 DP;如果 dp[mask] 依赖删除或加入某个元素后的集合,则核心结构是子集关系。
这一步还可以检查计算顺序。合法 DP 必须让依赖指向已经能够计算的状态。如果某个定义产生难以打破的循环依赖,通常不是简单调整遍历方向就能解决,而应重新判断状态是否缺少阶段信息。
最值、计数和可行性决定状态里存什么
问题结构决定“状态有哪些”,答案类型则决定“状态值是什么以及怎样合并”。这两个层次不要混在一起。
求最小代价时,状态值通常保存当前条件下的最小值,转移使用 min;求最大收益则使用 max;求方案数会把不同合法前驱的数量相加;只判断能否达到某个状态时,则保存布尔值并使用逻辑或。
因此,同一个背包结构既可以问最大价值,也可以问方案数或是否恰好装满。它们仍属于相同的阶段与容量模型,只是状态值和聚合运算不同。看到“求方案数”就单独寻找某个计数模板,反而容易忽略真正决定维度的选择约束。
多个模型都像时怎样排除
一道题可能同时出现序列、区间和选择限制,此时不要根据表面特征投票,而要比较哪种状态能够完整描述未来。
假设一次决策会把一个连续区间拆成左右两个独立子问题,那么区间边界通常必须进入状态,仅用当前位置 i 无法表达两个方向的剩余问题。反过来,如果从左到右处理后,过去元素不会再被访问,只留下一个累计容量或有限状态,那么保留整个区间显然是冗余的。
可以用四个问题快速核对模型:当前阶段是什么;哪些历史信息还会影响未来;一个状态依赖哪些更小状态;状态最终保存最值、计数还是可行性。四个答案能够相互吻合时,模型通常已经稳定。
把模板记忆改成结构识别
常见 DP 类型可以作为经验标签,但不应该成为建模起点。看到物品并不一定是背包,看到字符串也不一定是二维序列 DP,看到树也可能只需要普通递归。真正重要的是状态是否满足“信息足够但不过量”,以及转移是否只依赖规模更小、已经定义清楚的子问题。
训练时可以刻意先不写状态方程,只用一句话回答“处理到哪里”“未来还需要知道什么”“更小问题是什么”。当这三件事明确后,dp 的维度往往自然出现;再结合答案类型选择 min、max、求和或布尔聚合,就能在没有模板关键词时仍然找到可靠的动态规划入口。