
数据结构与算法 / 系统课时
从题目约束反推可行状态规模
从题目约束反推可行状态规模
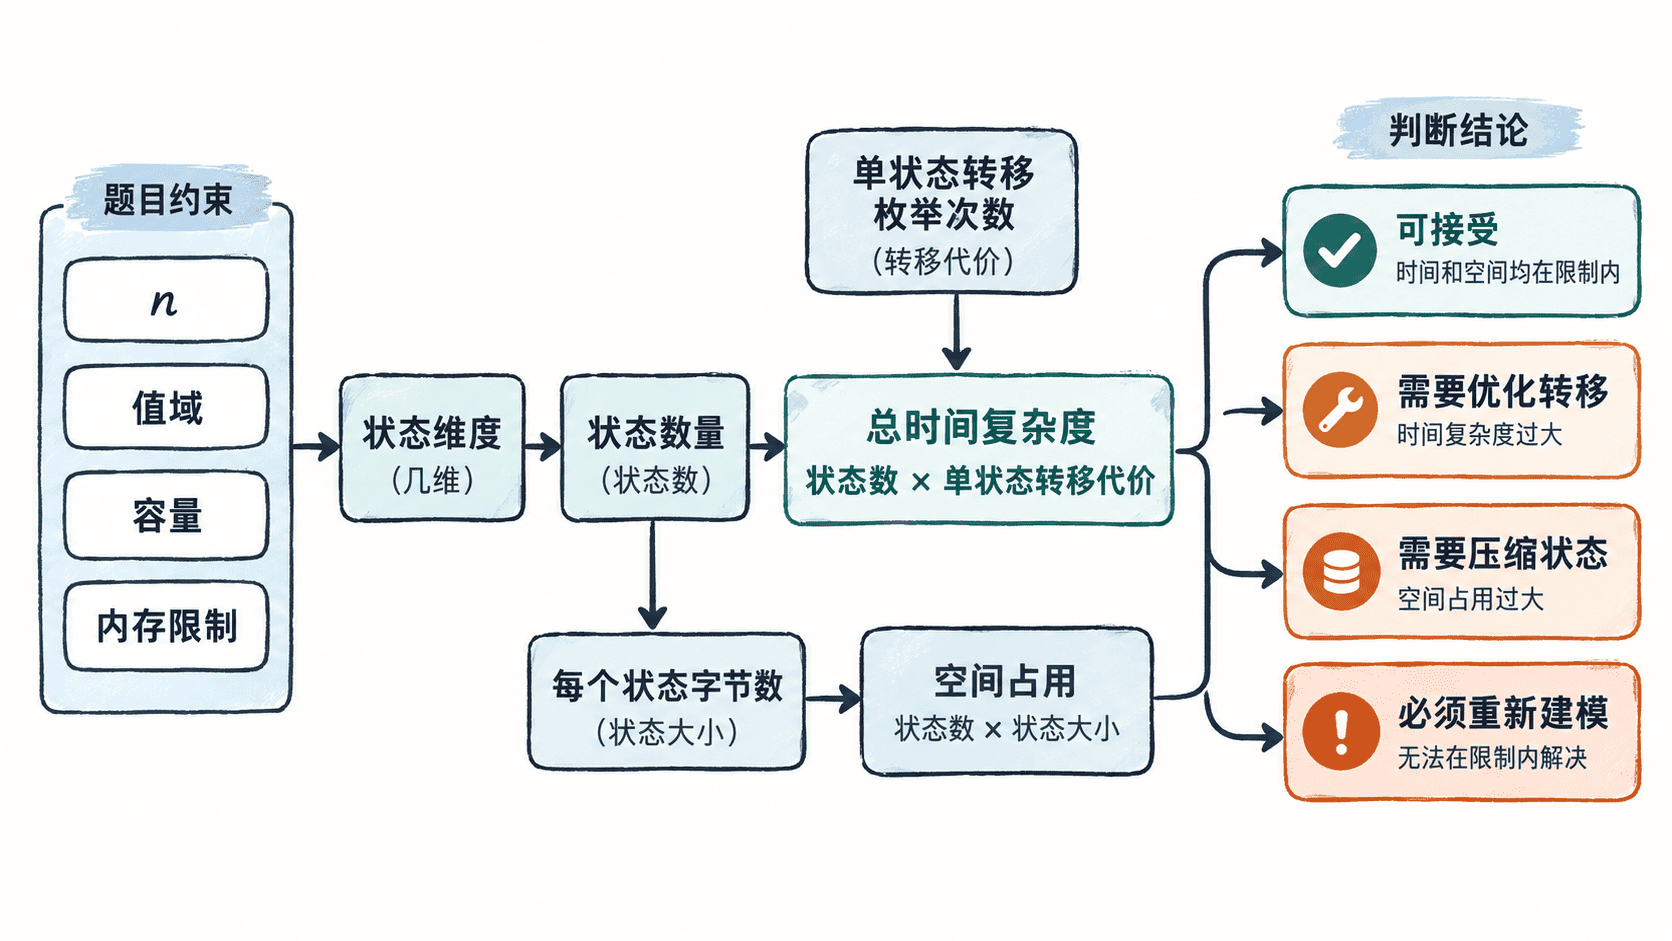
动态规划最容易浪费时间的地方,不是状态转移写错,而是模型从一开始就超出数据规模。面对一道新题,应先把输入上限翻译成时间、空间预算,再反推状态数量和每个状态允许枚举多少次,从源头排除注定超时或爆内存的方案。
学习目标
- 根据输入规模快速估算可接受的时间复杂度数量级
- 用“状态数 × 单状态转移代价”检查 DP 是否可行
- 同时评估状态数组的空间占用,识别需要压缩或改模的方案
先把约束翻译成计算预算
题目给出的 n、值域、容量或状态维度不是附属信息,而是在告诉你解法的上限。竞赛或面试环境中不能机械地认为“ 次操作一定可以通过”,因为语言、常数、缓存命中和评测机器都会影响实际速度,但数量级足以用于第一轮筛选。
可以把常见规模当成粗略警戒线:n 只有几十时,可以考虑指数状态或子集 DP;n 在几百到几千时,常见目标是 ;n 达到 甚至更大时,通常需要接近 或 的方案。这里的重点不是背固定表格,而是先问一句:我的状态和转移总共会执行多少次?
| 输入规模 | 首先考虑的复杂度量级 | 典型 DP 形态 |
|---|---|---|
n <= 20 |
、 | 状态压缩、子集 DP |
n <= 500 |
需谨慎, 较常见 | 区间 DP、二维 DP |
n <= 5000 |
通常争取 以下 | 序列 DP、优化转移 |
n <= 100000 |
通常接近 或 | 一维 DP 配合数据结构或特殊性质 |
这些范围只是建模筛选器。真正判断时还要结合状态类型、转移常数和内存限制,而不是仅凭 n 选择模板。
用状态数乘转移代价
动态规划的总时间通常可以拆成两个部分:需要计算多少个不同状态,以及每个状态为了得到答案要检查多少个候选转移。因此最实用的估算式是:
( 时间复杂度 \approx 状态数量 \times 单状态转移代价 )
例如,若定义 dp[i][j],两个维度都最多取 n 个值,那么状态规模已经是 。如果求每个状态时还要枚举一个长度为 n 的分割点,整体就会达到 。当 n = 2000 时,约 级别的组合显然不应先写完再测试。
这个拆法还能帮助定位应该优化哪里。如果状态只有 个,但每个状态扫描 个前驱,就优先寻找转移优化;如果转移已经是 ,却存在三个独立维度,则更应该重新审视是否真的需要记录全部维度。
别忘了先算空间
时间可行不代表空间可行。假设一个二维 DP 有 10000 × 10000 个状态,即使每个状态只使用 4 字节整数,也需要约 400 MB 连续存储,还没有计算容器开销和其他数据。若评测内存限制是 256 MB,这个模型在运行前就已经失败。
空间估算可以直接使用:
( 空间 \approx 状态数量 \times 单状态字节数 )
发现空间过大时,先观察转移依赖。如果第 i 层只依赖第 i-1 层,通常可以使用滚动数组,把 空间压到 ;如果后续需要任意历史状态,则不能为了省空间随意覆盖旧值。
从不可行方案反推改进方向
发现复杂度超限后,不要立即换一道完全不同的算法。先判断瓶颈属于哪一类:状态太多,还是每个状态枚举太多。
如果状态数量过大,可以检查某个维度是否能由其他变量推导、是否只需要保留上一阶段,或者多个表面不同的状态其实拥有相同的未来决策。如果单状态转移太慢,则检查是否存在前缀最优值、单调性、数据结构维护、决策边界或数学性质,使“枚举所有前驱”变成直接查询。
例如,一个状态规模为 、转移也需要 枚举的模型是 。若题目给出 n <= 5000,这通常意味着必须进一步利用结构,把转移降到接近 或 ,或者减少状态本身,而不是期待常数优化救场。
建模前做一次数量级检查
实际解题时,可以在写转移方程前完成四个检查:先列出每个状态维度的取值数量,再相乘得到状态数;然后写出每个状态需要枚举的候选数量;接着估算总操作量;最后按状态类型估算内存。
如果这四步已经显示方案明显超限,就应该立刻回到状态定义,而不是继续补初始化和边界条件。稳定的动态规划流程不是“想到状态就写”,而是让题目约束先替你淘汰不可能的模型,再把精力投入真正有机会通过的方案。