
数据结构与算法 / 系统课时
从暴力递归推导状态转移
从暴力递归推导状态转移
状态转移并不是凭空猜出的公式。更可靠的方法是先写出“把所有选择都试一遍”的递归,让函数参数自然暴露子问题,再观察递归调用之间的关系。本节用爬楼梯问题把暴力递归逐步改写成明确的 DP 状态与迭代计算。
学习目标
- 从递归函数的参数中识别动态规划状态
- 从递归调用关系提炼状态转移与边界条件
- 把指数级重复递归改写成自底向上的线性计算
从枚举所有选择开始
假设有 n 级台阶,每次只能走 1 级或 2 级,求到达顶部的走法数量。先不考虑效率,只描述所有合法选择:如果当前还剩 n 级,那么第一步要么走 1 级,留下规模为 n-1 的子问题;要么走 2 级,留下规模为 n-2 的子问题。
因此可以把 f(n) 定义为“走完剩余 n 级台阶的方法数”。当 n=0 时已经到达顶部,只有 1 种完成方式;当 n=1 时也只有走 1 级这一种方式。递归关系自然得到 f(n) = f(n - 1) + f(n - 2)。
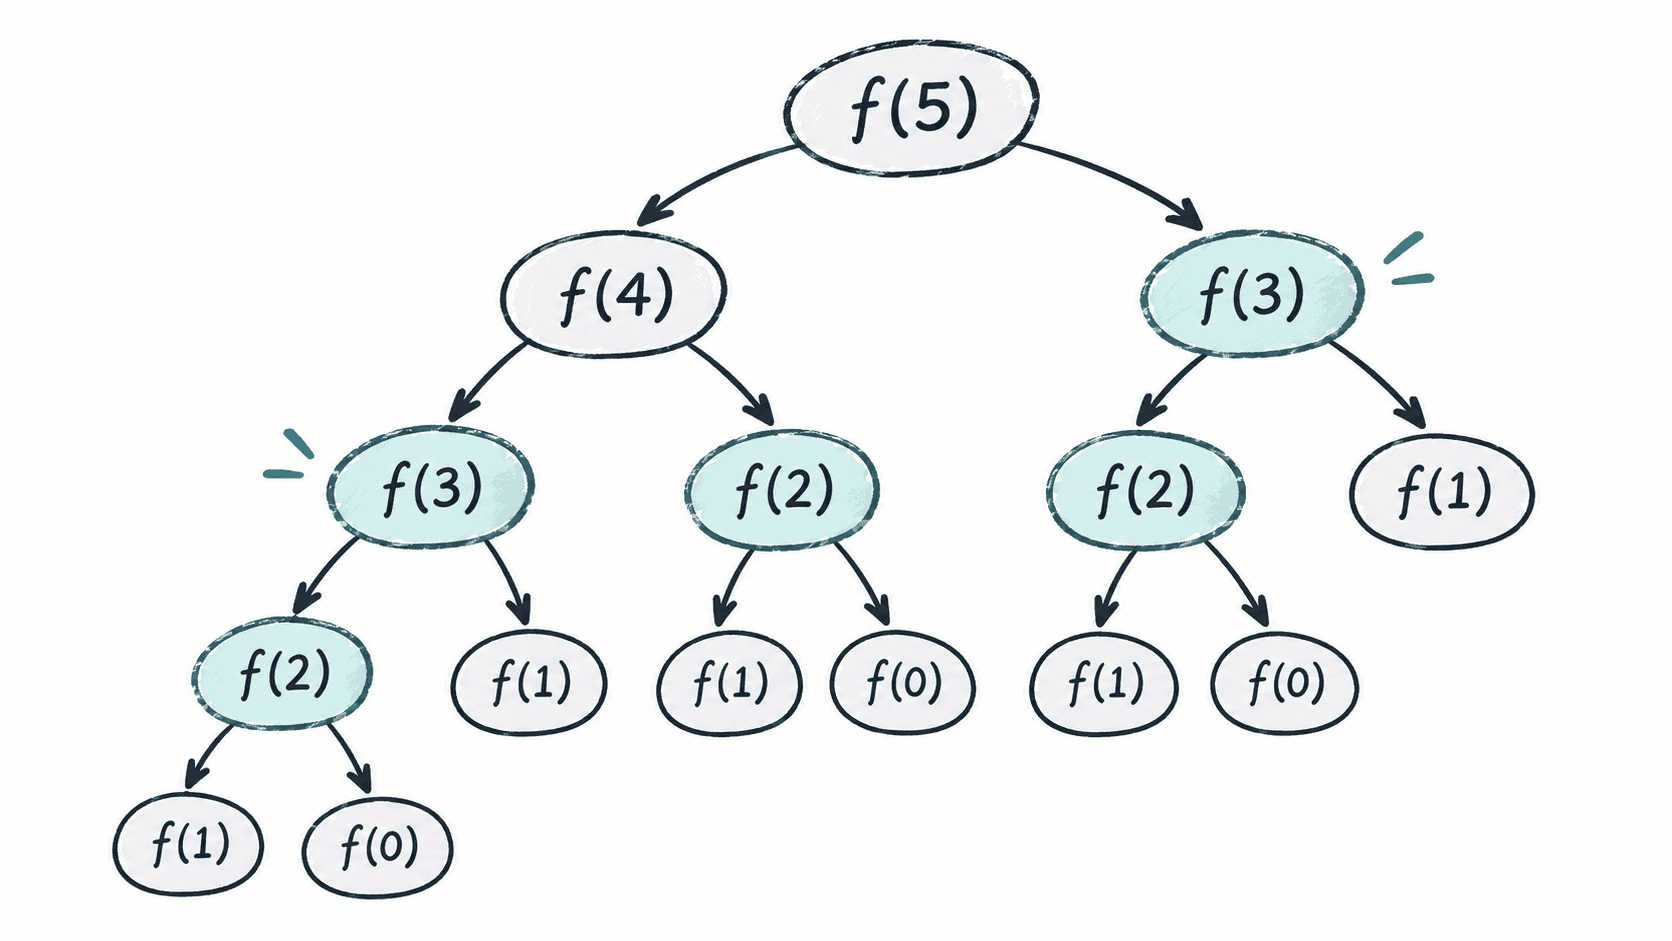
递归树暴露了一个重要事实:路径不同,但只要剩余台阶数相同,后续答案就相同。于是“如何走到这里”可以被丢弃,只保留 n 这一项状态。
把递归参数变成状态
推导状态时,先问递归函数需要哪些参数才能独立回答问题。在这个例子中,函数只需要知道剩余台阶数 n,因此 DP 只需要一维状态。若递归函数还需要位置、容量、是否使用过某个机会等信息,这些参数通常都会成为候选状态维度。
接着把递归调用翻译成转移。递归中的“调用 f(n-1) 和 f(n-2) 后相加”,直接对应 DP 中“当前状态由前两个状态相加”。边界条件同样来自递归终止条件,而不是为了让数组不越界临时补出来。
这里可以得到三个完整组成部分:状态含义是 f(n) 表示走完 n 级台阶的方法数;边界是 f(0)=1、f(1)=1;转移是 f(n)=f(n-1)+f(n-2)。只要这三项彼此一致,记忆化和迭代写法只是计算顺序不同。
改写为自底向上计算
下面的完整程序同时保留暴力递归和迭代 DP,便于验证两种写法得到相同答案。递归版本直接表达选择关系,迭代版本按照状态依赖顺序只计算每个状态一次。
def ways_recursive(n: int) -> int:
    if n <= 1:
        return 1
    # 两个分支分别对应第一步走 1 级和走 2 级。
    return ways_recursive(n - 1) + ways_recursive(n - 2)


def ways_dp(n: int) -> int:
    if n <= 1:
        return 1

    dp = [0] * (n + 1)
    dp[0] = 1
    dp[1] = 1

    # 当前状态只依赖已经计算完成的前两个状态。
    for i in range(2, n + 1):
        dp[i] = dp[i - 1] + dp[i - 2]
    return dp[n]


n = 5
print(f"recursive: {ways_recursive(n)}")
print(f"dp: {ways_dp(n)}")
预期输出
recursive: 8
dp: 8
实际运行时这里没有动态时间、端口或路径值,因此输出是确定的。两种实现结果一致,说明状态定义、边界条件和转移关系至少在该输入上保持一致。
为什么复杂度会下降
暴力递归会反复计算相同的 f(k)。它的调用树规模随 n 指数增长,时间复杂度通常记为 的量级;迭代 DP 只计算 f(0) 到 f(n) 各一次,因此时间复杂度降为 ,数组版本的空间复杂度也是 。
由于当前状态只依赖前两个状态,还可以继续把数组压缩成两个变量,将额外空间降到 。不过空间优化应放在状态转移已经正确之后,否则过早覆盖旧状态会让依赖关系更难检查。
推导时优先检查三个位置
第一,状态含义必须稳定。如果一会儿把 dp[i] 解释为“到达第 i 级的方法数”,一会儿又解释为“还剩 i 级的方法数”,边界和转移很容易错位。
第二,边界应来自原问题的最小可解子问题。不要只为了让示例输出正确而猜 dp[0],应解释清楚空剩余步骤为什么对应一种完成方式。
第三,迭代顺序必须满足依赖关系。当 dp[i] 依赖更小下标时从小到大计算;若状态转移依赖尚未计算的状态,就需要重新考虑遍历顺序、状态定义或计算方式。
从暴力递归推导 DP 的核心动作,就是把“递归函数参数”变成状态,把“递归调用”变成转移,把“递归终止条件”变成边界,再消除重复计算。这样得到的状态转移有来源,也更容易验证。