
数据结构与算法 / 系统课时
处理每种物品的数量上限
处理每种物品的数量上限
多重背包允许每类物品使用有限次,难点不是写出状态,而是把“最多取几件”正确放进转移。本篇先从枚举件数得到可靠基线,再用二进制拆分把数量约束转成若干零一物品,在保持结果不变的同时降低转移次数。
学习目标
- 写出带数量上限的多重背包状态转移
- 使用二进制拆分把一类物品转换为若干零一物品
- 比较朴素枚举与二进制优化的时间复杂度和适用边界
从数量上限写出朴素转移
设背包容量为 C,第 i 类物品重量为 w、价值为 v,最多使用 s 件。令 dp[c] 表示处理完当前范围内的物品后,容量不超过 c 时能取得的最大价值。
处理这一类物品时,可以选择 0 到 s 件,但件数还不能让总重量超过当前容量。因此新状态满足:对每个容量 c,枚举 ,候选值为旧状态 dp[c - k * w] + k * v。
这里必须从“处理该类物品之前”的状态读取。若一边枚举容量一边直接使用已经更新过的当前数组,就可能再次利用同一类物品,实际使用数量超过 s。最直接的做法是在处理每一类物品前保存一份 prev。
用二进制拆分减少枚举
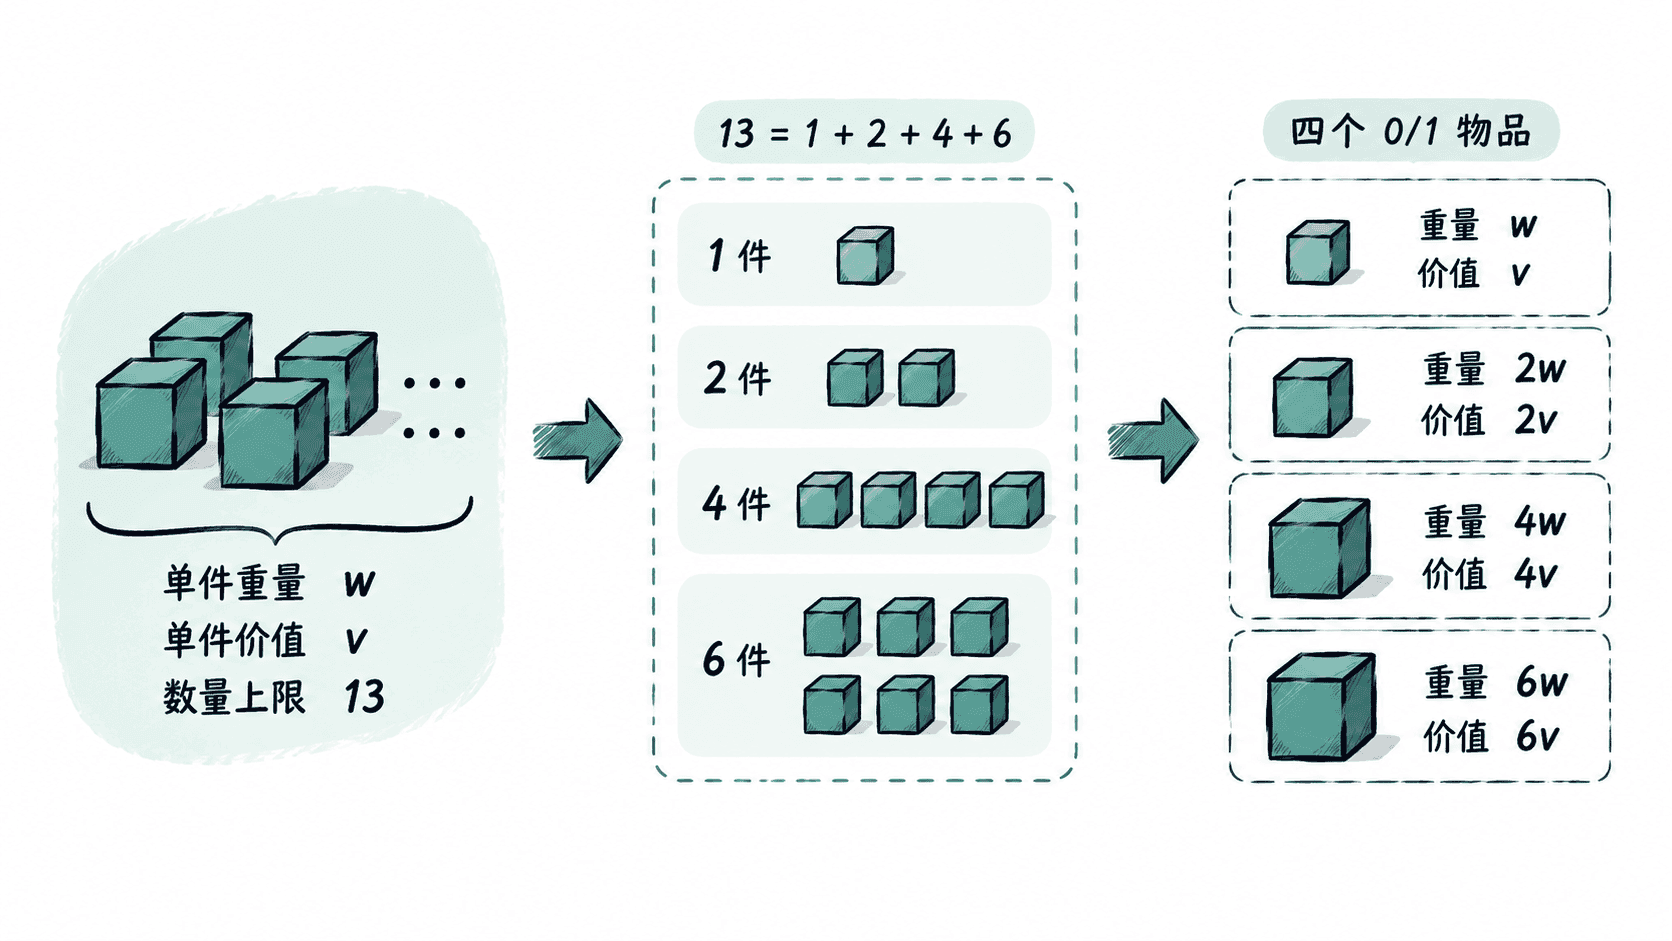
当 s 很大时,逐个枚举 0...s 会成为主要开销。可以把数量 s 拆成 1, 2, 4, ... 的若干组,每组要么整体选择,要么不选择,于是每组都成为一个零一背包物品。
例如一类物品最多有 13 件,可以拆成 1 + 2 + 4 + 6。任意 0...13 的使用数量,都能由这些组中的若干组组合出来,因此数量约束没有丢失。每组的重量和价值分别乘以组内件数,然后按零一背包的容量倒序更新。
对照实现与验证
下面用同一组输入分别执行朴素枚举和二进制拆分。物品使用 (重量, 价值, 数量上限) 表示,两个算法应得到完全相同的最优价值。
def bounded_knapsack_naive(items, capacity):
    dp = [0] * (capacity + 1)

    for weight, value, count in items:
        prev = dp[:]  # 固定上一阶段,防止当前类别被重复利用
        for c in range(capacity + 1):
            best = prev[c]
            max_count = min(count, c // weight)
            for k in range(1, max_count + 1):
                best = max(best, prev[c - k * weight] + k * value)
            dp[c] = best

    return dp[capacity]


def bounded_knapsack_binary(items, capacity):
    dp = [0] * (capacity + 1)

    for weight, value, count in items:
        group = 1
        remaining = count

        # 依次取 1、2、4...,最后一组接收剩余数量
        while remaining > 0:
            take = min(group, remaining)
            group_weight = weight * take
            group_value = value * take

            # 每个拆出的组只能使用一次,因此容量必须倒序更新
            for c in range(capacity, group_weight - 1, -1):
                dp[c] = max(dp[c], dp[c - group_weight] + group_value)

            remaining -= take
            group *= 2

    return dp[capacity]


items = [(3, 4, 3), (4, 5, 2)]
capacity = 10

print(bounded_knapsack_naive(items, capacity))
print(bounded_knapsack_binary(items, capacity))
预期输出
13
13
最优方案之一是选择两件重量为 3、价值为 4 的物品,再选择一件重量为 4、价值为 5 的物品,总重量正好为 10,总价值为 13。
比较复杂度与实现边界
朴素方法对每类物品、每个容量都可能继续枚举数量。如果第 i 类物品上限为 s_i,可以把时间复杂度理解为 ;当所有上限都接近同一个 S 时,常写成 。空间复杂度为 ,额外复制的 prev 仍然是线性空间。
二进制拆分后,第 i 类物品只产生 个零一物品,因此时间复杂度降为 ,空间仍为 。数量上限较大时,这通常比逐件枚举稳定得多。
若某类物品的上限已经大到在容量范围内不可能用完,例如 count * weight >= capacity,它在当前容量下等价于完全背包,还可以进一步改用完全背包转移。面对有限数量约束时,先写对朴素转移,再根据上限规模选择二进制拆分,是最不容易出错的实现路径。