
数据结构与算法 / 系统课时
确定边界条件与计算顺序
确定边界条件与计算顺序
动态规划方程即使写对,也可能因为初值、非法状态或遍历方向错误得到完全错误的答案。本节从依赖关系出发,确定初始状态、哨兵值和计算顺序,并用 0/1 背包说明为什么同一条转移在正序与逆序下语义不同。
学习目标
- 能根据状态含义设置初始状态、非法状态和哨兵值
- 能从依赖方向判断正序、逆序或按区间长度计算
- 能识别原地更新造成的状态覆盖与重复使用
先让边界与状态定义一致
边界条件不是“为了让代码跑起来”随手填的初值,而是状态定义在最小规模输入上的真实答案。若 dp[w] 表示容量不超过 w 时能取得的最大价值,那么没有物品时任意容量的答案都是 0,因此可以把整行初始化为 0。
但如果状态改成“恰好装满容量 w 的最大价值”,含义就不同:只有 dp[0] = 0 合法,其他容量一开始都不可达,不能也初始化为 0。此时应使用一个不会被误认为正常答案的负无穷哨兵,并且只从可达状态进行转移。
最常见的边界设计可以分成三类:真实初始状态直接写入其确定值;非法或不可达状态使用明确哨兵;数组之外的状态则通过循环范围或条件判断避免访问。边界一旦和状态语义不一致,后面的转移再正确也无法补救。
计算顺序由依赖关系决定
计算顺序的唯一原则是:一个状态被计算时,它依赖的状态必须仍然代表“应该依赖的那一层”,并且已经准备好。二维表中这一点通常直观;压缩到一维后,遍历方向本身就承担了“上一层还是当前层”的语义。
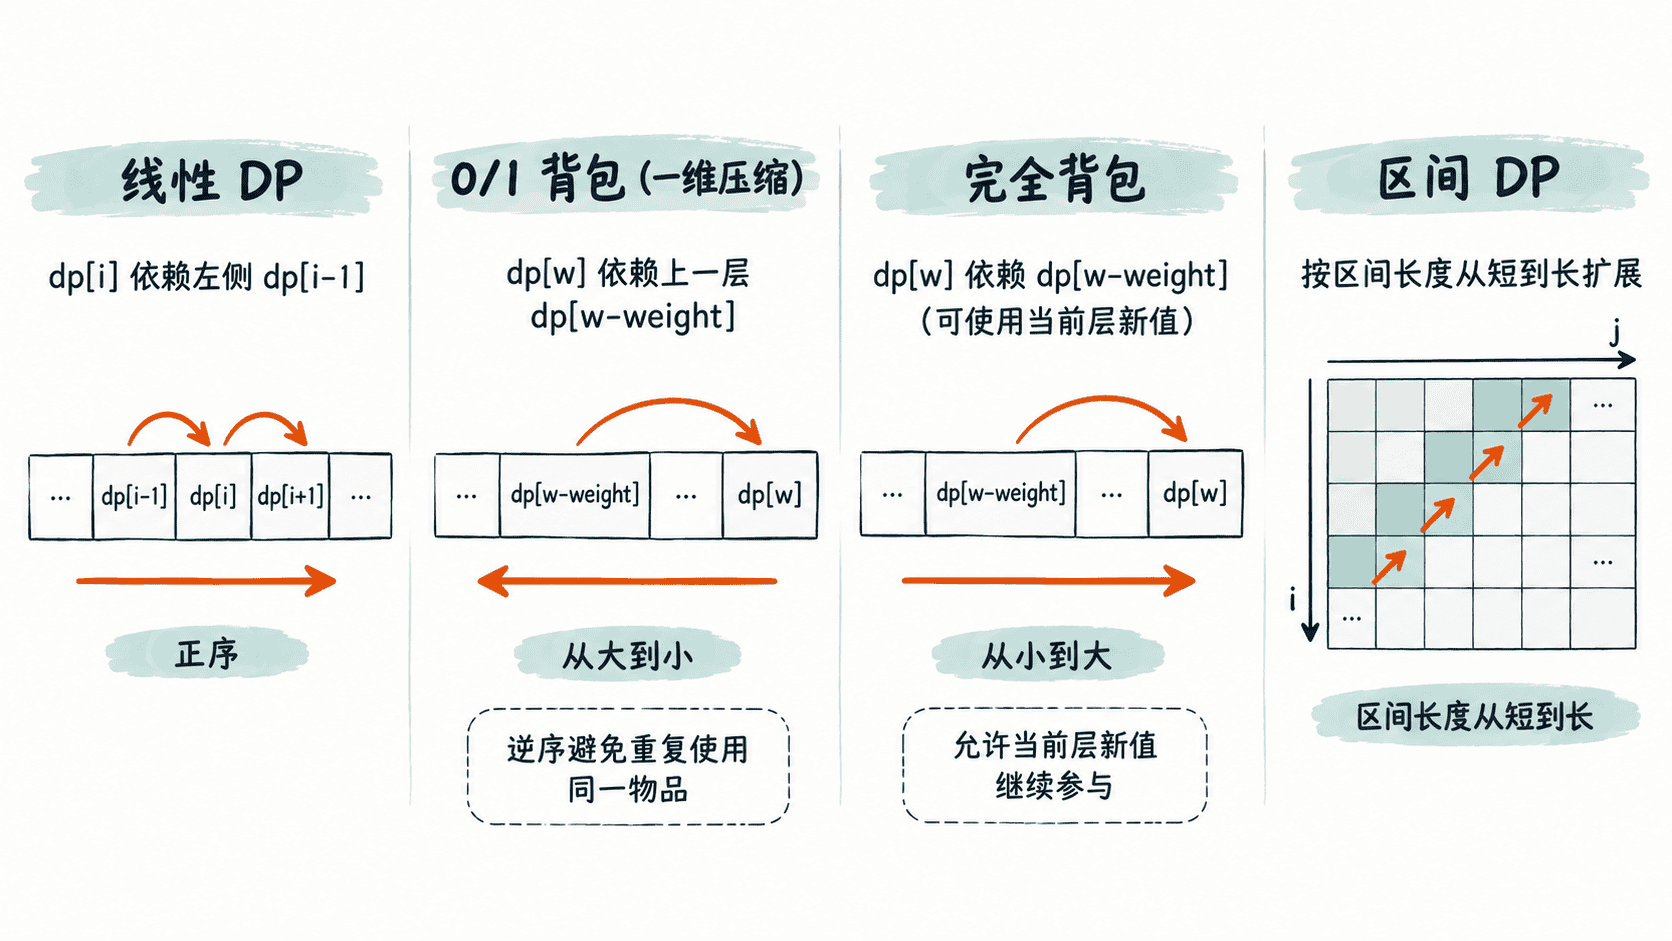
线性 DP 若 dp[i] 依赖 dp[i-1],通常从小到大计算。区间 DP 若 dp[l][r] 依赖更短的区间,就应先枚举区间长度,再枚举左端点。背包类问题则要额外区分依赖的是“上一层”还是“当前层”,这正是正序与逆序差异的来源。
逆序为什么能保护上一层状态
0/1 背包规定每件物品最多使用一次。二维写法中,第 i 层只依赖第 i-1 层;压缩到一维后,如果容量从小到大更新,较小容量刚写入的新值会立刻被较大容量读取,相当于同一件物品在本轮被再次使用。
下面用只有一件重量 2、价值 3 的物品验证差异。容量为 4 时,正确答案仍应是 3;正序更新却会错误得到 6。
def zero_one_knapsack_reverse(weight, value, capacity):
    dp = [0] * (capacity + 1)
    for w in range(capacity, weight - 1, -1):
        dp[w] = max(dp[w], dp[w - weight] + value)
    return dp[capacity]

def zero_one_knapsack_forward(weight, value, capacity):
    dp = [0] * (capacity + 1)
    for w in range(weight, capacity + 1):
        dp[w] = max(dp[w], dp[w - weight] + value)
    return dp[capacity]

print('reverse =', zero_one_knapsack_reverse(2, 3, 4))
print('forward =', zero_one_knapsack_forward(2, 3, 4))
预期输出:
reverse = 3
forward = 6
逆序时,计算 dp[4] 读取的 dp[2] 仍是处理当前物品之前的旧值,因此每件物品最多贡献一次。正序时,dp[2] 已经包含当前物品,再用它更新 dp[4] 就等价于重复选取。完全背包允许同一物品多次使用,所以恰好相反,常常需要容量正序遍历。
区间问题要按规模扩展
如果状态是 dp[l][r],且转移依赖 dp[l+1][r]、dp[l][r-1] 或更短区间,那么简单按 l、r 从小到大扫描可能在读取时遇到尚未计算的状态。更稳妥的方式是把“区间长度”作为最外层顺序。
例如长度为 1 的区间先作为边界;随后计算长度 2、3,直到完整区间。这样无论左右端点如何变化,当前区间依赖的更短区间都已经得到结果。这里的“长度”不一定是状态定义的一部分,却是保证拓扑顺序正确的计算维度。
用依赖图做最后检查
写完转移后,可以逐项检查:边界值是否真的是状态定义下的答案;不可达状态是否会被正常状态误用;当前状态依赖的值在读取时是否已经计算;原地更新是否会把仍需使用的旧值覆盖。
如果一维压缩后不确定该正序还是逆序,最有效的方法是临时恢复成二维语义,明确右侧每一项来自上一层还是当前层,再决定遍历方向。计算顺序不是记忆模板,而是状态依赖关系在代码中的具体实现。