
数据结构与算法 / 系统课时
区分组合计数与排列计数
区分组合计数与排列计数
同样是“凑出目标值”,答案可能因为是否区分选择顺序而完全不同。动态规划里最容易被忽略的不是转移公式,而是循环顺序:先遍历物品通常统计组合,先遍历总和通常统计排列,二者对应的是不同的问题定义。
学习目标
- 判断题目统计的是组合数还是排列数
- 理解外层遍历物品与外层遍历总和为什么会改变计数语义
- 用同一组数据验证两种循环顺序产生的不同答案
先判断顺序是否属于方案的一部分
设可重复使用的数字为 [1, 2, 3],目标为 4。
如果 {1, 3} 和 {3, 1} 被看作同一种选择,只关心“用了哪些数字以及各用了几次”,统计的是组合。合法组合共有 4 种:1+1+1+1、1+1+2、1+3、2+2。
如果 [1, 3] 和 [3, 1] 被看作两种不同序列,统计的是排列。此时顺序本身属于方案的一部分,答案会增加到 7。
所以开始写代码前,应先问一句:交换选择顺序后,方案是否仍然相同?这个判断比记忆某个模板更可靠。
循环顺序如何限制生成路径
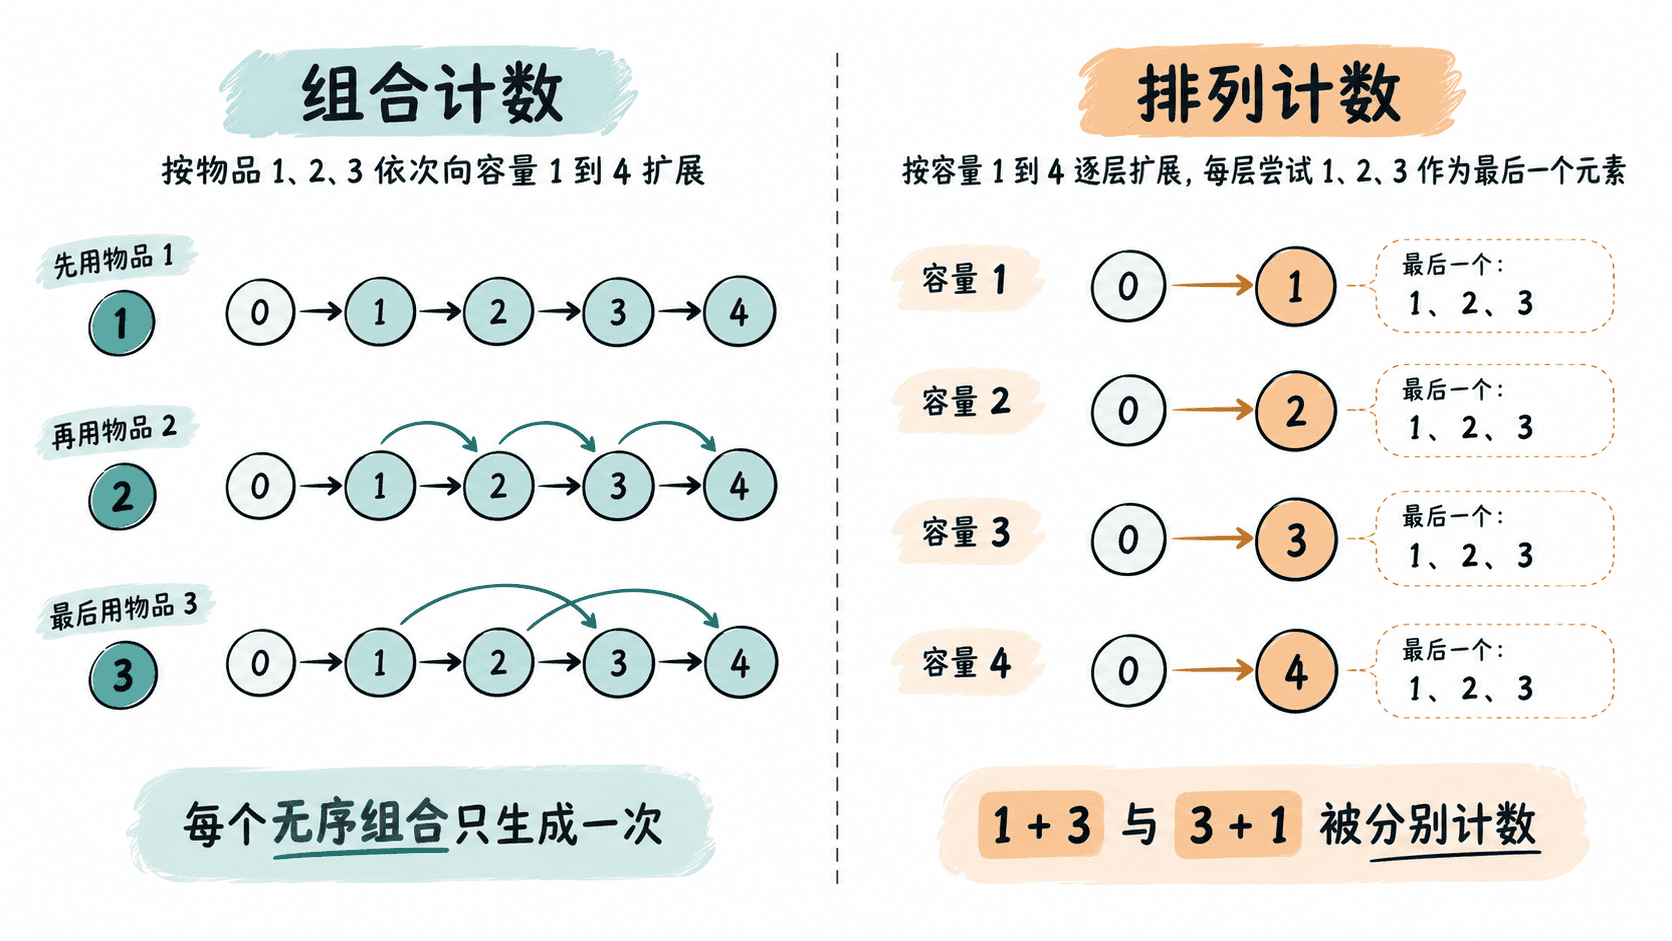
统计组合时,让物品处在外层循环。处理数字 2 时,状态只会在“已经处理过 1 和 2”的范围内继续扩展;之后再处理 3。这样每个组合只会按固定的物品顺序被生成一次,不会同时出现 1+3 和 3+1 两条路径。
统计排列时,让总和处在外层循环。计算 dp[s] 时,会尝试让每一种数字成为序列的最后一个元素,因此 dp[s - 1] 接上 1 与 dp[s - 3] 接上 3 都会分别贡献方案。顺序不同的前缀会被保留下来,所以排列会被单独计数。
用同一转移写出两种语义
两种写法都使用 dp[0] = 1,也都执行 dp[s] += dp[s - x]。真正决定语义的是谁在外层。
def count_combinations(nums, target):
    dp = [0] * (target + 1)
    dp[0] = 1

    for x in nums:
        # 物品在外层:固定生成顺序,避免同一组合被重复排列。
        for s in range(x, target + 1):
            dp[s] += dp[s - x]

    return dp[target]


def count_permutations(nums, target):
    dp = [0] * (target + 1)
    dp[0] = 1

    for s in range(1, target + 1):
        # 容量在外层:枚举最后一个元素,顺序不同会形成不同方案。
        for x in nums:
            if x <= s:
                dp[s] += dp[s - x]

    return dp[target]


nums = [1, 2, 3]
print('combinations =', count_combinations(nums, 4))
print('permutations =', count_permutations(nums, 4))
预期输出
combinations = 4
permutations = 7
注意两段代码的容量都从小到大遍历,因为这里允许同一个数字重复使用。若改成 0/1 物品,容量方向还要再根据“每个物品只能使用一次”调整,不能只凭组合或排列两个词机械套模板。
用题意而不是模板名做最后检查
“硬币兑换”常统计组合,因为使用 1 元再 2 元与先 2 元再 1 元通常没有区别;“爬楼梯”或“组成序列”常统计排列,因为每一步发生的先后顺序不同就代表不同过程。但题目名称本身不能决定答案,最终仍要看方案判等规则。
可以在写完转移后做一个很小的人工样例检查:找两个只交换顺序的方案,例如 1+3 与 3+1。如果题目认为它们相同,而程序把它们都计入,就说明循环顺序把组合误写成了排列;反过来,如果题目要求区分顺序而程序只保留一种,也说明建模不匹配。
组合计数和排列计数往往共享完全相同的状态定义与加法转移,真正的差异在于状态按什么顺序被扩展。先明确方案是否区分顺序,再决定循环层级,能比死记“外层物品还是外层容量”更稳定地避免错误。