
数据结构与算法 / 系统课时
把二维状态压缩成滚动数组
把二维状态压缩成滚动数组
二维 DP 表往往保存了大量后续永远不会再访问的历史状态。真正压缩空间前,需要先画清当前状态依赖上一行、当前行还是左上角数据,再决定保留两行、一行或直接原地更新,否则一次错误覆盖就会改变递推含义。
学习目标
- 根据状态依赖判断二维表能否压缩为两行或一行
- 理解一维数组更新前后分别代表上一层和当前层状态
- 根据数据依赖选择正确遍历方向,避免提前覆盖仍需使用的数据
压缩前先检查依赖
空间优化的依据不是“二维数组看起来很大”,而是某个状态计算完成后,哪些旧状态还会被未来使用。若 dp[i][j] 只依赖第 i-1 行,那么更早的第 i-2 行通常已经没有保留价值,可以把完整二维表缩成两行。
如果当前行还只依赖少数相邻位置,就可能进一步压成一行。但同一个 dp[j] 在更新前代表上一行状态,更新后立刻变成当前行状态,因此遍历顺序已经成为算法正确性的一部分。
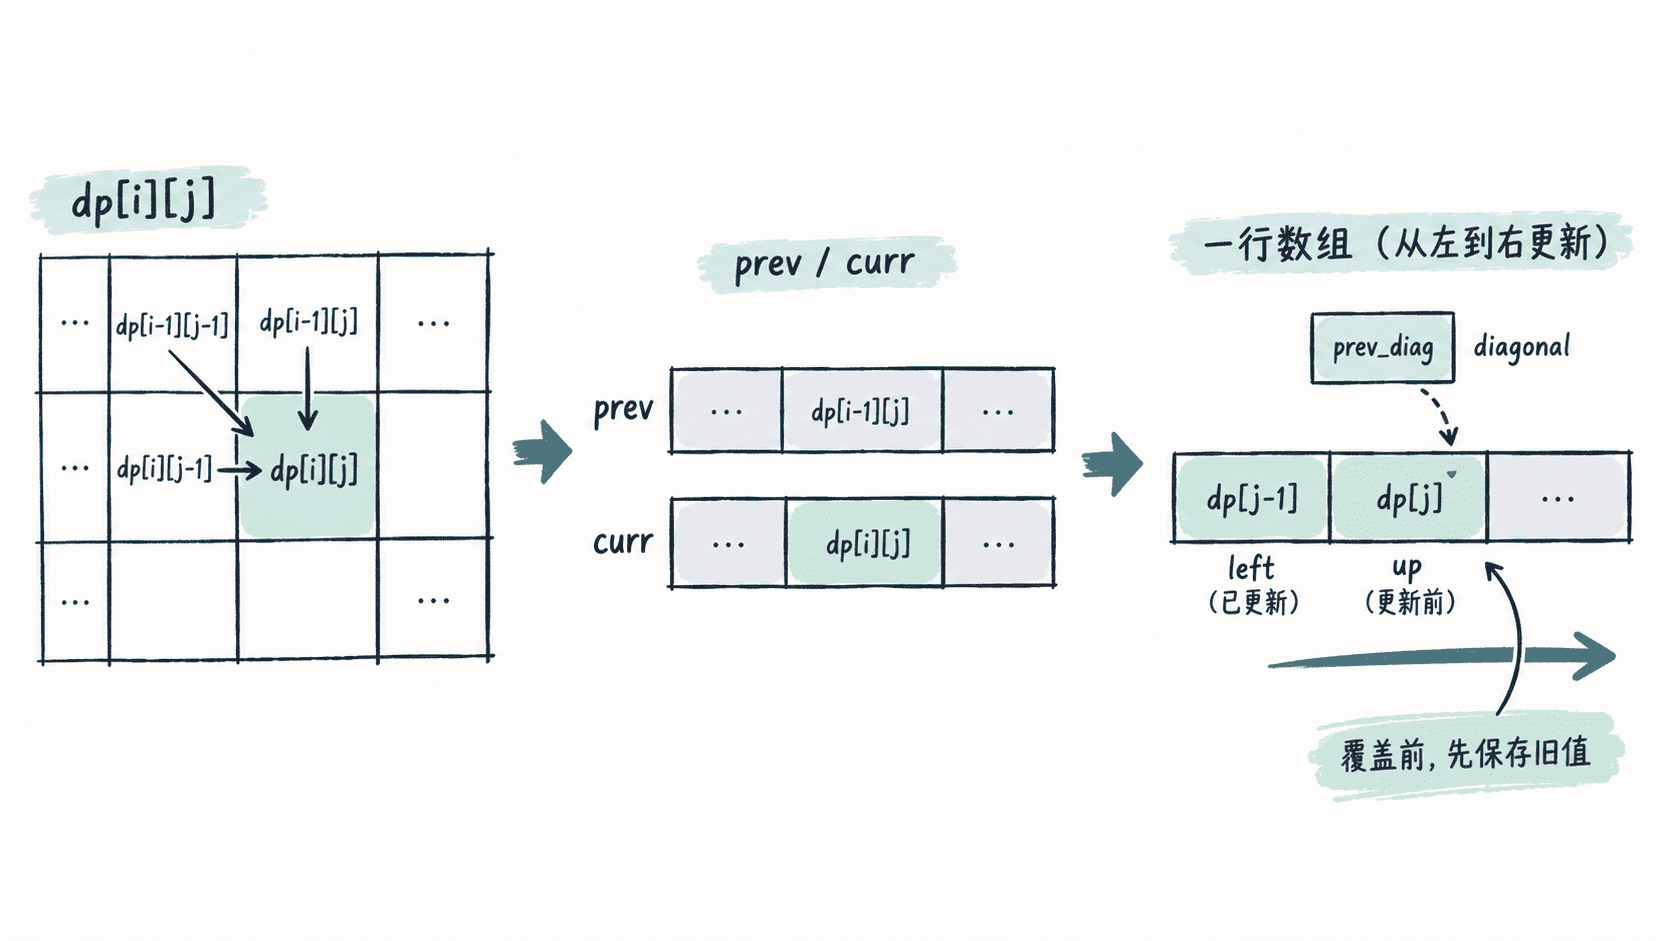
两行、一行与原地更新
两行滚动数组最容易理解:读取 prev,写入 curr,一行结束后交换二者。空间从 O(nm) 降为 O(m),同时不会混淆新旧状态,适合第一次优化复杂递推式。
一行数组会同时承载“上一行尚未覆盖的数据”和“当前行已经更新的数据”。如果递推还需要左上角旧值,就必须先用临时变量保存。双序列问题中的最长公共子序列就是典型案例。
网格问题有时还可以直接修改输入矩阵,例如最小路径和可以把每个格子改写为“到达这里的最优值”。这种方式额外空间可以降到 O(1),代价是破坏原始输入;如果调用方后续仍需要原矩阵,就不应原地更新。
用一行数组计算最长公共子序列
设 dp[j] 表示当前处理到第二个字符串前 j 个字符时的最长公共子序列长度。进入新的一行时,尚未更新的 dp[j] 仍是上一行的“上方状态”,而已经更新的 dp[j-1] 是当前行的“左侧状态”。左上角旧值则保存在 prev_diag 中。
def longest_common_subsequence(a: str, b: str) -> int:
    # 让较短字符串作为列,进一步降低实际内存占用。
    if len(a) < len(b):
        a, b = b, a

    dp = [0] * (len(b) + 1)

    for char_a in a:
        prev_diag = 0
        for j, char_b in enumerate(b, start=1):
            up = dp[j]  # 覆盖前先保存上一行的 dp[i-1][j]。
            if char_a == char_b:
                dp[j] = prev_diag + 1
            else:
                dp[j] = max(dp[j], dp[j - 1])
            prev_diag = up

    return dp[-1]


def main() -> None:
    print(longest_common_subsequence("abcde", "ace"))


if __name__ == "__main__":
    main()
预期输出
3abcde 与 ace 的最长公共子序列就是 ace,长度为 3。原始二维解法需要 O(nm) 空间,这个版本只保留较短字符串对应的一行,因此空间复杂度降为 O(min(n, m)),时间复杂度仍是 O(nm)。
遍历方向由依赖关系决定
不能把“一维 DP 应该正序还是倒序”记成固定口诀。判断方向时,只需要问一个问题:当前状态需要读取的是旧值还是本轮已经产生的新值。
最长公共子序列的 dp[i][j] 需要当前行左侧 dp[i][j-1],所以 j 必须从左向右更新;这样 dp[j-1] 才是本轮的新值,而 dp[j] 在覆盖前仍是上一行旧值。
相反,0/1 背包的一维转移需要上一轮的 dp[cost],若容量从小到大更新,同一个物品产生的新值可能立刻被后续位置再次使用,相当于允许重复选择。此时就要从大容量向小容量遍历,以保护尚未读取的旧状态。
什么时候保留二维表
滚动数组减少的是空间,不会降低状态数量,因此通常不会改善 O(nm) 的时间复杂度。若题目还要求恢复具体路径、输出选择方案,或者调试时需要观察所有中间状态,完整二维表往往更合适。
空间优化应放在正确性之后:先写出清楚的二维状态与依赖,再删除已经证明不会被未来访问的数据。这样从二维表到两行、一行乃至原地更新的每一步,都能由依赖关系解释,而不是依靠容易记错的遍历口诀。