
数据结构与算法 / 系统课时
用数位状态统计区间答案
用数位状态统计区间答案
当区间上界大到无法逐个枚举整数时,可以把整数看成从高位到低位依次选择的数位序列,只记录会影响后续答案的状态。这样,原本与区间长度相关的遍历,就能压缩成与数位数量和状态规模相关的动态规划。
学习目标
- 把整数区间计数改写为前缀计数问题
- 使用当前位置、历史统计量和上界约束设计数位 DP 状态
- 用记忆化搜索实现一个可运行的数位统计程序
从枚举整数改成构造数位
假设要统计区间 [1, 1000] 中十进制数位和等于 10 的整数。直接做法是枚举 1000 个数;如果右端点变成 ,逐数检查就不可行了。
数位 DP 不再询问“下一个整数是什么”,而是从最高位开始询问“当前位置可以填哪个数字”。对于上界 N,定义 F(N) 为 [0, N] 中满足条件的整数数量,那么任意闭区间都可以转化为:
因此核心问题只剩一个:怎样高效计算不超过某个上界的所有合法数位序列。
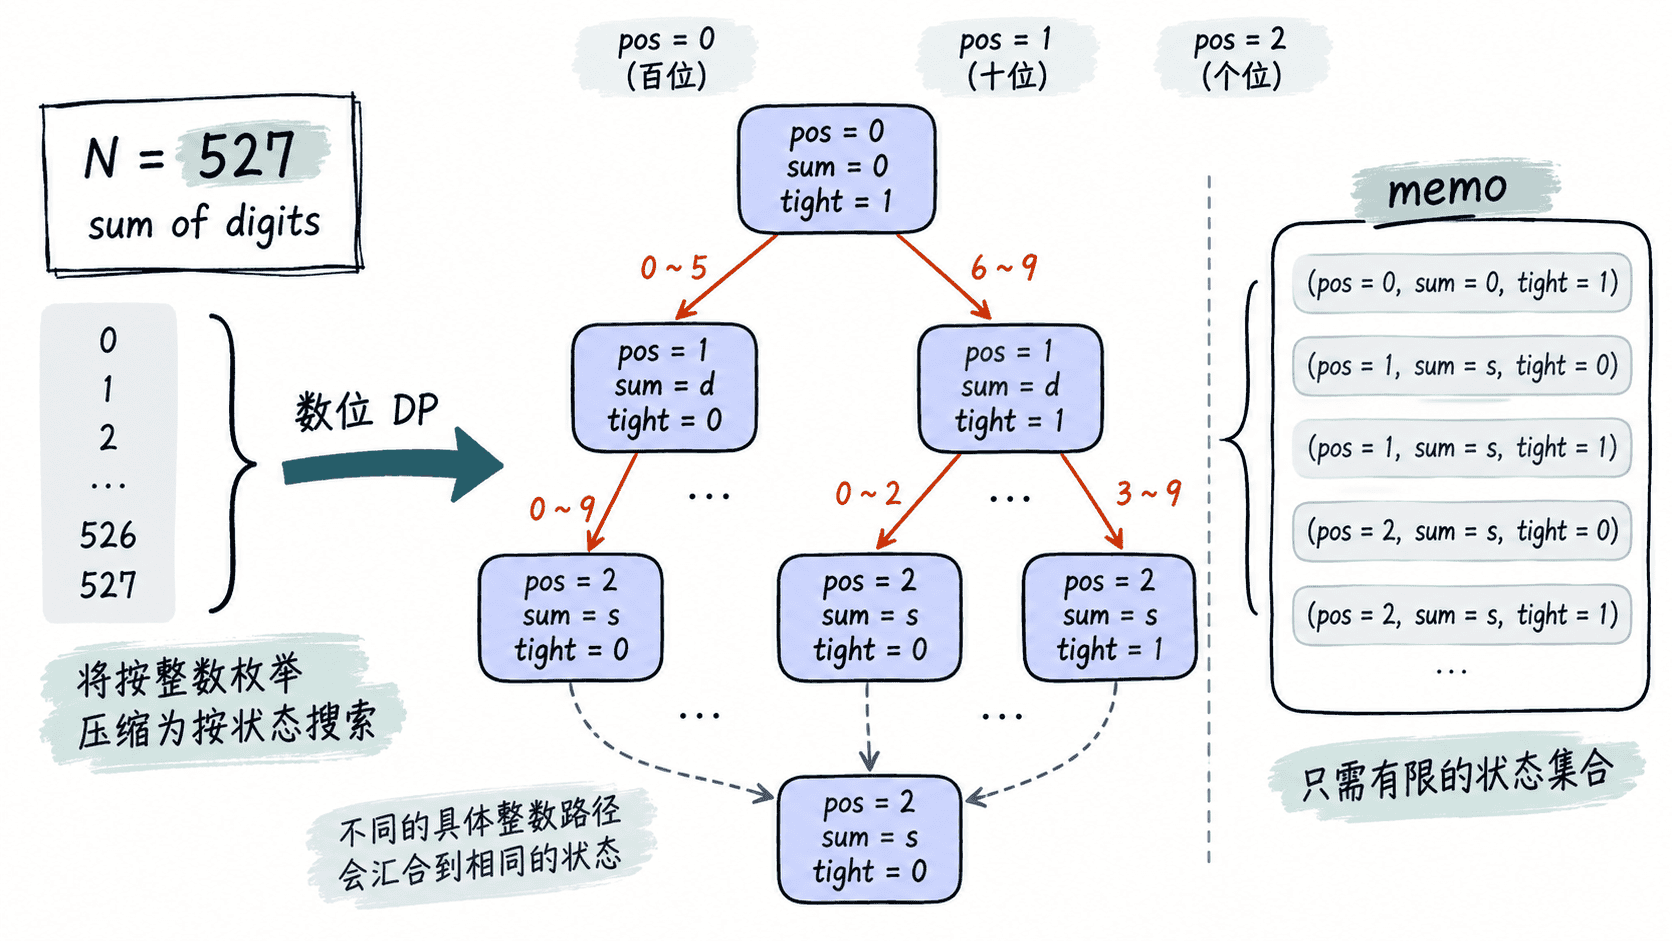
设计足够而不过量的状态
对于“数位和等于目标值”这个问题,一个子问题可以写成 dfs(pos, sum, tight)。
pos 表示当前处理到第几个数位;sum 是已经选择的数字之和;tight 表示此前选择的前缀是否仍与上界前缀完全相同。如果 tight 为真,当前位置最多只能取上界对应数位;一旦选择了更小的数字,后面的数位就可以自由取 0 到 9。
搜索到数位末尾时,只需判断累计和是否等于目标值。若 sum 已经超过目标值,也可以立即停止当前分支。不同路径只要到达相同的 (pos, sum, tight),其后续答案完全一致,因此可以直接复用记忆化结果。
这里没有加入 started 状态,因为前导零不会改变数位和。例如把 7 看成 007,数位和仍然是 7。状态是否需要记录,取决于它会不会改变未来的合法选择或最终统计结果。
用记忆化搜索计算区间答案
下面的程序统计闭区间内数位和等于指定值的整数数量。代码会先计算两个前缀答案,再做一次相减。
from functools import lru_cache


def count_leq(n: int, target: int) -> int:
    if n < 0:
        return 0

    digits = tuple(map(int, str(n)))

    @lru_cache(maxsize=None)
    def dfs(pos: int, digit_sum: int, tight: bool) -> int:
        if digit_sum > target:
            return 0
        if pos == len(digits):
            return int(digit_sum == target)

        upper = digits[pos] if tight else 9
        total = 0
        for digit in range(upper + 1):
            # 只有此前贴住上界且本位继续取上界数字,下一位才仍受限制。
            next_tight = tight and digit == digits[pos]
            total += dfs(pos + 1, digit_sum + digit, next_tight)
        return total

    return dfs(0, 0, True)


def count_range(left: int, right: int, target: int) -> int:
    if left > right:
        raise ValueError('left must not exceed right')
    return count_leq(right, target) - count_leq(left - 1, target)


if __name__ == '__main__':
    print(count_range(1, 1000, 10))
预期输出
63结果 63 来自所有不超过 1000 且数位和为 10 的整数。程序没有生成这些整数本身,而是直接累加每个状态能够形成的合法后缀数量。
看懂复杂度和适用边界
设十进制上界有 D 位,目标数位和为 T。状态数量最多约为 D × (T + 1) × 2,每个状态尝试至多 10 个数字,因此时间复杂度可写成 ,空间复杂度主要由记忆化状态决定。它与 [L, R] 实际包含多少个整数没有直接关系。
如果统计条件还依赖“是否已经出现某个数字”“前一个数字是什么”“出现次数是多少”,就把这些真正影响后续决策的信息加入状态。反过来,不影响未来的完整前缀内容不应保存,否则状态会重新膨胀成近似枚举。数位 DP 的关键不是固定背诵状态模板,而是证明:具有相同状态的所有前缀,从当前位置开始拥有完全相同的后续计数。