
数据结构与算法 / 系统课时
按区间长度组织状态计算
按区间长度组织状态计算
区间 DP 最容易写错的往往不是转移式,而是计算顺序:某个大区间依赖更短的子区间时,必须先把这些依赖算完。本文用左右端点建模,并通过最长回文子序列示例掌握区间长度、端点范围和初始化之间的关系。
学习目标
- 能用
dp[l][r]表示闭区间状态,并根据区间长度确定合法端点。 - 能解释为什么区间 DP 通常按长度从短到长计算。
- 能处理长度为 1、长度为 2 和空输入等常见边界。
用左右端点表达区间
区间 DP 通常把状态定义成“某个连续区间上的最优答案”。例如字符串 s 的最长回文子序列可以定义为:dp[l][r] 表示闭区间 [l, r] 内的最长回文子序列长度。
当 l == r 时,区间里只有一个字符,答案一定是 1,因此长度为 1 的区间是天然的初始化层。更长区间再由更短区间推出,这正是后续计算顺序的依据。
为什么要按长度递增
最长回文子序列的转移只依赖更短的区间:若两端字符相同,就查看 [l+1, r-1];若不同,就比较 [l+1, r] 和 [l, r-1]。所以在计算长度为 len 的区间前,长度小于 len 的状态必须已经得到。
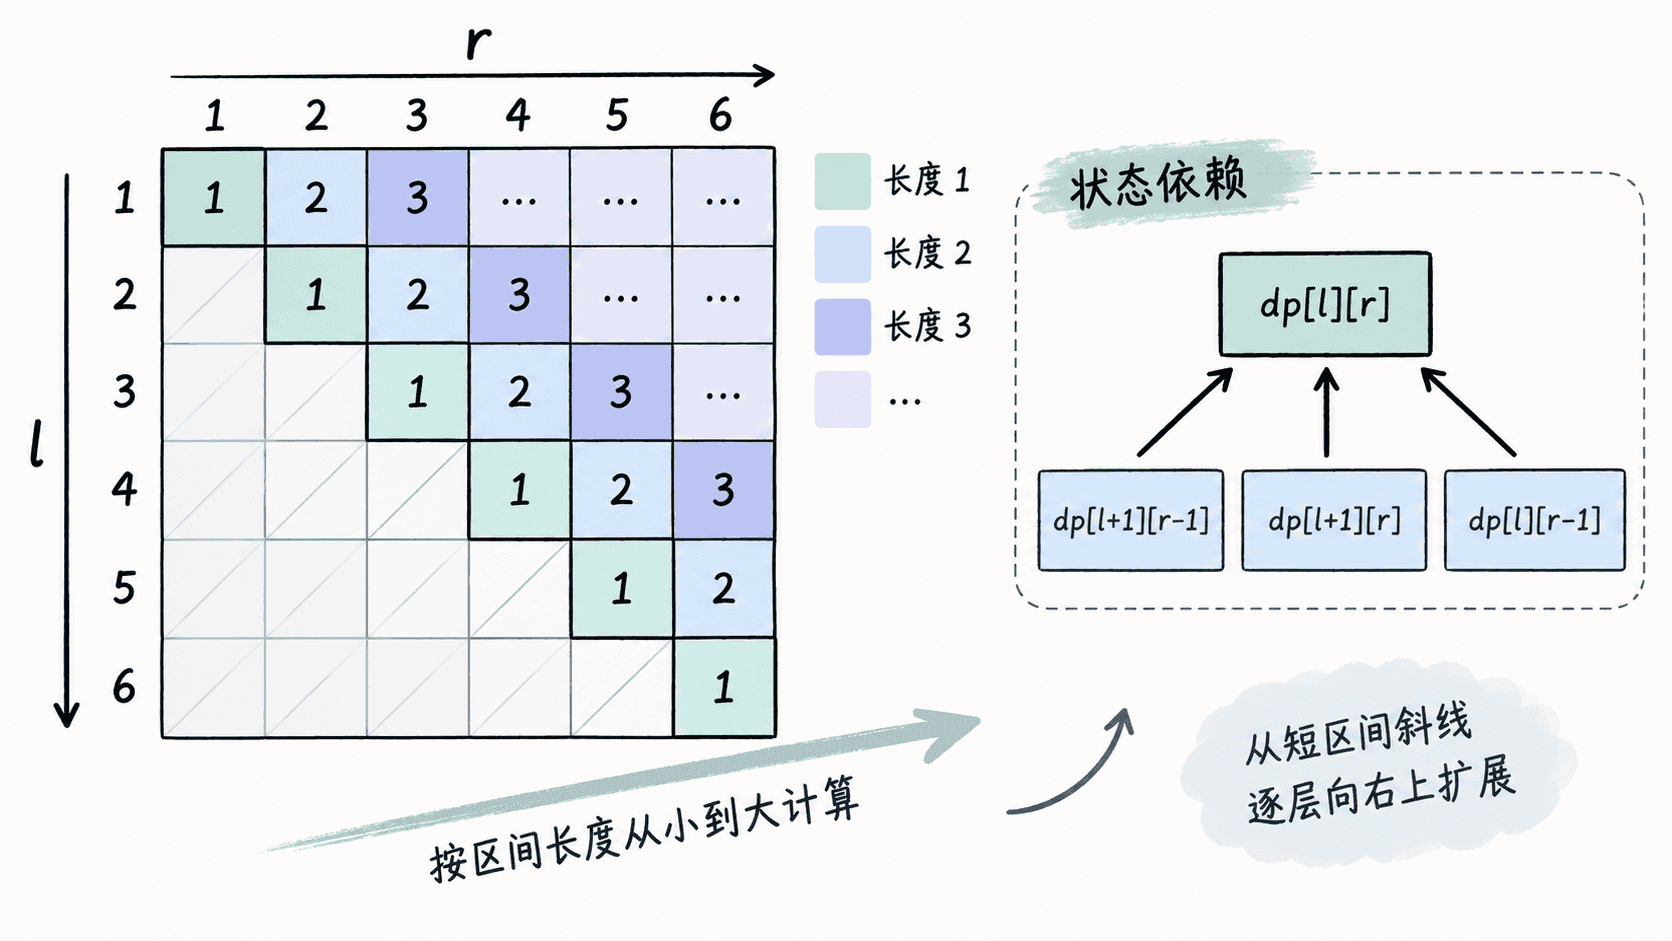
如果直接按 l 从小到大、r 从小到大填表,某些依赖可能尚未计算。按长度递增则天然形成拓扑顺序:所有转移都从已完成的短区间流向更长区间。
从长度换算左右端点
设数组或字符串长度为 n,当前区间长度为 length。左端点 l 的最大值是 n - length,右端点由下面的关系得到:
因此长度循环通常写成 2..n,左端点写成 0..n-length。这里最常见的错误是把右端点写成 l + length,导致越界或把区间实际长度扩大 1。
长度为 2 时还要特别注意 [l+1, r-1] 已经没有元素。可以单独处理,也可以设计带哨兵的状态;对初学实现而言,显式判断最清楚。
主示例:最长回文子序列
下面的 Python 程序完整实现按区间长度递增的计算顺序。输入 bbbab 时,最长回文子序列可以取 bbbb。
def longest_palindrome_subseq(s: str) -> int:
    n = len(s)
    if n == 0:
        return 0

    dp = [[0] * n for _ in range(n)]

    # 长度为 1 的区间已经是回文。
    for i in range(n):
        dp[i][i] = 1

    for length in range(2, n + 1):
        for l in range(0, n - length + 1):
            r = l + length - 1

            if s[l] == s[r]:
                # 长度为 2 时,中间区间为空,答案直接是 2。
                dp[l][r] = 2 if length == 2 else dp[l + 1][r - 1] + 2
            else:
                dp[l][r] = max(dp[l + 1][r], dp[l][r - 1])

    return dp[0][n - 1]

if __name__ == "__main__":
    print(longest_palindrome_subseq("bbbab"))
预期输出
4这个示例的关键不是回文问题本身,而是循环骨架:先枚举 length,再枚举 l,最后计算 r。只要当前转移依赖严格更短的区间,这种顺序通常都能保证依赖已就绪。
边界检查与复杂度
实现区间 DP 时,可以先检查三个边界:长度为 1 是否已初始化,长度为 2 是否会访问空区间,以及 r 是否始终小于 n。这三处通常能发现大多数下标错误。
该实现共有约 个区间,每个区间只做常数次转移,因此时间复杂度是 ,空间复杂度也是 。当问题的每个区间还要枚举分割点时,单个状态不再是常数转移,整体复杂度通常会上升到 。