
数据结构与算法 / 系统课时
用换根动态规划复用子树信息
用换根动态规划复用子树信息
当答案需要以树上的每个节点分别作为根计算时,逐个重新 DFS 会反复处理相同子树。换根动态规划通过两次遍历先汇总向下贡献,再把父侧信息传给孩子,把平方级重复计算压缩为线性遍历。
学习目标
- 理解换根动态规划中向下状态与全树状态的分工
- 推导根从父节点移动到子节点时的状态转移
- 使用两次 DFS 在线性时间内求出所有节点的答案
为什么不能为每个根重新计算
以“每个节点到树中其他节点的距离之和”为例。固定根后,一次 DFS 可以算出答案;但如果对 个节点分别执行完整 DFS,总时间会达到 ,树稍大就难以接受。
真正重复的部分是子树计算。无论最终把哪个节点当根,一棵局部子树内部的大量信息并不会完全改变。换根动态规划的核心就是先保存这些可复用结果,再计算根跨过一条边后答案如何增量变化。
两次遍历如何传递贡献
任选节点 0 作为临时根。第一次 DFS 为每个节点维护两个状态:size[u] 表示以 u 为根的子树节点数,down[u] 表示 u 到其子树全部节点的距离之和。处理孩子 v 后,有 size[u] += size[v],同时 down[u] += down[v] + size[v],因为 v 子树中的每个节点到 u 都比到 v 多一步。
第一次遍历结束后,down[0] 已经是节点 0 到整棵树的距离和。第二次 DFS 再把这个全树答案向孩子传播。若根从 u 移到它的孩子 v,v 子树中的 size[v] 个节点都近一步,而其余 n - size[v] 个节点都远一步,因此:
父节点的 ans[u] 已经包含父侧以及所有兄弟子树贡献,所以这一步不需要重新扫描那些区域。
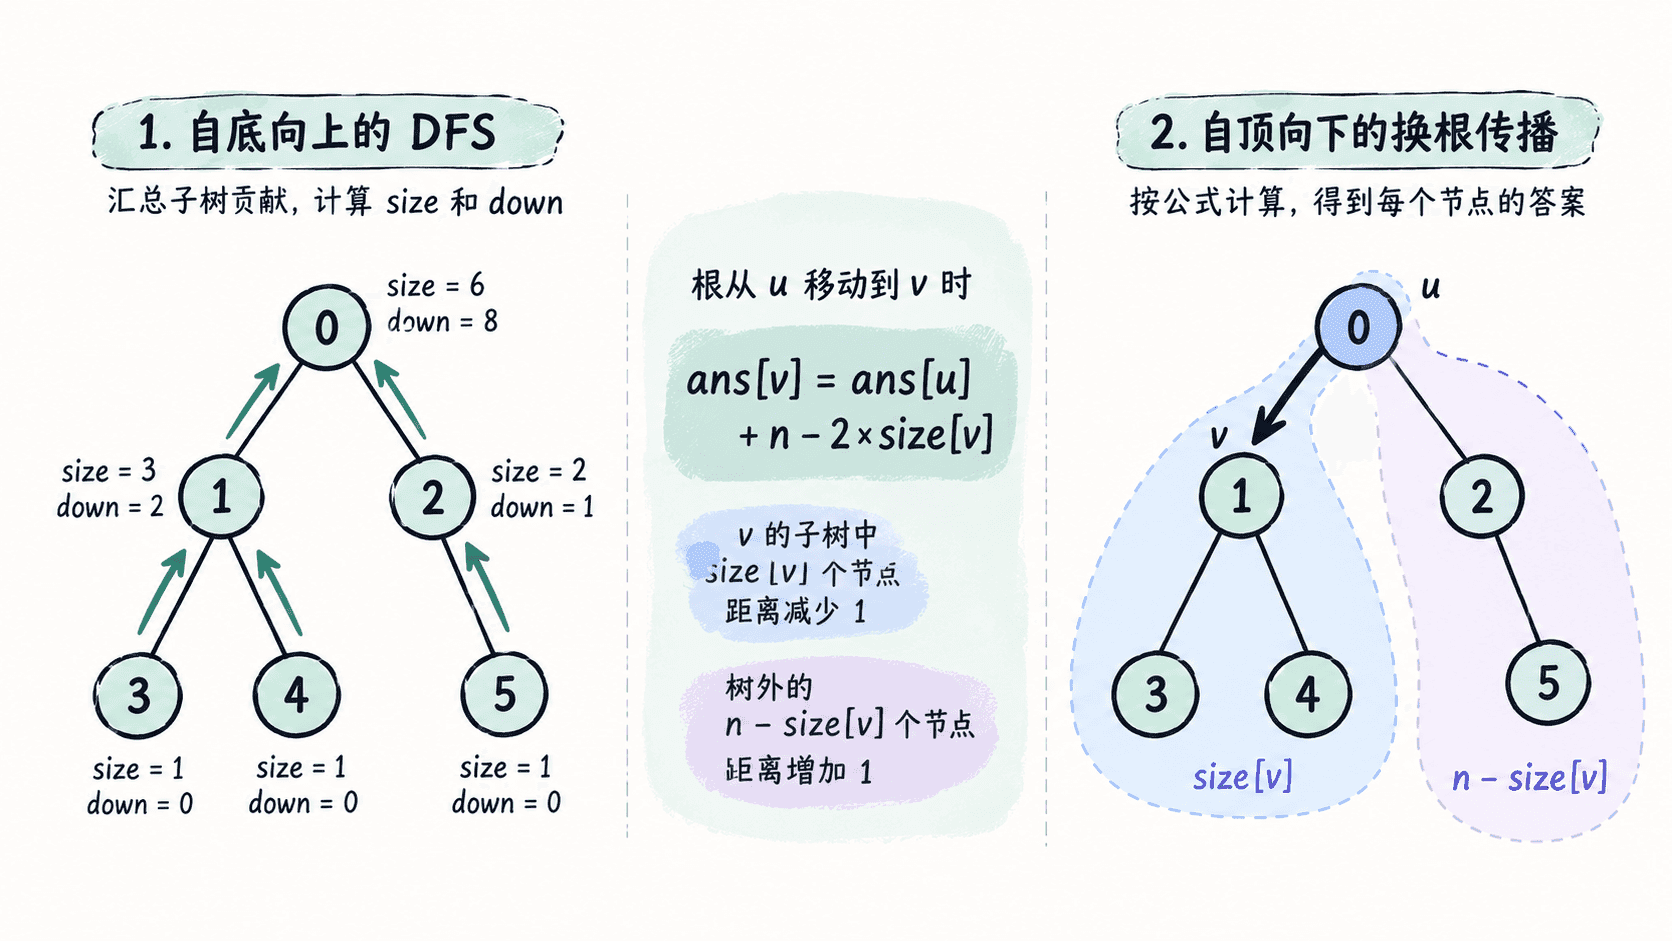
可运行示例
下面计算一棵无权树中,每个节点到其他所有节点的距离之和。两次 DFS 都只沿每条边访问常数次。
import sys

sys.setrecursionlimit(1_000_000)


def sum_of_distances(n, edges):
    graph = [[] for _ in range(n)]
    for a, b in edges:
        graph[a].append(b)
        graph[b].append(a)

    size = [1] * n
    down = [0] * n
    ans = [0] * n

    def dfs_down(u, parent):
        # 第一次遍历:汇总每棵子树的节点数与向下距离和。
        for v in graph[u]:
            if v == parent:
                continue
            dfs_down(v, u)
            size[u] += size[v]
            down[u] += down[v] + size[v]

    def dfs_reroot(u, parent):
        # 第二次遍历:利用父节点的全树答案计算孩子答案。
        for v in graph[u]:
            if v == parent:
                continue
            ans[v] = ans[u] + n - 2 * size[v]
            dfs_reroot(v, u)

    dfs_down(0, -1)
    ans[0] = down[0]
    dfs_reroot(0, -1)
    return ans


n = 6
edges = [(0, 1), (0, 2), (2, 3), (2, 4), (4, 5)]
print(sum_of_distances(n, edges))
预期输出
[9, 13, 7, 11, 9, 13]例如节点 2 到其余节点的距离依次为 1、2、1、1、2,总和为 7,与输出第三项一致。临时根选择 0 只是为了组织第一次遍历,最终所有节点的答案都被第二次遍历补齐。
正确性与复杂度
第一次 DFS 保证 size[u] 和 down[u] 完整覆盖 u 的子树;第二次 DFS 每跨过一条父子边,都精确处理“子树节点近一步、其余节点远一步”这两组变化,因此从已知的父节点答案可以得到正确的孩子答案。沿树逐层传播后,所有节点都获得对应的全树状态。
两次 DFS 都只访问每条边常数次,时间复杂度为 ;邻接表、状态数组与递归栈合计需要 空间。若边带权,只需把跨边造成的距离变化乘以该边权;若问题的状态无法在换根时通过局部增量表达,则不能直接套用这条转移公式。