
数据结构与算法 / 系统课时
用前缀结果减少重复枚举
用前缀结果减少重复枚举
当一个 DP 状态反复对一段历史状态求和、最大值或最小值时,真正浪费时间的往往不是状态数量,而是每次都重新扫描同一批历史。本篇用“每次可跳 1 到 k 步”的计数问题,演示如何用前缀和把转移从区间枚举降为常数时间查询。
学习目标
- 识别转移中的重复区间聚合
- 用前缀和把区间求和从
O(k)降到O(1) - 区分前缀和、前缀最值与更一般的区间数据结构
找到真正重复的工作
设 dp[i] 表示到达第 i 级台阶的方法数,每次可以跳 1 到 k 级。直接转移就是把前面至多 k 个状态相加,例如 dp[i] 需要读取从 dp[max(0, i-k)] 到 dp[i-1] 的全部值。
如果共有 n 个状态,每个状态都向前枚举最多 k 项,总复杂度是 O(nk)。相邻两个状态查询的区间高度重叠,只是在窗口两端各增减一个元素,这正是可以复用历史聚合结果的信号。
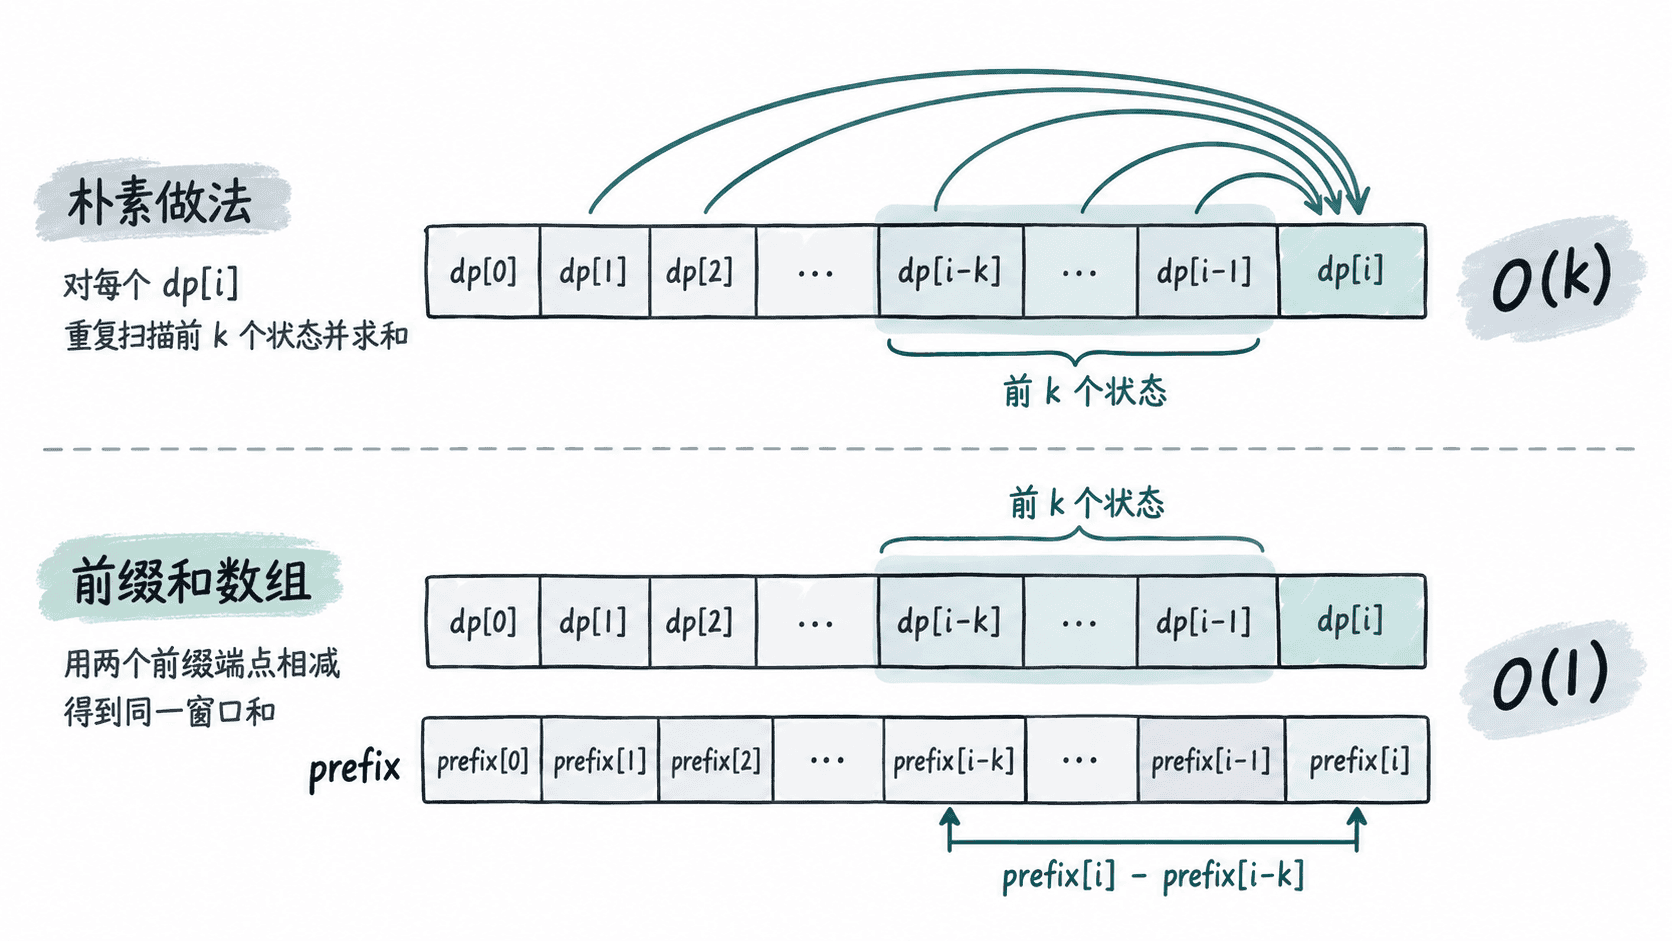
用前缀和改写转移
定义 prefix[i] 为 dp[0] 到 dp[i] 的总和。于是区间 dp[left] 到 dp[i - 1] 的和,可以用 prefix[i - 1] 减去 left 之前的前缀结果得到,不再逐项遍历。
下面同时实现朴素版和前缀和版,并验证两种算法的结果一致。
def count_ways_slow(n, k):
    dp = [0] * (n + 1)
    dp[0] = 1

    for i in range(1, n + 1):
        left = max(0, i - k)
        dp[i] = sum(dp[left:i])

    return dp[n]


def count_ways_prefix(n, k):
    dp = [0] * (n + 1)
    prefix = [0] * (n + 1)
    dp[0] = 1
    prefix[0] = 1

    for i in range(1, n + 1):
        left = max(0, i - k)
        before_left = prefix[left - 1] if left > 0 else 0
        # 窗口和由两个前缀结果相减得到。
        dp[i] = prefix[i - 1] - before_left
        prefix[i] = prefix[i - 1] + dp[i]

    return dp[n]


n = 6
k = 3

slow = count_ways_slow(n, k)
fast = count_ways_prefix(n, k)

assert slow == fast
print(f'slow={slow}')
print(f'prefix={fast}')
预期输出
slow=24
prefix=24
朴素版需要 O(nk) 时间;前缀和版仍然维护 n + 1 个 DP 状态,但每次转移只做常数次读取和减法,因此时间降为 O(n)。这里额外维护了一份前缀数组,所以空间仍为 O(n)。
前缀技巧不只适用于求和
如果转移需要反复查询从开头到当前位置的最大值,例如不断计算某个历史前缀中的 max,可以维护前缀最大值;最小值同理。它们的共同点是,新状态只需在旧聚合结果上加入一个元素。
但任意区间最大值不能像区间和那样用两个前缀最大值相减。固定长度或滑动窗口最值更适合单调队列,静态区间查询可以考虑稀疏表,存在动态修改时则需要更合适的数据结构。
判断是否值得引入辅助结果
前缀结构会增加一份维护逻辑,因此只在重复枚举确实成为复杂度瓶颈时使用。若 k 很小且固定,朴素转移可能已经足够简单;若 k 接近 n,前缀和通常能把明显的平方级过程降到线性级。
真正的优化思路是把“每个状态重新算一遍历史”改成“历史结果增量维护一次,后续重复使用”。只要先识别出转移中的重复区间查询,很多看似不同的 DP 优化都可以归结到这一点。