
编码与格式 / 系统课时
延迟分析与优化
延迟分析与优化
本课解决“画面能播放,但总是慢半拍”的问题。你将把端到端延迟拆成可测量的阶段,识别编码、网络和播放器缓冲中的主要等待,并搭建一条可验证的低延迟本机推流与播放链路。
学习目标
- 建立端到端延迟预算并定位主要耗时阶段
- 理解 GOP、B 帧、抖动缓冲和渲染同步对延迟的影响
- 使用 FFmpeg 与 ffplay 验证低延迟参数的实际效果
先建立延迟预算
端到端延迟不是一个单独参数,而是多个阶段之和:
采集延迟来自摄像头曝光、驱动队列和帧率;编码延迟来自帧重排、前视分析和码率控制;传输延迟受排队、拥塞和重传影响;播放端通常还会增加探测、抖动缓冲、解码队列与垂直同步等待。
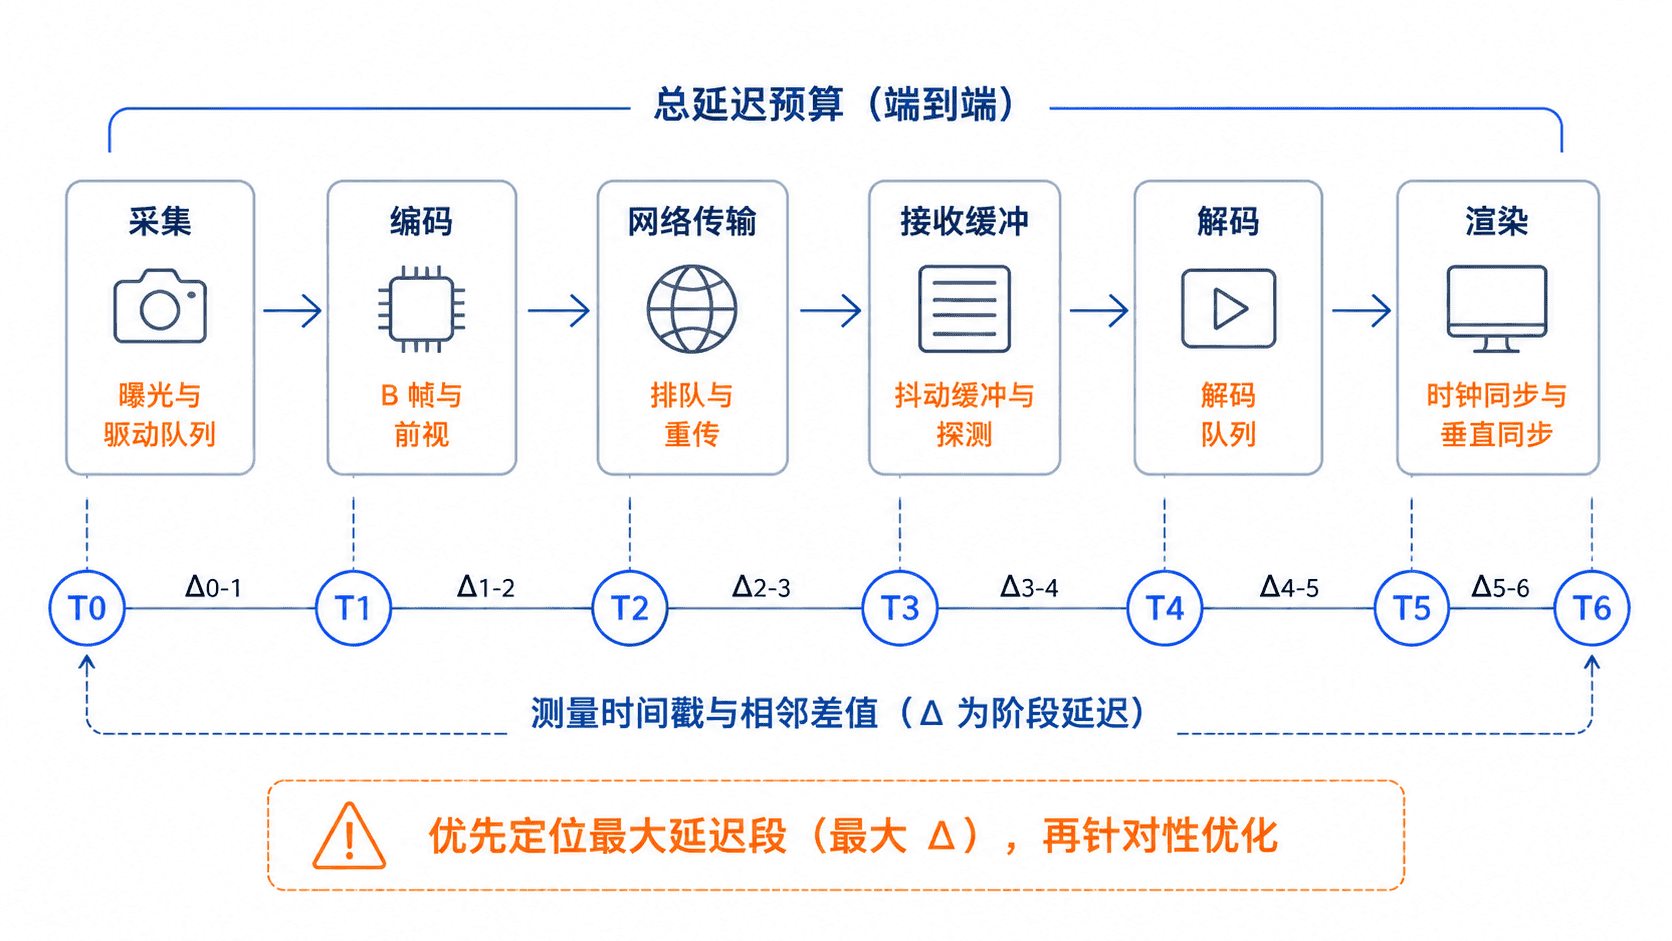
按阶段定位而不是盲目调参
| 阶段 | 重点指标 | 常见根因 |
|---|---|---|
| 采集 | 帧到达间隔、驱动队列深度 | 摄像头缓存、低帧率、曝光时间过长 |
| 编码 | 单帧耗时、重排帧数 | B 帧、lookahead、复杂预设、超长 GOP |
| 传输 | RTT、抖动、丢包、发送队列 | 带宽不足、拥塞、可靠重传阻塞 |
| 缓冲 | 首帧等待、队列时长 | 探测数据过大、播放器默认缓存过长 |
| 解码与渲染 | 解码耗时、待显示帧数 | 解码排队、音画同步、垂直同步等待 |
只看平均延迟会掩盖卡顿。线上应同时记录 P50、P95 和 P99,并区分“稳定但偏大”与“偶发尖峰”。前者通常是固定缓冲,后者更可能来自网络抖动、GC、线程抢占或设备队列。
搭建低延迟本机链路
下面以 Linux 摄像头 /dev/video0 为例。先在终端一启动发送端,使用 H.264 零延迟调优、关闭 B 帧,并把 GOP 固定为 1 秒。
ffmpeg -f v4l2 -framerate 30 -video_size 1280x720 \
  -i /dev/video0 \
  -c:v libx264 -preset ultrafast -tune zerolatency \
  -g 30 -keyint_min 30 -sc_threshold 0 -bf 0 \
  -pix_fmt yuv420p \
  -f mpegts "udp://127.0.0.1:5000?pkt_size=1316"
预期输出会持续显示已编码帧数,处理速度应接近 1x。设备名、帧率和实际速度可能不同。
frame=<N> fps=<FPS> time=<TIME> bitrate=<RATE> speed=<X>x再在终端二启动接收端,减少格式探测和播放器缓存。UDP 地址必须整体加引号,避免 & 被 Shell 解释。
ffplay -fflags nobuffer -flags low_delay -framedrop \
  -probesize 32768 -analyzeduration 100000 \
  "udp://127.0.0.1:5000?fifo_size=1000000&overrun_nonfatal=1"
预期结果是播放器窗口快速出现摄像头画面,并在网络或解码跟不上时主动丢弃迟到帧,而不是持续累积延迟。
Input #0, mpegts, from 'udp://127.0.0.1:5000?...':
  Stream #0:0: Video: h264, yuv420p, 1280x720, 30 fps
ultrafast 和 zerolatency 用编码效率换取更少等待;-bf 0 取消帧重排;较小的 probesize 与 analyzeduration 缩短首帧前探测;nobuffer 和 framedrop 防止播放队列越积越长。它们不保证最低画质损失,也不适合所有弱网场景。
优化顺序与边界
先减小最大等待段,再处理次要开销。采集端应缩短驱动队列并使用稳定帧率;编码端优先关闭 B 帧和前视,再评估硬件编码;传输端根据业务选择 UDP、SRT、WebRTC 或低延迟 HLS,不能只追求“绝不丢包”。
缓冲不是越小越好。抖动缓冲过小会把网络波动直接变成卡顿,过大则使延迟稳定上升。应根据实际抖动分布设置目标值,并允许播放器在落后时丢帧追赶实时点。
GOP 过长会增加随机接入和丢包恢复时间,过短则提高码率。实时互动常以 0.5~2 秒为起点,再结合带宽和关键帧请求机制调整。
如何做可信测量
最直观的方法是在信号源上显示毫秒时钟,同时拍到源画面和播放屏幕,再计算两者时间差,这能覆盖采集到显示的完整 glass-to-glass 延迟。
工程内部还应在采集、编码完成、发送、接收、解码完成和提交渲染时记录单调时钟。跨机器测量前必须校准时钟;仅用 RTT 除以二估算单向网络延迟,在链路不对称时并不可靠。