
编码与格式 / 系统课时
缓冲区与内存复用
缓冲区与内存复用
音视频帧体积大、频率高,若每一帧都重新分配内存并在模块间复制,容易引发抖动、缓存失效和峰值内存上涨。本课将用缓冲区池复用固定容量内存,并说明如何控制所有权、减少复制和限制缓存规模。
学习目标
- 能识别频繁分配和重复复制的主要成本
- 能实现一个可回收的固定大小缓冲区池
- 能为大帧、变长帧和跨线程传递设置边界
先区分三类成本
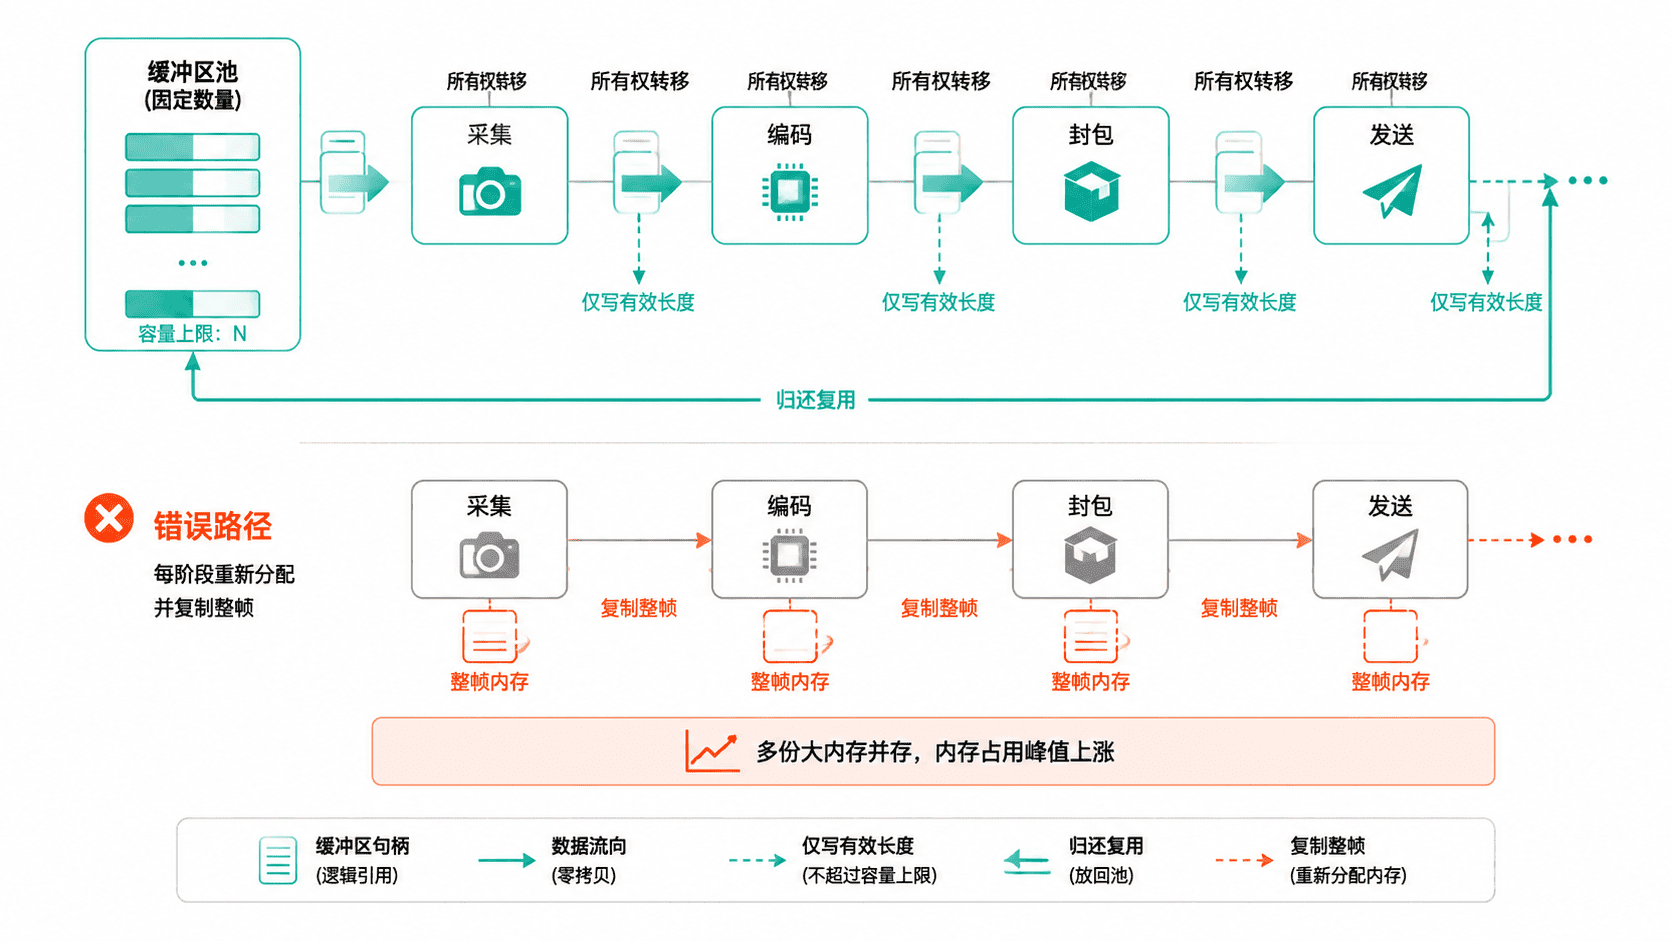
第一类是分配成本。高频调用 new、malloc 或容器扩容会进入内存分配器,并可能触发锁竞争和碎片化。第二类是复制成本,同一帧在采集、编码、封包和发送阶段反复复制,会占用大量内存带宽。第三类是缓存成本,队列中保留过多大帧会直接抬高峰值内存。
优化的核心不是“永远不分配”,而是把分配次数从“每帧一次”降为“初始化或扩容时少量发生”,并让缓冲区所有权在阶段间转移。只有确实需要改变布局或格式时才复制数据。
实现一个最小缓冲区池
下面的 C++17 示例预分配两个 1024 字节缓冲区。调用方通过 acquire 取得独占缓冲区,处理完成后由自定义删除器自动归还,避免忘记释放。
#include <cstddef>
#include <iostream>
#include <memory>
#include <mutex>
#include <stdexcept>
#include <vector>

class BufferPool {
public:
    struct Buffer {
        explicit Buffer(std::size_t capacity) : data(capacity), size(0) {}
        std::vector<unsigned char> data;
        std::size_t size;
    };

    BufferPool(std::size_t count, std::size_t capacity)
        : capacity_(capacity) {
        for (std::size_t i = 0; i < count; ++i) {
            free_.push_back(std::make_unique<Buffer>(capacity_));
        }
    }

    using Handle = std::shared_ptr<Buffer>;

    Handle acquire() {
        std::lock_guard<std::mutex> lock(mutex_);
        if (free_.empty()) {
            throw std::runtime_error("buffer pool exhausted");
        }

        Buffer* buffer = free_.back().release();
        free_.pop_back();
        buffer->size = 0;

        // 自定义删除器把缓冲区归还到池,而不是释放底层内存。
        return Handle(buffer, [this](Buffer* value) { release(value); });
    }

    std::size_t available() const {
        std::lock_guard<std::mutex> lock(mutex_);
        return free_.size();
    }

private:
    void release(Buffer* buffer) {
        std::lock_guard<std::mutex> lock(mutex_);
        free_.push_back(std::unique_ptr<Buffer>(buffer));
    }

    std::size_t capacity_;
    mutable std::mutex mutex_;
    std::vector<std::unique_ptr<Buffer>> free_;
};

int main() {
    BufferPool pool(2, 1024);

    for (int frame = 1; frame <= 5; ++frame) {
        auto buffer = pool.acquire();
        buffer->data[0] = static_cast<unsigned char>(frame);
        buffer->size = 1;
    }

    std::cout << "preallocated=2 available=" << pool.available() << '\n';
}
编译并运行:
g++ -std=c++17 main.cpp -o buffer_pool
./buffer_pool
预期输出:
preallocated=2 available=2示例展示的是复用原则,不是完整生产实现。自定义删除器把缓冲区归还到原池,因此调用方不需要手动执行回收。池对象必须比所有借出的句柄存活得更久;跨线程长期持有时,可把池状态放进 shared_ptr 以避免悬空引用。关键结果是五次处理只使用初始化时创建的两个缓冲区,循环结束后它们都回到池中。
减少复制的所有权设计
跨线程传递时,队列中应保存缓冲区句柄,而不是保存整块字节数组。生产者填充 data 并记录有效长度 size,随后把句柄移动给消费者;消费者完成后归还池。这样传递的是少量元数据,不是整帧内容。
零复制并不意味着任何场景都不复制。像素格式转换、音频重采样、加密封装和要求连续内存的系统调用,可能必须生成新布局。此时应把复制集中在明确边界,并避免同一阶段重复转换。
控制容量与大帧策略
缓冲区池必须有上限。池耗尽时可等待、丢帧或临时扩容,但要为每种策略设置最大等待时间和扩容上限。无限扩容只是把队列堆积换成内存堆积。
固定容量适合尺寸稳定的 PCM、YUV 或网络包。面对分辨率切换和变长压缩帧,可按小、中、大几个容量档位建立分级池;超大帧单独分配并在使用后释放,避免把偶发峰值永久固化到整个池中。
还应记录池命中率、临时分配次数、等待时间和最大在用数量。若大多数请求落入超大档位,说明容量分级不合理;若池长期空闲,则可能预分配过多。