
编码与格式 / 系统课时
PCM 数据布局
PCM 数据布局
本课把 PCM 的“一个样本、一个采样时刻和一帧数据”分开说明,并用双声道示意图与可运行代码对比交错存储和平面存储。完成后,你可以根据采样格式、声道数与样本数计算内存大小,并正确读取常见音频缓冲区。
学习目标
- 区分单个样本、采样帧与批量音频帧
- 识别交错存储和平面存储的内存顺序
- 根据样本格式计算 PCM 缓冲区字节数
先统一三个基本单位
PCM 样本是某个声道在某个采样时刻的数值,例如左声道的 L0。采样帧是同一时刻所有声道样本的集合,立体声的一帧由 L0 和 R0 组成。音频 API 中的一个数据帧通常又包含多个采样帧,因此必须结合 nb_samples 或缓冲区长度判断。
若每个声道包含 N 个样本,声道数为 C,每个样本占 B 字节,则整块 PCM 数据大小为 。这个公式对交错和平面布局都成立,区别只在字节排列方式。
交错与平面布局
交错存储把同一采样时刻的各声道样本放在一起。双声道顺序为 L0, R0, L1, R1...,常见格式名如 s16、flt。平面存储为每个声道分配独立平面,顺序可理解为左声道平面 L0, L1... 与右声道平面 R0, R1...,FFmpeg 中常以 p 后缀标识,例如 s16p、fltp。
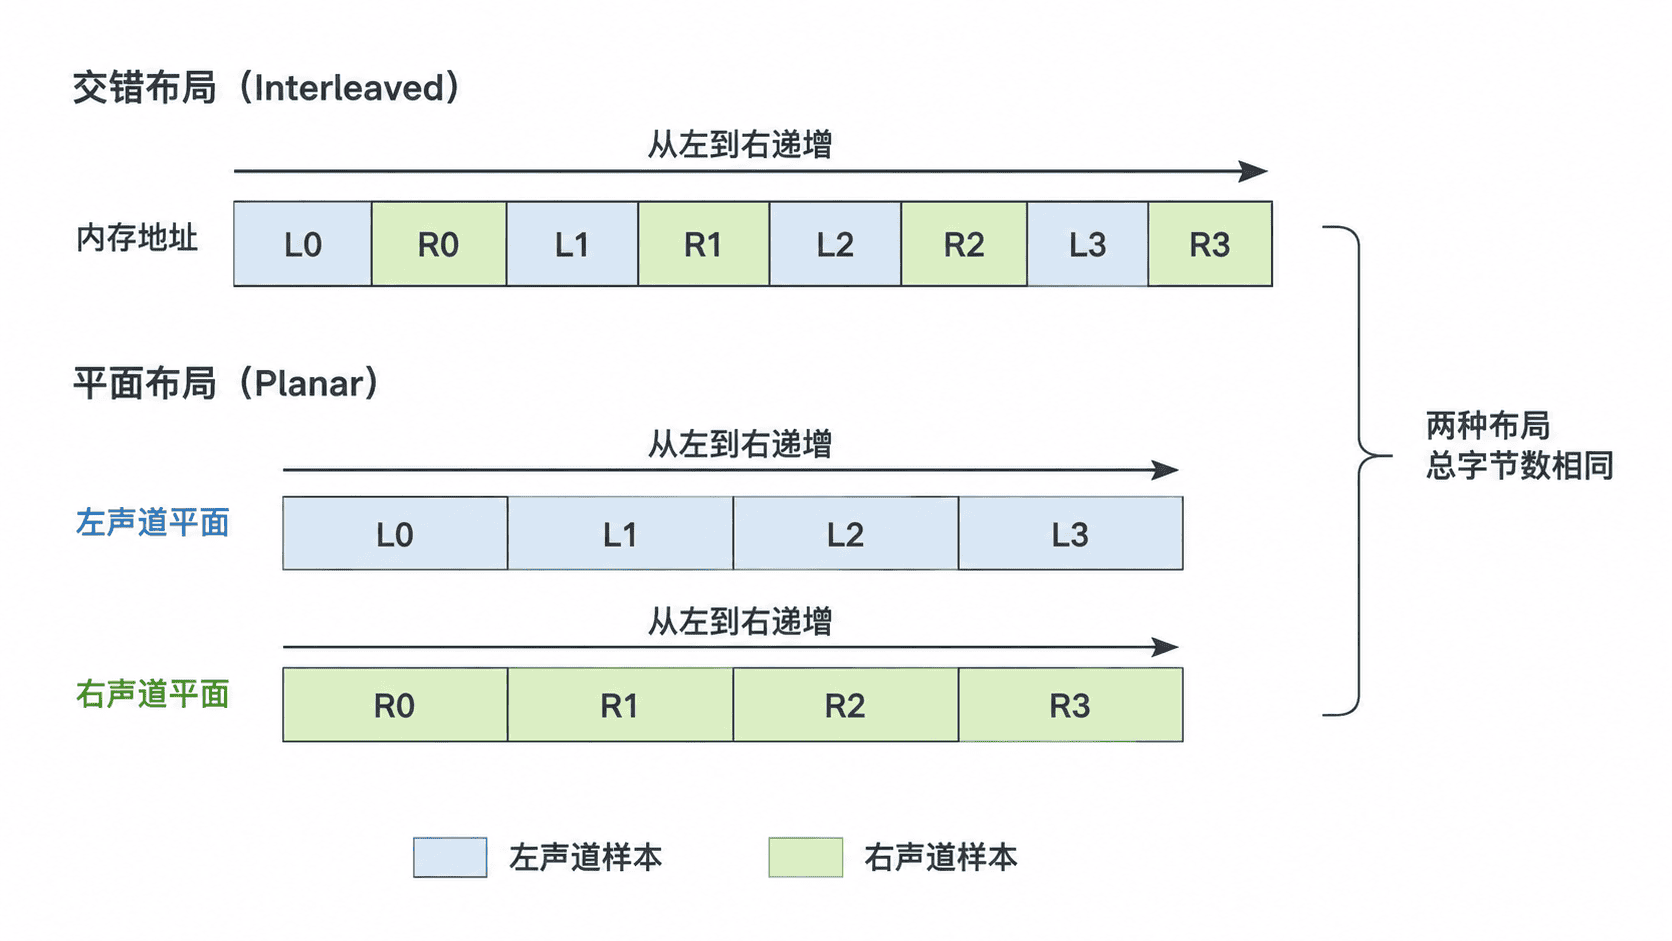
交错布局适合按时间顺序逐帧处理,也常见于音频设备和文件接口。平面布局便于对单个声道做增益、滤波或向量化运算,但调用库函数时必须传入各声道平面的地址,不能把第一个平面误当成完整多声道数据。
样本格式决定数值与字节数
常见 PCM 格式如下。带 p 后缀只改变布局,不改变单个样本的数值类型与字节数。
| 格式 | 每样本字节数 | 典型数值范围 | 布局 |
|---|---|---|---|
u8 |
1 | 0~255 | 交错 |
s16 / s16p |
2 | -32768~32767 | 交错 / 平面 |
s32 / s32p |
4 | 32 位有符号整数 | 交错 / 平面 |
flt / fltp |
4 | 通常归一化到 -1.0~1.0 | 交错 / 平面 |
dbl / dblp |
8 | 双精度浮点数 | 交错 / 平面 |
位深与容器占用不总是完全相同。例如 24 位有效音频可能使用 3 字节紧凑存储,也可能放在 4 字节整数容器中。计算前应以 API 返回的样本格式为准,而不是只看“24-bit”描述。
用代码验证排列和大小
下面以双声道、每声道 4 个 s16 样本为例。代码同时生成交错顺序、平面顺序,并计算整块数据占用。
channels = 2
samples_per_channel = 4
bytes_per_sample = 2

left = [1000, 2000, 3000, 4000]
right = [-1000, -2000, -3000, -4000]

# 交错布局按采样时刻拼接左右声道
interleaved = [sample for pair in zip(left, right) for sample in pair]
planar = [left, right]

total_bytes = samples_per_channel * channels * bytes_per_sample

print("interleaved:", interleaved)
print("planar:", planar)
print("total_bytes:", total_bytes)
预期输出
interleaved: [1000, -1000, 2000, -2000, 3000, -3000, 4000, -4000]
planar: [[1000, 2000, 3000, 4000], [-1000, -2000, -3000, -4000]]
total_bytes: 16
对交错数据,第 i 个采样帧的起始样本索引为 i × C。对平面数据,第 c 个声道的第 i 个样本位于第 c 个平面的索引 i。两者总数据量相同,但寻址方式不同。
边界与易错点
不要把采样率直接代入单帧大小。采样率表示每秒每个声道产生多少样本;只有计算时长为 T 秒的数据量时,才使用 sample_rate × T × C × B。例如 48 kHz、双声道、s16 的一秒原始数据为 48000 × 2 × 2 = 192000 字节。
读取平面格式时还要注意行跨度或对齐。某些库会让每个平面的实际分配长度大于有效样本字节数,因此复制数据时应优先使用库提供的有效样本数、每样本字节数和行大小,而不是假设内存完全紧密排列。