
编码与格式 / 系统课时
媒体压缩基础
媒体压缩基础
本课解释音视频为什么能够被大幅压缩,以及编码器分别怎样利用空间冗余、时间冗余和感知冗余。学完后,你能看懂压缩链路中的关键取舍,并用数据估算原始媒体与压缩媒体的体积差异。
学习目标
- 区分空间冗余、时间冗余和感知冗余
- 理解预测、变换、量化与熵编码的基本分工
- 计算原始视频数据量、码率文件大小和压缩比
为什么原始媒体很大
以 1920×1080、RGB24、30 fps 视频为例,每个像素需要 3 字节。未压缩视频每秒的数据量为 宽度 × 高度 × 每像素字节数 × 帧率,约为 178 MiB;十秒就接近 1.74 GiB,因此传输和存储通常必须依赖压缩。
压缩并不是简单删除任意数据,而是寻找重复信息和不敏感信息,用更短的表示方式重建可接受的声音或画面。无损压缩要求完全恢复原数据,有损压缩允许引入受控误差,以换取更高压缩率。
三类冗余
空间冗余存在于同一帧内部。相邻像素往往颜色接近,编码器不必反复记录每个绝对值,可以预测当前区域,再编码预测误差。纯色背景、渐变区域和重复纹理通常具有明显空间相关性。
时间冗余存在于连续帧之间。镜头中多数区域只发生位移或轻微变化,编码器可引用前后帧,通过运动向量和残差描述变化,而不必重复保存整张图像。
感知冗余来自人眼和人耳的敏感度差异。例如,人眼通常对亮度细节比色度细节更敏感,音频中强声也可能掩蔽附近的弱声。编码器会在较不敏感的信息上使用更粗的表示,但过度量化会产生块效应、振铃或声音失真。
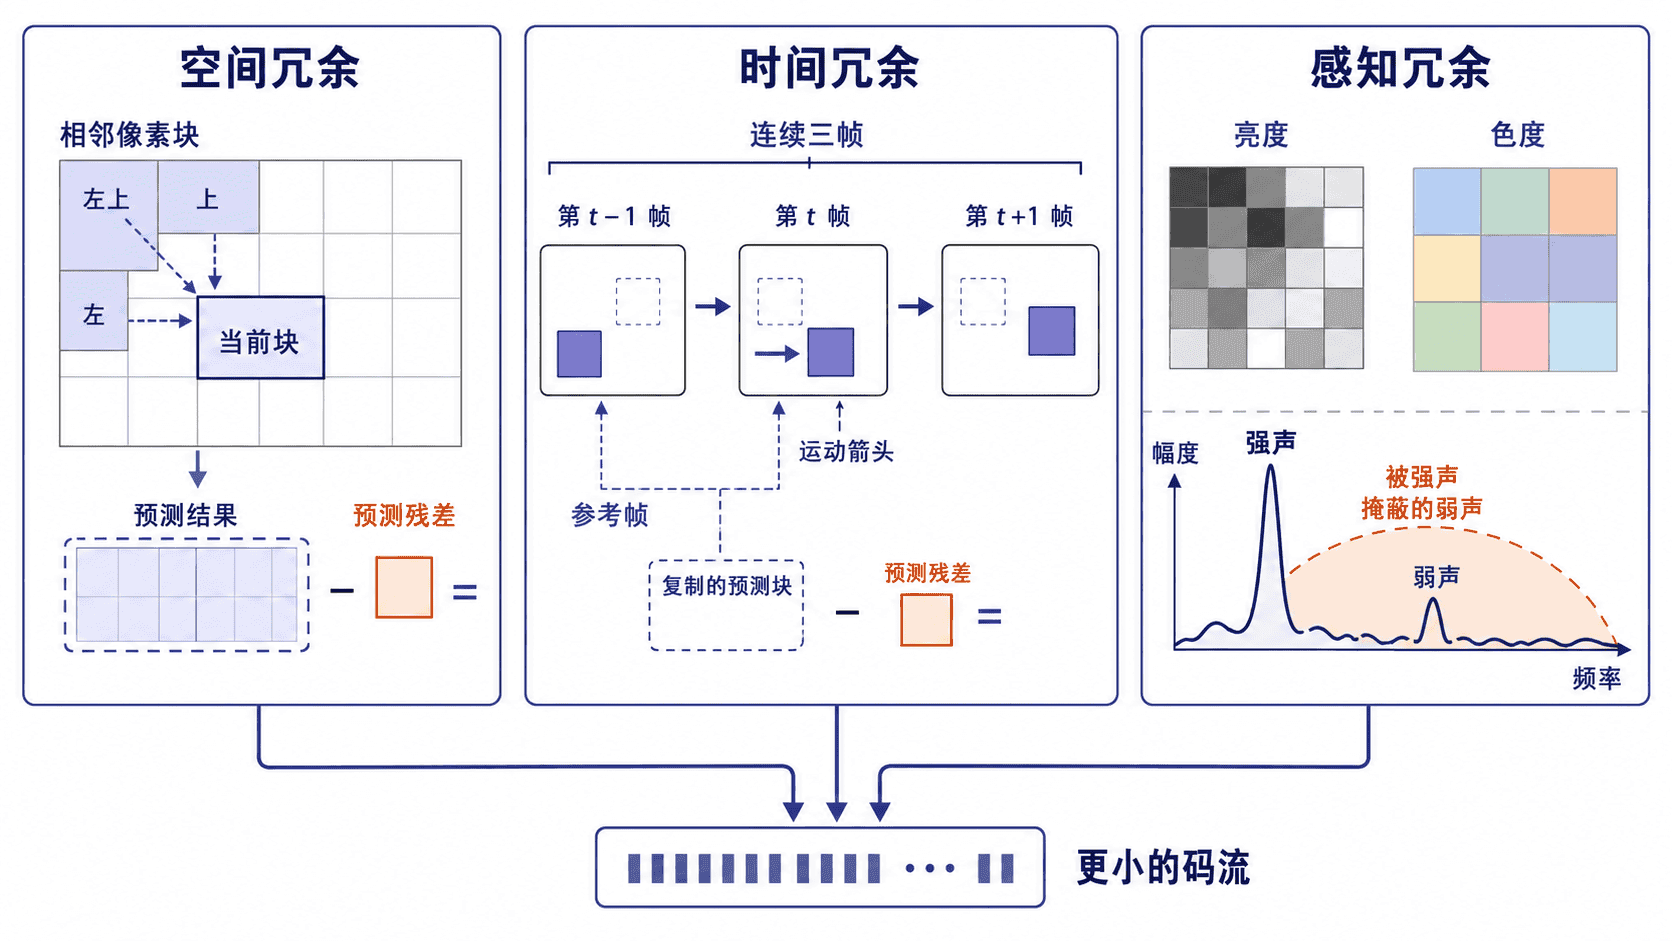
编码器如何完成压缩
典型有损编码链路包含预测、变换、量化和熵编码。预测先消除可推测的空间或时间信息;变换把残差从像素或采样域转换为更便于集中的系数;量化降低系数精度,是主要的有损环节;熵编码再用变长方式无损压缩符号。
解码器执行大致相反的过程,但量化丢失的精度无法恢复。因此,码率越低并不必然越好:它通常意味着更小文件、更低带宽,也可能意味着更多失真和更高编码复杂度。
计算数据量与压缩比
下面的 Python 程序比较十秒原始 RGB24 视频与 8 Mbit/s 压缩视频。这里按 1 MiB = 1024 × 1024 字节计算,压缩比定义为原始大小除以压缩后大小。
WIDTH = 1920
HEIGHT = 1080
BYTES_PER_PIXEL = 3
FPS = 30
DURATION_SECONDS = 10
BITRATE_BPS = 8_000_000

raw_bytes = (
    WIDTH
    * HEIGHT
    * BYTES_PER_PIXEL
    * FPS
    * DURATION_SECONDS
)
compressed_bytes = BITRATE_BPS * DURATION_SECONDS / 8
compression_ratio = raw_bytes / compressed_bytes

print(f"Raw size: {raw_bytes / 1024 / 1024:.2f} MiB")
print(f"Compressed size: {compressed_bytes / 1024 / 1024:.2f} MiB")
print(f"Compression ratio: {compression_ratio:.2f}x")
预期输出:
Raw size: 1779.79 MiB
Compressed size: 9.54 MiB
Compression ratio: 186.62x
该结果只比较理论数据量,不代表画质一定满足要求。真实文件还受容器开销、可变码率、音频轨道、编码参数和画面复杂度影响。
选择压缩参数时的边界
提高压缩率通常需要降低码率、提高量化强度或利用更复杂的预测。静态画面较容易压缩,快速运动、噪点、雨雪和细密纹理更难压缩;相同码率下,这些内容更容易出现细节损失。
评估压缩结果时,应同时检查文件大小、平均与峰值码率、编码耗时、解码兼容性和主观质量。只比较扩展名或文件大小,无法判断编码是否合理。